登录社区云,与社区用户共同成长
邀请您加入社区
品类是指产品的分类,大型电商网站品类分多级,一般为三级分类,此次项目中品类只有一级。不同的公司对热门的定义不一样。此次按照每个品类的点击---->下单---->支付的量来统计热门品类。先按照点击数排名,数量决定排名;点击数相同,比较下单数;下单数相同,比较支付数。...
Flink Exception in thread "main" java.lang.IllegalStateException: No operators defined in streaming topology. Cannot execute.
scala-tools 打包出错问题
前言:突发奇想,将SpringBoot、spark、scala结合起来然后打成一个jar包,将jar包用spark目录一、使用方式二、代码结构application.ymlSparkConfig(java)collect(java)Service(scala)一、使用方式github地址:https://github.com/sgr-china/SpringSpark.git将项目克隆下来后,把自
写在前面本文主要介绍了spinal HDL的组件、层次结构和区域。组件和层次结构(Component and hierarchy)就像在 VHDL 和 Verilog 中一样,可以定义可用于构建设计层次结构的组件。但是,在 SpinalHDL 中,不需要在实例化时绑定它们的端口:class AdderCell extends Component {// Declaring external por
build.sbtcannot resolve symbol的解决办法1. 背景2. 报错3. 解决方案1. 背景IDEA 版本2017.2,开发语言Scala,在重新导入SBT项目的时候,build.sbt 爆红,cannot resolve symbol2. 报错如下图3. 解决方案3.1删除.idea文件夹3.2 使用File->InvalidateCaches/Restart重启3.
一,运行命令bin/spark-submit \--master yarn \--deploy-mode cluster \--class org.apache.spark.examples.SparkPi \examples/jars/spark-examples_2.11-2.3.1.3.0.1.0-187.jar二,启动脚本查看spark-submit 脚本文件,程序入口为exec "${S
spark on k8s 跟 spark operator的对比对于目前基于k8s的的spark应用,主要采用两种方式运行spark原生支持的 spark on k8s基于k8s的operator的 spark on k8s operator前者是spark社区支持k8s这种资源管理框架而引入的k8s client的实现后者是k8s社区为了支持spark而开发的一种operator区别spark
设计模式、泛型、上下界、视图界定、上下文界定、协变逆变不变
1.官方网站下载spark 1.5.0的源码2.根据官方编译即可。export MAVEN_OPTS="-Xmx2g -XX:MaxPermSize=512M -XX:ReservedCodeCacheSize=512m" build/mvn -Pyarn -Phadoop-2.6 -Dhadoop.version=2.6.0 -DskipTests clean package...
版本:spak2.3相关源码:org.apache.spark.SparkContext在创建spark任务时候,往往会指定一些依赖文件,通常我们可以在spark-submit脚本使用--files /path/to/file指定来实现。但是公司产品的架构是通过livy来调spark任务,livy的实现其实是对spark-submit的一个包装,所以如何指定依赖文件归根...
使用Intellij IDEA 运行程序的时候。出现以下错误提示:上面是说wordCount已经被定义了,但是明明只有一个wordCount,仍然会报错,后面在网上搜了以下。发现原来是我在创建测试工程的时候,在创建文件夹test和scala时,都把它们Sources以下,把这两个文件夹的source属性去掉,就不会有上述问题了。在Interllij IDEA中 File->P
策略模式/*** 策略模式:* 1.scala 实现策略模式很简单 用函数定义策略* 2.定义一个类接收函数** @author Yyyyy* @version 1.0***//*** 操作数据的环境类(收银员)** @param discount* @param originalPrice*/class Cas...
sbt下载相关依赖时报以下错误::: problems summary :::::: WARNINGSmodule not found: org.scala-sbt#sbt;0.13.11:::: ERRORSServer access Error: sun.security.validator.ValidatorException:PKIX ...
Perl正则表达式摘要(150字) Perl正则表达式是文本处理的强大工具,主要通过运算符和模式语法实现字符串操作。核心功能包括:匹配(=~ m//)、替换(s///)和分割(split)。模式匹配使用元字符(如\d匹配数字,\w匹配单词字符)和量词(如*匹配0次以上,+匹配1次以上)。分组功能(())可捕获匹配内容存入$1、$2等变量。修饰符如/i(忽略大小写)、/g(全局匹配)能改变匹配行为。
运放的本质功能:
(1)⼀个类只能集成⼀个抽象类,但是可以通过with关键字继承多个特质;(2)抽象类有带参数的构造函数,特质不⾏(如 trait t(i:Int){} ,这种声明是错误的)在Java中,null是⼀个关键字,不是⼀个对象,当开发者希望返回⼀个空对象时,却返回了⼀个关键字,为了解决这个问题,Scala建议开发者返回值是空值时,使⽤Option类型,在Scala中null是Null的唯⼀对象,会引起异
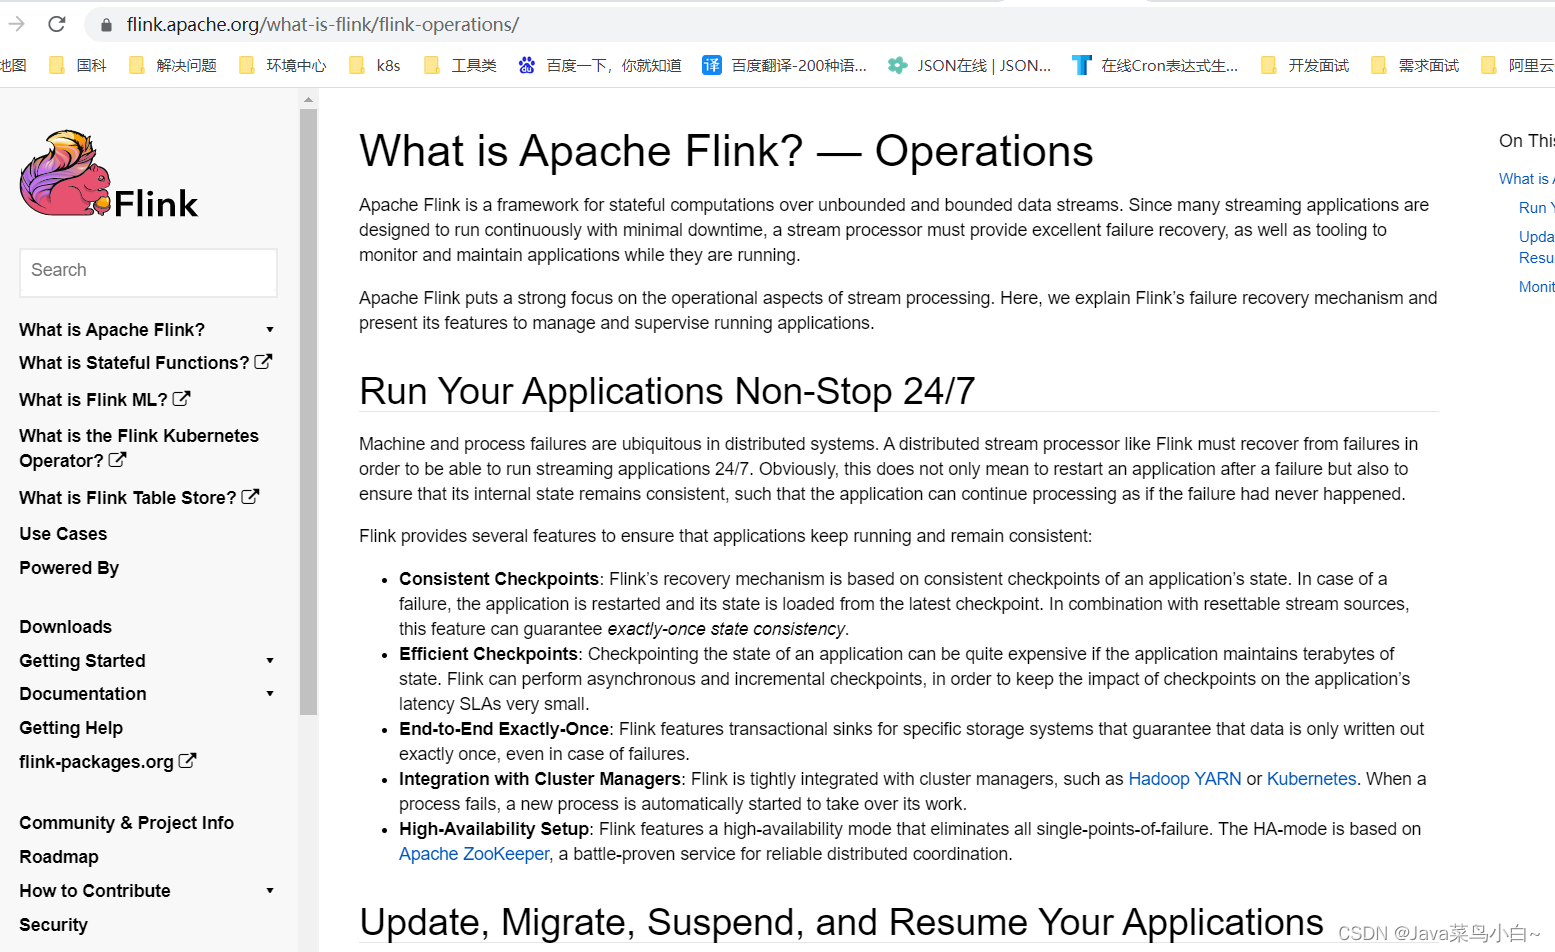
Flink官网:Operations | Apache FlinkFlink和Kafka对应关系访问Maven仓库:https://mvnrepository.com/ 查询flink-connector-kafka 本文flink使用版本为:flink-1.15.4-bin-scala_2.12.tgz 所以对应Kafka版本为: 本文使用版本为:Flink下载地址(全量版本均可下载:Downl
目录1 安装Flink2 快速入门2.1 集成Flink概述2.2 环境准备2.3 创建表2.4 插入数据2.5 查询数据2.6 更新数据3 Streaming query3.1 创建表3.2 查询数据3.3 插入数据4 Flink SQL Writer4.1 Flink SQL集成Kafka4.2 Flink SQL写入Hudi4.2.1 创建Maven Module4.2.2 消费Kafka数
【代码】第1关:正则表达式 - Scala。
flink学习(scala版)--第三章:Flink的部署模式
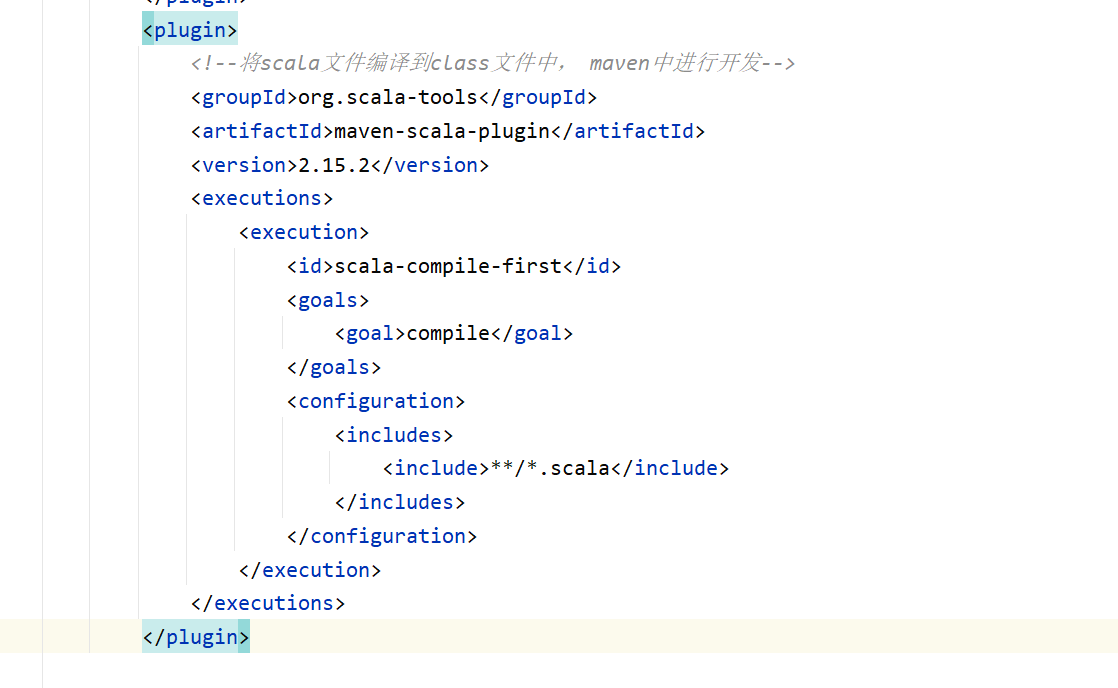
IDEA 内用mvn编译scala文件;scala插件scala-maven-plugin
Failed to execute goal org.scala-tools:maven-scala-plugin:2.15.2:compile (default) on project graduation: wrap: org.apache.commons.exec.ExecuteException: Process exited with an error: 1(Exit value: 1)
windows / ubuntu 安装spinal hdl
sparksql小文件的处理和其他优化
这种我们点进他们的jar包发现,他们有时候会缺少一部分jar包导致我们的提示不全,很大可能是由于我们maven下载的时候出现问题了,比如你正在下载的时候关掉了idea,等等.........但其实我们去找到这个仓库里面的jar包发现它是存在的,这个时候我们将他压缩到我们当前的文件夹,如果可以的话说明这个jar包是可以使用的。下面我们列出来在官网找到的部分关系信息,这里我们主要看spark在版本2.
问题1:Recovery is suppressed by NoRestartBackoffTimeStrategy问题2:sun.misc.Unsafe.monitorEnter(Ljava/lang/Object;)V,Java版本不对,pom中指定Java版本,设置中修改java版本。
spark安装配置
使用java开发的工程或多或少都会遇到VerifyError 类似的问题。flink版本: flink-1.10.1jdk版本为: 1.8.0_20java version "1.8.0_20"Java(TM) SE Runtime Environment (build 1.8.0_20-b26)Java HotSpot(TM) 64-Bit Server VM (build 25.20-b23,
spark 目前最常用的场景应该就是对 hive 表进行读写操作 ,尤其通过使用spark sql 实现数据分析、关联等操作 spark sql支持对dataframe(Dataset的特列,DataFrame=Dataset[Row] )进行操作,很多数据分析人员习惯使用python,而python没有dataset,而且sql方式对数据进行批处理方式更为直观。...
使用python训练模型生成PMML文件,然后用spark读取package com.ubiai.zhyx.sparkimport com.ubiai.zhyx.utils.SparkHelperimport org.apache.spark.ml.Transformerimport org.apache.spark.sql.{DataFrame, SparkSession}import org.
hive静态分区和动态分区
介绍filter的例子例1:Python 版本筛选的例子lines = sc.textFile("README.md")pythonLines = lines.filter(lambda line: "Python" in line)例2:Scala 版本筛选的例子val lines = sc.textFile("README.md") // 创建一个叫lines的RDDval pythonLin
IDEA创建这里写自定义目录标题IDEA创建scala项目编辑pom.xml出现报错:Cannot resolve plugin org.scala-tools:maven-scala-plugin: unknown首先检查文件中scala版本和spark版本是否与hadoop上一致仍有报错,在配置文件中添加下载地址<!-- https://mvnrepository.com/artifac
报错1:本地运行scala,报如下错误:java.lang.ClassNotFoundException: org.apache.spark.SparkConf,或调试:在pom文件中注掉红色字体一行<dependency><groupId>org.apache.spark</groupId><artifactId>spark-core_${scal
环境spark:3.0.0scala:2.12.10kafka:2.12-2.2.2spark-streaming:org.apache.spark:spark-streaming-kafka-0-10_2.12-3.0.0.jar描述使用spark-streaming连接Kafka并读取数据,出现如下错误:报错信息Exception in thread "streaming-start" jav
需求案例数据格式* 编号字段名称字段类型字段含义* 1dateString用户点击行为的日期* 2user_idLong用户的ID* 3session_idStringSession的ID* 4page_idLong某个页面的ID* 5action_timeString动作的时间点* 6search_keywordString用户搜索的关键词* 7click_category_idLo
写在前面SpinalHDL这个语言,我是在了解了香山处理器Chisel才知道的,一直想用一用,SpinalHDL和Chisel师承一脉,都是基于Scala来进行电路描述。其本质上仍旧是HDL而非HLS,在设计之前依旧需要有清晰的电路结构,在电路描述上更加方便和快捷。本文主要对spinal HDL的参考文档进行了翻译,后期打算应用spinal HDL进行简单的模块的改写。环境搭建参考大佬知乎文章搭建
前言1.安装环境依赖运行所需Java、 scala 环境。1.1 安装scala先创建需要下载scala的目录mkdir scala下载scalawget https://downloads.lightbend.com/scala/2.11.8/scala-2.11.8.tgz解压安装tar -zxvf scala-2.11.8.tgzvi /etc/profile添加对应的配置,根据你安装sca
前言在IEDA中,代码已经写好了,打算打包到服务器上运行,mvn clean packa 后直接报Failed to execute goal org.scala-tools:maven-scala-plugin:2.15.2:compile (compile-scala) on project解决方案1、网上很多都是说IDEA 中Scala版本和 本地版本不一致导致的,这个可以查看一下。我是其他
一.pom.xml<dependencies><dependency><groupId>org.apache.spark</groupId><artifactId>spark-core_2.12</artifactId><version>2.4.3</version></dependenc
文章目录部署local模式一,安装二,测试standalone模式一,部署二,测试standalone 高可用测试flink on yarn测试部署local模式一,安装1.下载安装包https://archive.apache.org/dist/flink/2.上传flink-1.12.0-bin-scala_2.12.tgz到node1的指定目录3.解压tar -zxvf flink-1.12
基于scala开发flink应用的pom文件<?xml version="1.0" encoding="UTF-8"?><project xmlns="http://maven.apache.org/POM/4.0.0"xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"xsi:schemaLocation="http://m
Spark SQL 中org.apache.spark.sql.functions归纳注意,这里使用的是scala 2.12.12,spark版本是最新的3.0.1版本1. Sort functions/*** Returns a sort expression based on ascending order of the column.* {{{*df.sort(asc("dept"), de
因玩票需要,使用三台搭建spark(192.168.1.10,192.168.1.11,192.168.1.12),又因spark构建在hadoop之上,那么就需要先搭建hadoop。历经一个两个下午,终于搭建完成,特记录如下。准备工作1. jdk已经安装。2. 文件下载http://pan.baidu.com/s/1o6mydYi 包含scala,hado...
一、Receiver模式1、 receiver模式原理图在SparkStreaming程序运行起来后,Executor中会有receiver tasks接收kafka推送过来的数据。数据会被持久化,默认级别为MEMORY_AND_DISK_SER_2,这个级别也可以修改。receiver task对接收过来的数据进行存储和备份,这个过程会有节点之间的数据传输。备份完成后去zookeep...
//自定义分区importorg.apache.spark.SparkConfimportorg.apache.spark.SparkConfimportorg.apache.spark.SparkCont...
1转载于:https://www.cnblogs.com/wqbin/p/11279292.html
flink1.7.2 tableapi批处理示例源码https://github.com/opensourceteams/flink-maven-scala概述本文为flink1.7.2 tableapi批处理示例主要操作包括: print table,DataSet 转换成table,Scan,select,as,where / filt...
scala
——scala
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 乐奇 Rokid 开放社区