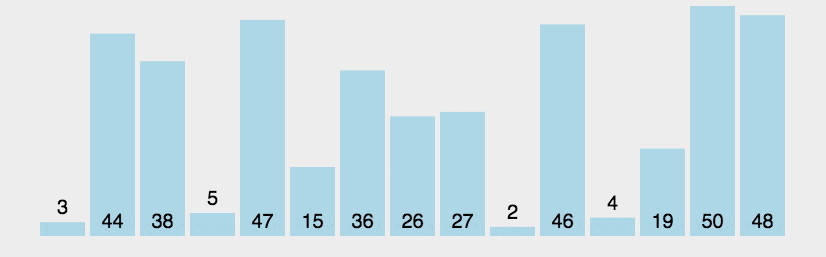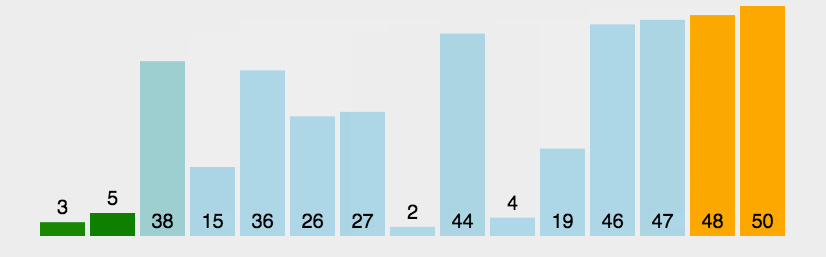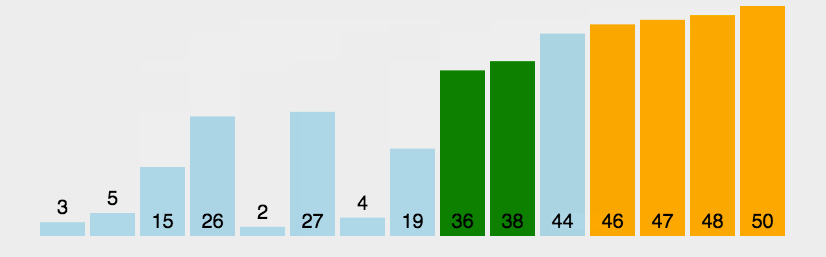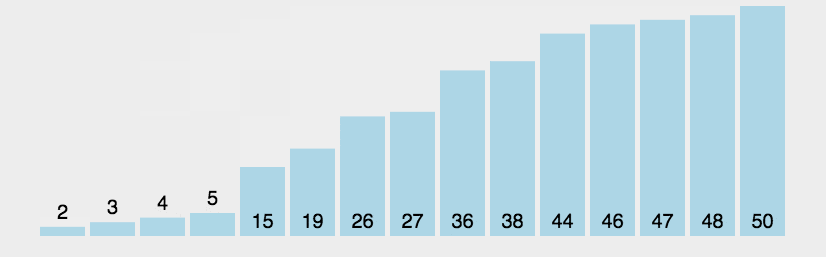登录社区云,与社区用户共同成长
邀请您加入社区
本文聚焦选择排序体系展开解析,涵盖直接选择排序、堆排序,及与插入排序的对比。首先介绍直接选择排序的概念与实现,说明其时间复杂度为O(n²),并梳理其核心特性;继而讲解堆排序的概念及基于堆结构的实现逻辑,指出其时间复杂度稳定为O(nlogn)、空间复杂度O(1),还提及可用于Top-K问题(效率达O(n+klogn)),同时总结其特性。文章还对比了插入排序与选择排序的差异,附总代码示例辅助实操理解。
本文主要讲解了选择排序中的直接选择排序和交换排序中的快速排序算法。直接选择排序通过每次遍历找出最小和最大值进行交换,但需要注意当最大值在数组开头时的特殊情况处理。快速排序采用递归思想,通过基准值将数组分为左右两部分,其中重点讲解了hoare版本和lomuto前后指针版本的实现,并提出了三数取中和小区间优化等改进方法。此外还介绍了利用栈实现非递归版本的快速排序,避免了递归可能导致的栈溢出问题。文章通
冒泡排序:重复遍历,两两比较,大的下沉。像气泡一样,每一轮将最大的元素“浮”到最终位置选择排序:打擂台,选最小,放前面。每一轮从未排序部分中选出最小(或最大)的元素,将其与未排序部分的第一个元素交换插入排序:摸牌理牌,逐个插入。像打扑克摸牌一样,将每个新元素插入到前面已经排好序的序列中的正确位置快速排序:选定基准,小数左大数右,递归处理。选择一个“基准”元素,将数组分成“小于基准”和“大于基准”的
本文通过可视化对比冒泡排序、插入排序和选择排序在百万级数据下的性能表现,揭示它们的独特特征与瓶颈。实验显示插入排序在有序数据上接近O(n)复杂度,而选择排序对数据分布不敏感。文章还提供了优化技巧和降维可视化方案,帮助开发者深入理解基础排序算法的适用场景。
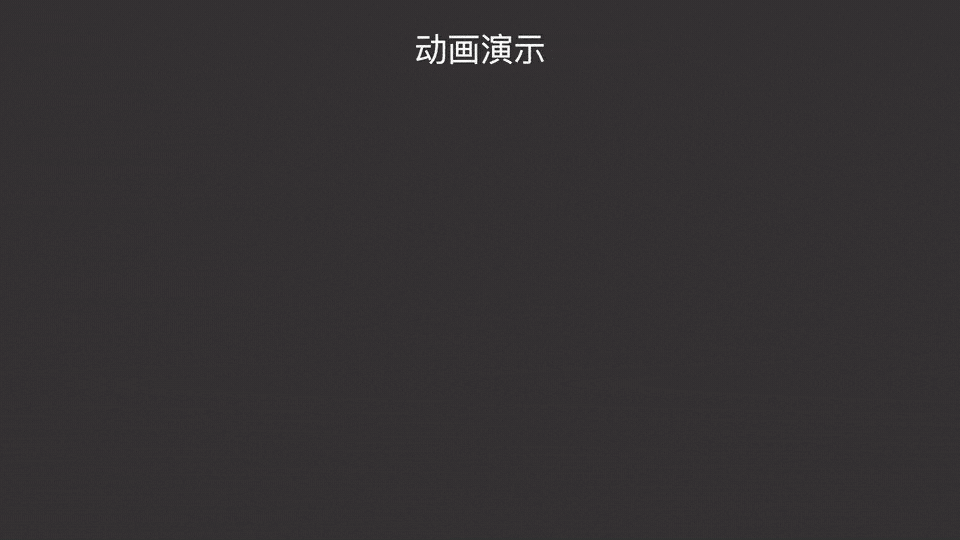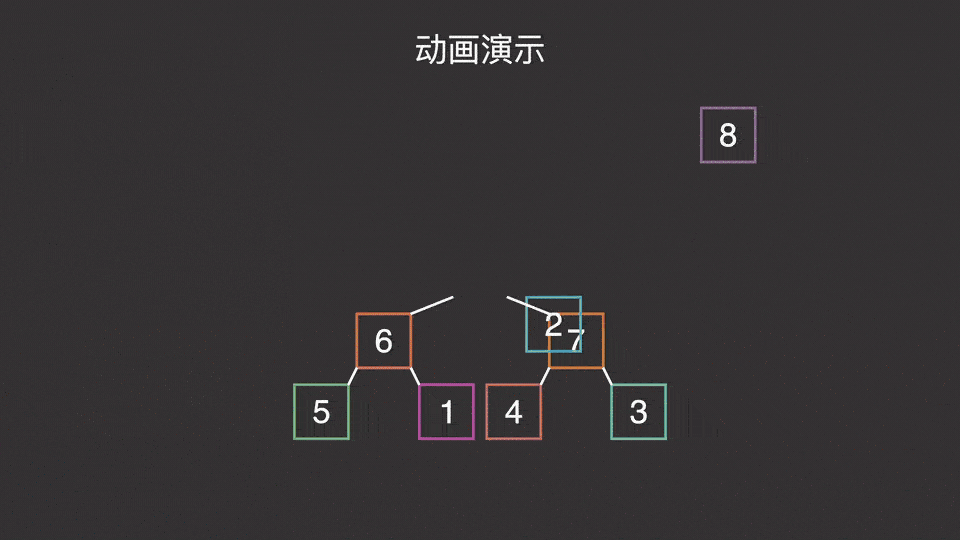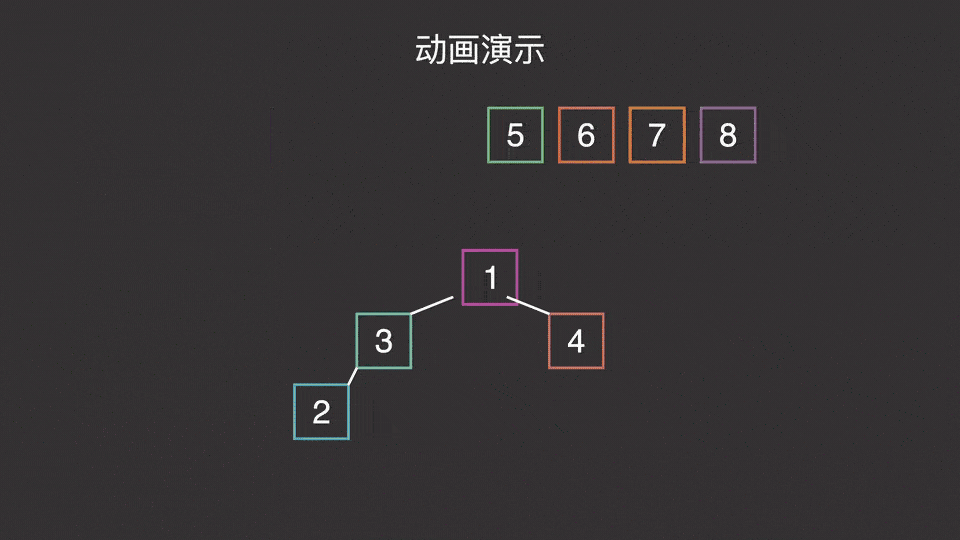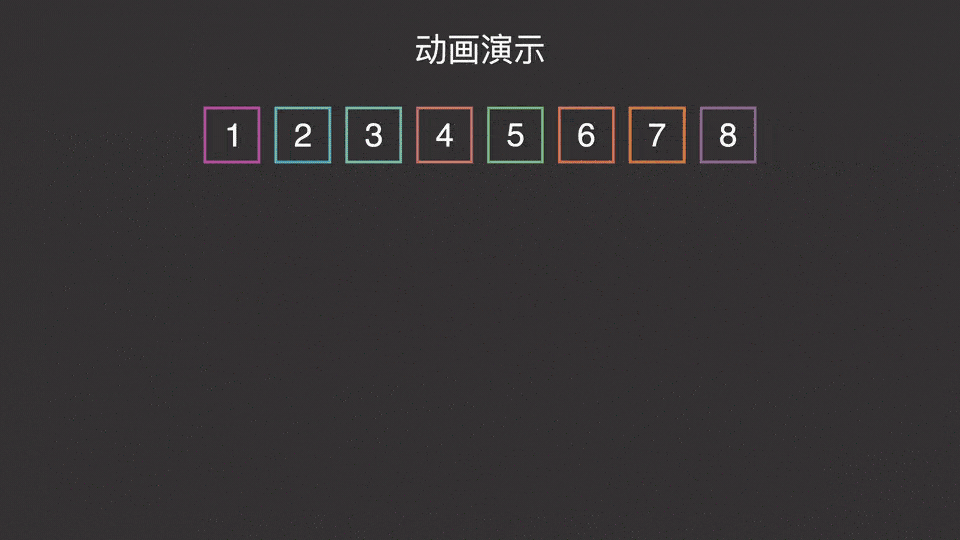
性能:时间复杂度 O(nlogn),空间复杂度 O(1),不稳定思路:把数组看做一个完全二叉树的结构,建立大顶堆(或小顶堆),排序就是把最顶层的根节点与末尾元素交换,然后继续从最顶层的根节点开始维护堆,循环往复就变成一个有序集合了。大顶堆:每个节点的值都大于或等于其子节点的值。堆顶(根节点)是整个堆的最大值。小顶堆:每个节点的值都小于或等于其子节点的值。堆顶(根节点)是整个堆的最小值。最开始建堆时
二叉树的层序遍历(BFS)是经典算法题,要求逐层从左到右访问节点并返回分层列表。最优解法使用队列实现BFS:初始化队列后,记录当前层节点数,循环处理每个节点时将其子节点入队,最后收集每层结果。时间复杂度O(n)(访问所有节点),空间复杂度O(n)(队列存储)。关键点在于分层处理:通过记录每层节点数确保输出格式正确,同时处理空树等边界情况。该算法是树遍历的基础应用,适合完全二叉树、链状树等各种树结构
本文介绍了两种排序算法:直接选择排序和堆排序。直接选择排序通过每次选出最小(或最大)元素并交换到起始位置实现排序,其时间复杂度为O(N²),空间复杂度为O(1),虽然思想简单但效率较低。堆排序基于堆数据结构,通过构建大顶堆并反复交换堆顶元素实现排序,时间复杂度为O(nlogn),空间复杂度为O(1),效率更高但实现较复杂。两种算法均属于不稳定排序,适用于不同场景。文章还提供了详细的代码实现,包括选
冒泡排序是一种基础交换排序算法,通过反复比较相邻元素并交换顺序错误的元素,将较大元素逐步"冒泡"至数组末端。其过程示例展示了从[5,2,9,3,6]到[2,3,5,6,9]的排序步骤,包含优化策略(无交换时提前终止)。该算法实现简单(附C语言代码)、空间复杂度低(O(1))且稳定,但时间复杂度为O(n²)效率较低。适用场景包括小规模数据、基本有序数据或教学演示,实际应用中更多作
本文比较了五种排序算法(插入排序、自顶向下/自底向上归并排序、随机快速排序和三向切分快排)的性能表现。测试结果显示,在处理10万个随机整数时,插入排序最慢(平均2513ms),随机快排最快(平均18.8ms)。文章详细描述了各算法原理,并提供了完整的C#实现代码。实验表明,在随机数据场景下快速排序类算法表现最优,而归并排序次之,插入排序仅适合基本有序的数据。本文还探讨了不同算法的时间复杂度特性,为
在数据结构入门课程中,理解排序算法的时间复杂度和空间复杂度是评估算法效率的核心。时间复杂度和空间复杂度描述了算法性能随输入规模(如元素数量 $n$)增长的变化趋势。它们使用大O表示法(Big O notation)来量化,帮助我们在实际应用中权衡速度和内存使用。下面我将逐步解释这些概念,并以常见排序算法为例进行说明。为什么重要?在排序算法中,高时间复杂度可能导致大规模数据下运行缓慢,高空间复杂度可
时间复杂度平均情况:$O(n + k \cdot m \log m)$,优化后$m$较小,整体高效。最坏情况:$O(n^2)$(如数据全在一个桶且用插入排序),但通过动态选择可避免。空间复杂度:$O(n + k)$,主要来自桶存储。优化收益:在实际测试中,优化后桶排序比基础版本快2-5倍,尤其在大数据集或非均匀数据时。建议根据应用场景调整阈值(如通过基准测试确定)。总之,桶内排序算法的优化关键在于
在多路归并排序中,如果各个初始归并段的长度不等,那么采用不同的归并顺序会导致不同的磁盘访问次数。例如,对于3个长度分别为10、20、30个记录的归并段进行二路归并,如果先归并长度为10和20的两个段,再与长度为30的段归并,总的读写次数会少于先归并20和30再与10归并的方案。这是因为较短的归并段被归并的次数更多,应该尽量让它们在归并树的较高层,从而减少其读写次数。如何确定最优的归并顺序,使得总的
在日常整理扑克牌时,我们通常会把抓到的新牌插入到已整理好的牌堆里,保持牌堆始终有序——直接插入排序的思想与此完全一致。它将待排序数组分为“已排序区间”和“未排序区间”,每次从“未排序区间”取出第一个元素,插入到“已排序区间”的合适位置,最终让整个数组有序。综上,直接插入排序是一种逻辑直观、实现简单的排序算法,核心是“逐步构建有序区间,每次插入一个元素”。它在小规模或基本有序的数组上表现高效,且具有
在交换排序中,冒泡排序是最直观的一种,它通过相邻元素的两两比较和交换,让值较大的元素像水中的气泡一样逐步“上浮”到数组末尾,最终实现整个数组的有序排列。这种排序方式的核心是“逐趟筛选最大元素”,每完成一趟排序,就有一个最大元素被固定在正确的位置,后续排序无需再处理该元素。,但通过“交换标志”的优化,在基本有序数组上能表现出较高效率,且具备稳定、原地排序的优势,是学习交换排序思想的基础。:当相邻元素
最详细!最直观!插入排序(直接插入排序、折半插入排序、希尔排序)讲解及其代码。
插入排序是一种简单直观的排序算法,它的工作原理类似于我们整理扑克牌,将每个新元素插入到已排序部分的正确位置。
分区:小于 2 的放左,大于 2 的放右→[1,2,4,3](基准 2 到位)递归左半[1](已有序)和右半[4,3]右半选 3 为基准→分区得[3,4](基准 3 到位)[1,2,3,4]算法时间复杂度(平均)时间复杂度(最坏)空间复杂度稳定性适用场景冒泡排序O(n²)O(n²)O(1)稳定小规模数据选择排序O(n²)O(n²)O(1)不稳定小规模数据,交换成本高时插入排序O(n²)O(n²)O
本文系统介绍了差分约束系统与最短路径算法的理论联系及实际应用。差分约束系统通过将线性不等式转化为有向图,利用最短路径算法求解,两者基于三角形不等式建立数学关联。文章详细讲解了Dijkstra、Bellman-Ford等算法原理,并提供了POJ1201问题的实战案例,展示如何将差分约束转化为图论问题求解。最后总结了算法在任务调度、资源分配等场景的应用价值,并展望了在AI、大数据等领域的未来发展前景。
十大经典排序算法:MATLAB实现与可视化
本文系统介绍了常见排序算法及其实现。主要内容包括:1)排序概念与分类(内部/外部排序、稳定性);2)经典排序算法实现(插入排序、希尔排序、选择排序、堆排序、冒泡排序、快速排序、归并排序);3)算法性能测试与对比;4)复杂度与稳定性分析。重点阐述了各算法的核心思想、代码实现及优化策略,如快速排序的挖坑法和前后指针法、归并排序的分治思想等。测试结果表明,不同算法在时间/空间复杂度上存在显著差异,其中快
对于一个数组,从前往后依次比较相邻的两个元素,将较大的元素放在较小的元素的后面。假设数组的长度为n,第一次比较需要比较n-1次,第二次在剩下的n-1个元素里面找最大值,需要比较n-2次......直到比较到还剩下一个元素,这时剩下的这个元素就一定是最小的,从小到大的排序任务就完成了。
文章摘要:希尔排序是直接插入排序的优化版本,通过分组插入和增量序列策略提升效率。核心思想是:先以较大增量分组排序,再逐步缩小增量直至1,完成最终排序。其时间复杂度约为O(n^1.5),空间复杂度为O(1),但稳定性较差。希尔排序适用于中等规模数据、嵌入式系统等场景,优点是实现简单、内存占用少;缺点是时间复杂度分析复杂、增量序列选择困难。相比快速排序和归并排序,希尔排序在特定场景下更具优势。
交换排序是排序算法中的一种基本方法,通过比较和交换元素实现排序。主要包括冒泡排序和快速排序两种典型算法。冒泡排序通过相邻元素比较和交换,逐步将最大元素移到数组末尾,时间复杂度为O(n²)。快速排序采用分治思想,选取基准值将数组划分为左右子区间,递归排序,平均时间复杂度为O(nlogn)。快速排序有多个实现版本,包括Hoare版本、挖坑法、前后指针法等,非递归实现可使用栈来模拟递归过程。交换排序的核
排序是指将一串记录,按照其中某个或某些关键字的大小,以递增或递减的顺序排列起来的操作。这里的 “记录” 可以是数字、商品信息、学生成绩等,“关键字” 则是排序的依据,如数字大小、商品价格、成绩高低等。排序算法是数据结构与算法的基础,掌握不同算法的核心逻辑、性能特性与适用场景,是高效解决实际问题的关键。日常开发中,快速排序因综合性能最优成为首选;需稳定排序时可选择归并排序;内存紧张时堆排序更合适;元
在这个汇总中整理了 插入,希尔,选择,快排,堆排,冒泡,归并还有非比较排序 计数,基数排序算法的稳定性:再对相同值的元素排序之后,如果元素之间的顺序并没有发生变化,则是稳定的对一个数组向前表示下标减减 向后加加。
本文系统介绍了交换排序算法,重点分析了冒泡排序和快速排序两种经典算法。冒泡排序通过相邻元素比较和交换实现排序,时间复杂度为O(n²);快速排序采用分治思想,平均时间复杂度为O(n log n)。文章详细讲解了Hoare版本、挖坑法、Lomuto前后指针法和非递归版本四种快速排序实现方式,并进行了性能比较测试,结果显示挖坑法效率最优。这些算法在数据处理和计算机教学中具有重要价值,读者可根据具体需求选
【C语言选择排序算法详解】+ 算法性能优化 + 动态演示实现
快速排序。
排序算法总结:本文介绍了常见的排序算法,包括插入排序(直接插入、希尔)、选择排序(简单选择、堆排序)、交换排序(冒泡、快速排序)、归并排序和非比较排序(计数、基数排序)。重点分析了各算法的时间复杂度(冒泡O(n²)、快速排序O(nlogn)等)、空间复杂度以及稳定性(冒泡、插入稳定,选择、快速不稳定)。详细阐述了冒泡、选择、插入、希尔、归并、快速等算法的实现步骤和代码示例,并比较了它们的优缺点。特
mid=(right+left)>>1,为了防止溢出,我们写成mid=left+(right-left)/2;(1)当left=>right即,区间里面只有1个元素或者没有元素时,表示无需排序,直接return;由于本题需要使得数组进行升序排列,所以我们可以使用。[left,mid]和[mid+1,right],即将tmp中的元素移动到nums中。时间复杂度:T(n)=O(nlogn),将合并后的
排序算法最坏情况比较次数复杂度冒泡排序n(n-1)/2O(n²)插入排序n(n-1)/2O(n²)选择排序n(n-1)/2O(n²)快速排序(最坏)n(n-1)/2O(n²)堆排序2n log nO(n log n)堆排序利用了堆的树形结构特性,避免了O(n²)的比较,这是它与其他简单排序算法的本质区别。
归并排序是一种基于分治法的排序算法,擅长处理外排序问题。其核心思想是将序列递归分解为有序子序列,再通过合并操作得到完全有序的结果。算法实现包括递归和非递归版本,都需要O(N)的临时空间用于合并操作。归并排序的时间复杂度为O(N*logN),空间复杂度为O(N),具有稳定性。在处理大文件排序时,可先将文件分割成内存可容纳的小块,分别排序后再逐步归并,最终完成整个文件的排序。这种特性使归并排序成为处理
本文主要介绍了堆排序算法、仿函数和优先级队列的原理与实现。堆排序通过向上/向下调整算法将数组构建为大堆或小堆,时间复杂度为O(n*logn)。仿函数通过重载operator()实现类似函数的行为,用于模板类和模板函数中。优先级队列基于堆结构实现,支持插入元素和获取最大/最小元素操作,默认使用vector作为底层容器,通过仿函数控制排序方式。文中提供了完整的代码实现,包括堆排序的AdjustUp/A
JAVA:实现使用快速排序算法获取给定数组中的第 k 个最大或第 k 个最小元素算法(附带源码)
在计算机科学领域,排序算法是基础且关键的内容。理解各种排序算法的原理和性能对于技术人员至关重要。然而,仅仅通过理论学习和代码阅读来掌握排序算法,可能会让人感到抽象和困惑。算法可视化则为我们提供了一种直观的方式,通过动态演示排序过程,帮助我们更好地理解算法的工作原理。本文将详细介绍如何使用 C 语言实现排序算法的动态演示,带你走进算法可视化的奇妙世界。
排序算法—交换排序(快速排序)(动图演示)
本文系统介绍了常见排序算法及其实现原理。主要内容包括:1.排序基本概念与分类(内部/外部排序、稳定性);2.四大类排序算法实现:插入排序(直接插入、希尔)、选择排序(直接选择、堆)、交换排序(冒泡、快速排序三种方法)、归并排序;3.算法特性分析(时间复杂度、空间复杂度、稳定性),如快速排序O(nlogn)但不稳定,归并稳定但需O(n)空间;4.非比较型计数排序的原理与特点。文章通过代码示例和步骤分
本文系统介绍了排序算法概念与实现。排序是将记录按关键字大小排列的操作,分为内部排序(内存中)和外部排序(数据过大)。算法特性包括时间复杂度、空间复杂度和稳定性(相同元素相对位置不变)。重点分析了插入排序(直接插入O(n²)稳定、希尔排序O(n^1.3)不稳定)、选择排序(直接选择O(n²)不稳定、堆排序O(nlogn)不稳定)、交换排序(冒泡O(n²)稳定、快速排序O(nlogn)不稳定)以及归并
排序算法-选择排序(选择排序、堆排序)(动图演示)
排序算法—交换排序(冒泡)(动图演示)
1. 快速排序(Quick Sort)2. 归并排序(Merge Sort)3. 堆排序(Heap Sort)4. 冒泡排序(Bubble Sort)5. 插入排序(Insertion Sort)
文章介绍了归并排序算法,这是一种基于分治策略的稳定排序方法。归并排序通过"分"(递归分解数组)和"治"(有序合并子数组)两个阶段实现排序,时间复杂度稳定为O(nlogn)。文章详细讲解了递归实现过程,包括数组分解、子数组合并等核心步骤,并提供了完整代码实现。同时分析了归并排序的优缺点:空间复杂度高(O(n))但稳定性好,适合大数据集排序。文章还指出该算法可用
以下将详细讲解奇偶排序的原理、步骤、优化方法、C#实现、测试用例,并结合半导体场景进行说明,同时与归并排序、堆排序、选择排序、希尔排序、快速排序、LSD基数排序、插入排序、并行堆排序、地精排序、并行圈排序、计数排序、梳排序、BST排序、优化桶排序、优化冒泡排序、优先级队列及加权有向稠密图进行对比。奇偶排序(Odd-Even Sort),也称为奇偶转置排序(Odd-Even Transpositio
以下将详细讲解鸽巢排序的原理、步骤、优化方法、C#实现、测试用例,并结合半导体场景进行说明,同时与归并排序、堆排序、选择排序、希尔排序、奇偶排序、快速排序、LSD基数排序、插入排序、并行堆排序、地精排序、并行圈排序、计数排序、梳排序、BST排序、优化桶排序、优化冒泡排序、优先级队列及加权有向稠密图进行对比。鸽巢排序(Pigeonhole Sort)是一种基于非比较的排序算法,适用于整数或有限离散值
以下将详细讲解希尔排序的原理、步骤、优化方法、C#实现、测试用例,并结合半导体场景进行说明,同时与归并排序、堆排序、选择排序、快速排序、LSD基数排序、插入排序、并行堆排序、地精排序、并行圈排序、计数排序、梳排序、BST排序、优化桶排序、优化冒泡排序、优先级队列及加权有向稠密图进行对比。希尔排序(Shell Sort)是一种高效的比较型排序算法,是插入排序的改进版本,通过引入增量序列(gap se
本文系统介绍了动态规划算法的核心思想与经典应用。首先阐述了动态规划的基本原理,包括最优子结构和重叠子问题两个关键特性。随后详细讲解了四个经典问题:1) 钢条切割问题,通过价格最大化展示自顶向下和自底向上两种实现方式;2) 矩阵链乘法问题,演示如何优化矩阵相乘顺序;3) 最长公共子序列问题,介绍字符串匹配的动态规划解法;4) 最优二叉搜索树问题,说明如何构建搜索效率最高的二叉树。每个问题都配有完整的
基数排序(Radix Sort)是一种非比较型的排序算法,它通过逐位比较元素的每一位(从最低位到最高位)来实现排序。基数排序的核心思想是将整数按位数切割成不同的数字,然后按每个位数分别进行排序。基数排序的时间复杂度为 O(n * k),其中 n 是列表长度,k 是最大数字的位数。
以下将详细描述地精排序的原理,结合半导体车间调度、测试机、MES、EAP等场景的应用,提供C#代码实现、示例和测试用例,并与并行圈排序、计数排序、梳排序、BST排序、优化桶排序、优化冒泡排序及加权有向稠密图进行对比。1.1 地精排序原理地精排序的工作方式类似于一个“地精”在整理一排花盆:从左到右检查每个元素,若当前元素比前一个元素小,则交换并向后退一步检查;2. C#实现地精排序以下是C#实现的地
RPF(Reciprocal Rank Fusion)排序算法作为一种高效的结果融合方法,能够有效整合多个检索系统的输出,生成更优的排序结果
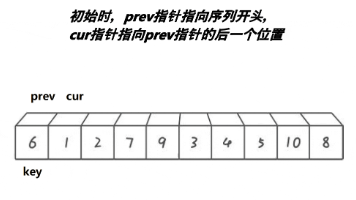
本文介绍了两种交换排序算法——冒泡排序和快速排序。两种算法各具特点,其中快速排序综合性能更优,在实际应用中更常见。本文章重点详细介绍了快速排序的思想和实现:hoare、挖坑法和前后指针三种划分方法,随机选key和三数取中两种优化方案,以及快速排序的非递归实现。
排序算法
——排序算法
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 天工造物局