登录社区云,与社区用户共同成长
邀请您加入社区
MiniMax H3 的原生采样步数较高,生成速度偏慢。目前社区已有多种加速方案,包括少步 LoRA、微调大模型以及针对 VAE 解码的优化。以下基于本地实测数据,整理各方案的配置方式、性能表现与适用场景。
一个 Agent 驱动的集 AI图片生成、AI视频生成、无限画布、自定义模型 API 、AI漫剧、AI短剧、小说解析剧本、小说转短剧、3D导演台、用户管理、积分管理于一体的全流程开源平台。
本文介绍了如何在星图GPU平台上自动化部署Heygem数字人视频生成系统批量版webui版(二次开发构建by科哥)镜像,快速搭建数字人视频生成环境。用户无需配置命令行或Python环境,通过Web界面即可批量将一段音频与多个数字人视频素材合成口型同步的1080p培训短视频,显著提升企业培训内容生产效率。
本文介绍了如何在星图GPU平台上自动化部署PyTorch 2.8深度学习镜像,实现AI绘画、视频生成与智能剪辑的一体化解决方案。该镜像预装完整工具链,支持Stable Diffusion等模型,可快速生成高质量图像和视频内容,适用于数字内容创作、社交媒体营销等场景。
本文介绍了如何在星图GPU平台上自动化部署RVC语音转换镜像,实现从声音克隆到视频配音的多模态应用。通过该平台,用户可以快速搭建环境,利用RVC训练个性化声音模型,并结合唇动同步技术,为视频生成口型匹配的配音,广泛应用于短视频创作、内容本地化等场景。
本文介绍了如何在星图GPU平台上自动化部署Live Avatar阿里联合高校开源的数字人模型,实现语音驱动的数字人视频生成。用户上传一段语音和单张人像照片,即可快速生成口型同步、表情自然的AI数字人视频,典型应用于企业培训、电商产品讲解和社交媒体口播等场景。
本文介绍了如何在星图GPU平台上自动化部署Heygem数字人视频生成系统批量版webui版 二次开发构建by科哥镜像,高效实现数字人视频批量生成。用户可一次性提交多组音频与数字人视频,在WebUI界面完成拖放、校验、一键生成及ZIP打包下载,广泛应用于企业培训、电商商品讲解和实时宣传短视频制作等场景。
本文介绍了如何在星图GPU平台上自动化部署Live Avatar阿里联合高校开源的数字人模型,实现高质量AI数字人视频生成。用户仅需上传单张人像照片与音频,即可快速生成口型同步、微表情自然、肢体流畅的视频,广泛应用于企业培训、电商讲解及多语言内容分发等场景。
本文介绍了如何在星图GPU平台上自动化部署Heygem数字人视频生成系统批量版webui版(二次开发构建by科哥)镜像,高效实现多音频与多数字人交叉匹配的批量视频生成,典型应用于电商产品宣传、多平台内容分发及A/B测试等场景,显著提升数字人视频生产效率。
本文介绍了如何在星图GPU平台上自动化部署Heygem数字人视频生成系统批量版webui版(二次开发构建by科哥)镜像,快速搭建数字人视频生产环境。该镜像支持单/批量音频驱动多形象视频生成,典型应用于企业培训开场、官网弹窗引导、社群拜年等真实业务场景,显著提升视频内容创作效率。
本文介绍了如何在星图GPU平台上自动化部署HunyuanVideo-Foley私有部署镜像(RTX4090D 24G CUDA12.4优化版),实现AR/VR内容开发中的空间音频与动态场景同步生成。该镜像通过双流架构技术,能够根据文本描述一键生成沉浸式音视频内容,大幅提升虚拟场景原型开发效率,特别适用于虚拟房地产展示、VR安全教育等应用场景。
本文介绍了如何在星图GPU平台上自动化部署Heygem数字人视频生成系统批量版webui版 二次开发构建by科哥镜像,实现真人视频口型同步替换功能。用户上传音频与原始真人短视频后,系统可批量生成高清、低延迟、高真实感的数字人说话视频,广泛应用于在线教育导语制作、电商口播及企业宣传等场景。
本文介绍了如何在星图GPU平台上自动化部署Live Avatar阿里联合高校开源的数字人模型镜像,实现高保真数字人视频生成。通过平台的一键式环境配置,用户可快速完成多卡分布式部署,应用于AI虚拟主播、课程讲解视频制作等典型场景,显著降低大模型视频生成的技术门槛。
本文介绍了如何在星图GPU平台上自动化部署Live Avatar阿里联合高校开源的数字人模型,实现输入照片与音频即可生成高质量数字人视频。该镜像适用于电商产品介绍、企业培训、多语种内容制作等典型场景,显著降低数字人视频生产门槛与成本。
本文介绍了如何在星图GPU平台上自动化部署Heygem数字人视频生成系统批量版webui版 二次开发构建by科哥镜像,高效支持AI数字人视频的批量生成与智能清理。用户可直接通过WebUI完成冗余视频文件的精准删除与任务区重置,显著优化磁盘空间与工作流效率,适用于内容创作、课件制作等高频视频生产场景。
本文介绍了如何在星图GPU平台上自动化部署Heygem数字人视频生成系统批量版webui版 二次开发构建by科哥镜像,实现数字人视频批量生成。用户只需上传一段音频和多个数字人视频素材,即可一键生成音画同步、唇形精准的讲解视频,广泛应用于产品介绍、A/B测试及内容矩阵搭建等场景。
本文介绍了如何在星图GPU平台上自动化部署Heygem数字人视频生成系统批量版webui版 二次开发构建by科哥镜像,快速搭建AI主播视频生产环境。用户上传音频与数字人视频后,可一键批量生成唇形自然、音画同步的MP4口播视频,广泛应用于课程讲解、电商商品解说和企业培训等场景。
本文介绍了如何在星图GPU平台上自动化部署Live Avatar阿里联合高校开源的数字人模型,实现个性化数字人视频制作。通过平台一键启动Gradio界面或CLI脚本,用户可快速将静态人像与语音合成自然口型同步的高清视频,广泛应用于知识分享、产品介绍等AI内容创作场景。
本文介绍了如何在星图GPU平台上自动化部署Heygem数字人视频生成系统批量版webui版 二次开发构建by科哥镜像,实现高精度音频驱动数字人视频生成功能。该镜像支持本地化一键运行,典型应用于企业产品口播、在线课程讲解及电商主播视频批量制作等场景,兼顾隐私安全与专业级嘴型同步效果。
本文介绍了如何在星图GPU平台上自动化部署Heygem数字人视频生成系统批量版webui版 二次开发构建by科哥镜像,快速搭建数字人视频生产环境。用户上传音频与数字人视频模板后,系统可自动完成口型同步、批量渲染与下载,典型应用于企业产品介绍、在线课程制作等AI视频内容生成场景。
本文介绍了如何在星图GPU平台上自动化部署Heygem数字人视频生成系统批量版webui版 二次开发构建by科哥镜像,实现数字人视频内容的批量生成与智能水印嵌入。该方案支持可见/不可见水印自动添加,广泛应用于企业培训视频、营销宣传视频等需版权保护的AI视频制作场景。
本文介绍了如何在星图GPU平台上自动化部署Heygem数字人视频生成系统批量版webui版 二次开发构建by科哥镜像,高效实现语音驱动的数字人视频批量制作。用户上传音频并选择数字人模板后,系统可自动生成口型精准、眼神自然、微表情真实的1080p视频,广泛应用于电商多语种推广、在线教育微课及政务政策解读等场景。
本文介绍了如何在星图GPU平台上自动化部署Live Avatar阿里联合高校开源的数字人模型镜像,快速生成高质量数字人视频。通过标准化配置,用户可基于单张人像照片与语音音频,实现口型精准同步、表情自然的5分钟讲解视频,适用于产品发布、企业培训等实际场景。
本文介绍了如何在星图GPU平台上自动化部署Live Avatar阿里联合高校开源的数字人模型镜像,高效批量生成数字人讲解视频。该方案已应用于电商商品介绍、在线课程制作等典型场景,通过CLI脚本化流水线与显存优化策略,显著提升视频生产吞吐量与一致性。
本文介绍了如何在星图GPU平台上自动化部署Heygem数字人视频生成系统批量版webui版 二次开发构建by科哥镜像,高效实现多数字人形象的口型同步视频批量生成。典型应用于同一段音频快速输出多个平台适配(如抖音竖屏、B站横屏)或A/B测试版本,显著提升数字人内容生产效率。
本文介绍了如何在星图GPU平台自动化部署AnimateDiff文生视频镜像,实现AI视频生成与Wave2Lip声音同步技术的整合。该方案能够根据音频内容自动生成精准的口型动画,广泛应用于短视频制作、多语言内容创作和教育培训等领域,显著提升视频的真实感和制作效率。
本文介绍了如何在星图GPU平台上自动化部署Heygem数字人视频生成系统批量版webui版 二次开发构建by科哥镜像,实现高效的多语言数字人视频制作。该平台简化了部署流程,用户可快速利用该镜像,将一段音频与人物视频结合,批量生成口型精准同步的多语言宣传或教育视频,显著提升内容生产效率。
本文介绍了如何在星图GPU平台自动化部署EasyAnimateV5-7b-zh-InP/7B参数量图生视频模型,实现智能监控视频摘要生成。该方案通过计算机视觉提取关键帧,并利用该模型将静态帧转换为流畅的动态摘要视频,大幅提升监控内容处理效率,适用于安防、商场等多种场景。
多模态技术正成为人工智能领域的重要发展方向,它通过整合视觉、语音、文本等不同模态的信息,实现更全面的内容理解与生成。UniVideo框架创新性地将视频理解、生成和编辑三大功能集成到统一架构中,采用多模态编码器网络、跨模态对齐引擎和任务特定头网络等核心技术组件。该框架通过动态梯度标准化和内存优化技术,有效解决了跨模态训练中的梯度平衡和长视频处理难题。在电商视频制作、智能教育等场景中,UniVideo
视频生成模型正在成为内容生产的新基建,而本地部署则是实现可控生成与低成本试验的关键路径。MiniMax H3作为一款高权重视频生成模型,通过ComfyUI工作流可完成文生视频、图生视频及参考模式生成,其中ref2va全能参考模式能有效保持人物ID一致性,为虚拟主播、固定角色视频创作提供了技术支撑。在工程实践上,结合量化整合包可降低显存门槛,使8G显存级别的NVIDIA显卡也能运行。生成后的视频片段
视频生成模型选型绕不开 SVD、Sora、Latte、VideoCrafter 与 DiT 架构差异。本文用一张对照表理清各自适用场景,并给出可复制的 settings.json、auth.json 与 curl 片段,把多模型调用统一到 TaoToken 通道,附 401、超时、reading choices 等报错排查路径。详见 https://taotoken.net/?utm_source
本文介绍了如何在星图GPU平台上自动化部署Live Avatar阿里联合高校开源的数字人模型,显著提升大型数字人模型的下载与部署效率。借助HF_MIRROR镜像加速方案,用户可快速完成Wan2.2-S2V-14B与LiveAvatar LoRA权重的稳定拉取,并支持实时驱动数字人生成口型同步的视频内容,适用于虚拟主播、AI教学等典型场景。
整理汇总下2024年ECCV AIGC相关的论文和代码,具体如下
视频生成与3D视觉是当前计算机视觉落地的核心方向,其技术本质是通过时序建模与几何先验的协同优化,实现从单图/文本到动态内容的可控生成。原理上,主流方案已从全局扩散转向分块时空注意力与运动残差引导,显著降低显存开销并提升帧间一致性;技术价值在于突破算力瓶颈,使RTX 3090等消费级硬件具备微调与推理能力;典型应用场景涵盖教学动画、产品展示视频、A/B测试素材及轻量级3D资产生成。尤其在‘ai视频生
豆包年调用量180万亿背后,Seedance 2.5超长视频生成已接入TaoToken统一Key。本文给出可复制的Base URL、API Key与Model ID配置片段,并附文本验证与视频任务轮询的完整代码,帮助开发者用一套凭证同时调用豆包大模型与视频生成能力。详见 https://taotoken.net/?utm_source=taotoken_aicg_blog_end
本文详细拆解了如何利用扣子平台构建AI智能体工作流,实现从创意到成片的自动化视频生产线。通过将文案生成、图像创作、语音合成与时间线编排等环节模块化与并行处理,作者成功批量生产了上百条高质量励志视频,为内容创作者提供了提升产能的实战解决方案。
本文深入解析了n8n工作流在视频分镜生成中的技术实现,展示了如何通过模块化设计和异步处理机制高效完成长视频生成。文章详细介绍了核心架构、异步处理策略、分镜连贯性保障及成本优化方案,为开发者提供了一套完整的自动化视频创作解决方案。
扩散 Transformer 只会看像素,却不懂“杯子”“机械臂”?🤔 SlotDiT 首次把物体级 slot 表示接入 DiT,让模型直接在“物体”上做去噪。生成质量有竞争力,四个机器人数据集任务完成率稳定提升。想知道表示设计如何胜过堆参数?这篇文章带你从三大 latent 路线看懂选型逻辑。
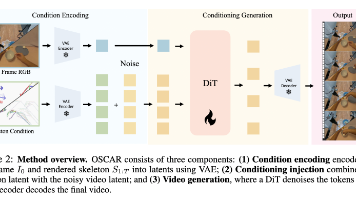
输入 = 当前场景首帧图片 + 未来一段机器人的 2D 运动学骨架序列;输出 = 按这段骨架动作发展出来的未来机器人视频。OSCAR 不是又一款追求“画面像不像”的视频生成器,而是把动作条件视频预测改造为策略筛选器:给定一个真实首帧和给定策略的动作轨迹,模型自回归生成未来视频,再由 GPT-5 判读成功率,以此预测 RoboArena 真实排名。它的核心设计是 2D 运动学骨架:把不同机械臂或人手
本文介绍了如何在星图GPU平台上自动化部署EasyAnimateV5 - 7b - zh - InP/7B 参数量图生视频模型镜像,结合Real-ESRGAN实现视频超分辨率增强,典型应用于AI生成视频的高清化处理,显著提升文字、毛发、建筑等细节的清晰度与专业表现力。
中关村学院 HMI Lab 提出世界-自我建模与 WEM:把具身未来预测拆成世界演化与自我动力学,用 RCA 状态预测器和 CP-MoE 生成器在 HTEWorld 上取得 61.48 的 EWMScore,超 PAN-style 基线 3.08 分。
本文介绍了如何在星图GPU平台上一键自动化部署🎬 CogVideoX-2b (CSDN 专用版)镜像,实现基于CSV提示词列表的批量视频生成。该工具特别适用于电商宣传、社交媒体内容等场景,能够高效生成风格统一的短视频,大幅提升视频创作效率。
本文介绍了如何在星图GPU平台上自动化部署AIVideo一站式AI长视频工具镜像,实现高效的视频生成与质量测试。通过集成CI/CD流水线,用户可自动执行视频生成、质量评估和性能测试,适用于短视频制作、内容创作等场景,显著提升开发效率和视频产出质量。
本文手把手教你如何零代码使用扣子(Coze)平台创建AI智能体,快速生成个性化视频教程。通过搭建工作流,整合文案生成、AI绘图与语音合成,实现从创意到成片的自动化流程,大幅降低视频创作门槛,让每个人都能轻松成为内容创作者。
视频生成
——视频生成
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 北京朝阳AI社区


 火山引擎视频云技术社区


 乐奇 Rokid 开放社区


 DAMO开发者矩阵




 天工造物局

