- @Mrxiao_bo


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
这次把 XAMPP 搬到 OpenHarmony PC,最核心的工作不是重画控制面板,而是重新安排 Apache 的运行边界:把进程式服务器变成可静态链接的原生模块,把服务生命周期交给应用线程,把配置与站点内容收进沙箱,再把 Apache 的模块注册、符号重定位和错误退出路径逐一适配。最终形成的方案并非“在鸿蒙里照搬 Linux 服务管理”,而是保留 Apache 的协议与模块能力,同时采用 HA
这次把 XAMPP 搬到 OpenHarmony PC,最核心的工作不是重画控制面板,而是重新安排 Apache 的运行边界:把进程式服务器变成可静态链接的原生模块,把服务生命周期交给应用线程,把配置与站点内容收进沙箱,再把 Apache 的模块注册、符号重定位和错误退出路径逐一适配。最终形成的方案并非“在鸿蒙里照搬 Linux 服务管理”,而是保留 Apache 的协议与模块能力,同时采用 HA
一个商品要上架,得先备齐一套资料,包括产品说明书、检测报告、品牌授权书、平台发布规则、商品参数表,以及一份待发布的文案。这六份东西来自不同的人,说明书是研发给的,检测报告是第三方机构出的,授权书是品牌方签的,发布规则是平台下发的,文案是运营写的。它们之间有一件事必须成立,就是关键字段得互相对得上,型号、净含量、品牌名、生产企业、授权渠道、授权有效期,任何一项对不上,轻则被平台驳回重提,重则算虚假宣
本文将比较Spring Boot代码层面实现数据库读写分离与使用ProxySQL管理读写分离的优缺点、适用场景和操作方法。通过对比这两种方法的原理、配置和实际应用效果,读者将更好地了解如何在项目中选择合适的读写分离方案。
本文将深入研究Kafka中的消息丢失问题,探讨可能导致消息丢失的原因,并提供解决方案。我们将揭示消息丢失的背后故事,帮助读者了解如何有效地防范和处理在Kafka中可能发生的消息失踪事件,确保流数据的可靠性。
设备数据最麻烦的地方,不是某一天突然写入一批数据,而是每秒都会有新数据进来。温度、压力、振动、电流、流量等指标不断产生,设备数量增加后,数据量几乎只会单向增长。业务页面通常只问两类问题:某台设备最近一小时的曲线,以及一批设备在某个时间段内的统计结果。数据库管理员面对的却是另一组问题:表拆到什么粒度,索引建在哪些表上,旧数据如何清理,新增设备是否需要发布脚本。传统时序数据库方案经常把这些事情交给应用
玩小主机时间久了,很容易遇到一个挺纠结的问题。装飞牛 NAS 吧,一台 N5105 只跑文件存储,总觉得硬件还有不少余量;改成软路由,又会舍不得 NAS;偶尔还想装个 Windows、Ubuntu 跑点服务,总不能每增加一个需求,就再买一台机器回来。先把 N5105 变成一台虚拟化主机,再把不同系统分别装进去。这里用到的是 ESXi 7.0。ESXi 负责管理底层硬件和虚拟机,在它上面先部署一套飞
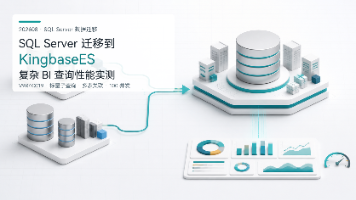
SQL Server 数据迁移进入验收阶段后,业务侧问得最多的并不是表迁完了没有,而是报表还能不能像原来一样用。简单查询跑通只能证明连接、对象和基础语法没有问题,真正压在项目组心里的,是那些已经运行多年的 BI 查询:表多、统计口径复杂,SQL 中还夹着标量子查询,一到月初或者经营分析会就会同时涌入大量请求。这次迁移的目标环境是 KingbaseES V9R4C019。
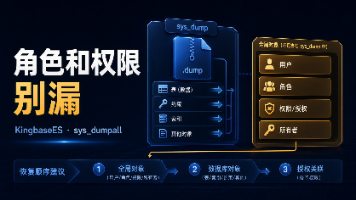
sys_dump只导一个库里面的东西,角色、表空间这些全局对象不在里头。这句话听着抽象,真出事是这样的——单库备份文件好好的,校验也过了,换台机器一还原,ksql备份没坏,数据也没丢,问题出在备份的边界上。表的 owner 是某个角色、某张表的查询权限授给了另一个角色,这些「引用」都老老实实备进了单库文件里;可被引用的角色本身,不归sys_dump管。新机器上没这俩角色,还原走到那一句就崩了。这篇
搜索引擎、网盘、工作平台、NAS应用和管理后台混在一起,每次使用都要重新查找对应入口。Fenrus是一套可以自行部署的个人导航页。它能够将常用网站按照分组集中展示,并提供搜索入口、不同页面布局和账号管理功能,适合作为浏览器首页或NAS服务导航页使用。将Fenrus部署在极空间后,可以把导航配置保存在自己的设备中。登录页面后,可以切换经典、Heimdall和列表等展示方式,再根据使用习惯添加搜索引擎