


- @OpenBayes


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
1. 进入 Demo 页面后,首先在「Identity Image」处上传包含人脸的照片,然后输入 Prompt,并在「Model Version」处选择模型版本,这里默认使用「aes_stage2」以获得更好的图文对齐和生成效果,如需更高的 ID 相似度,请尝试「sim_stage1」。3. 选择「NVIDIA RTX A6000」以及「PyTorch」镜像,OpenBayes 平台提供了 4

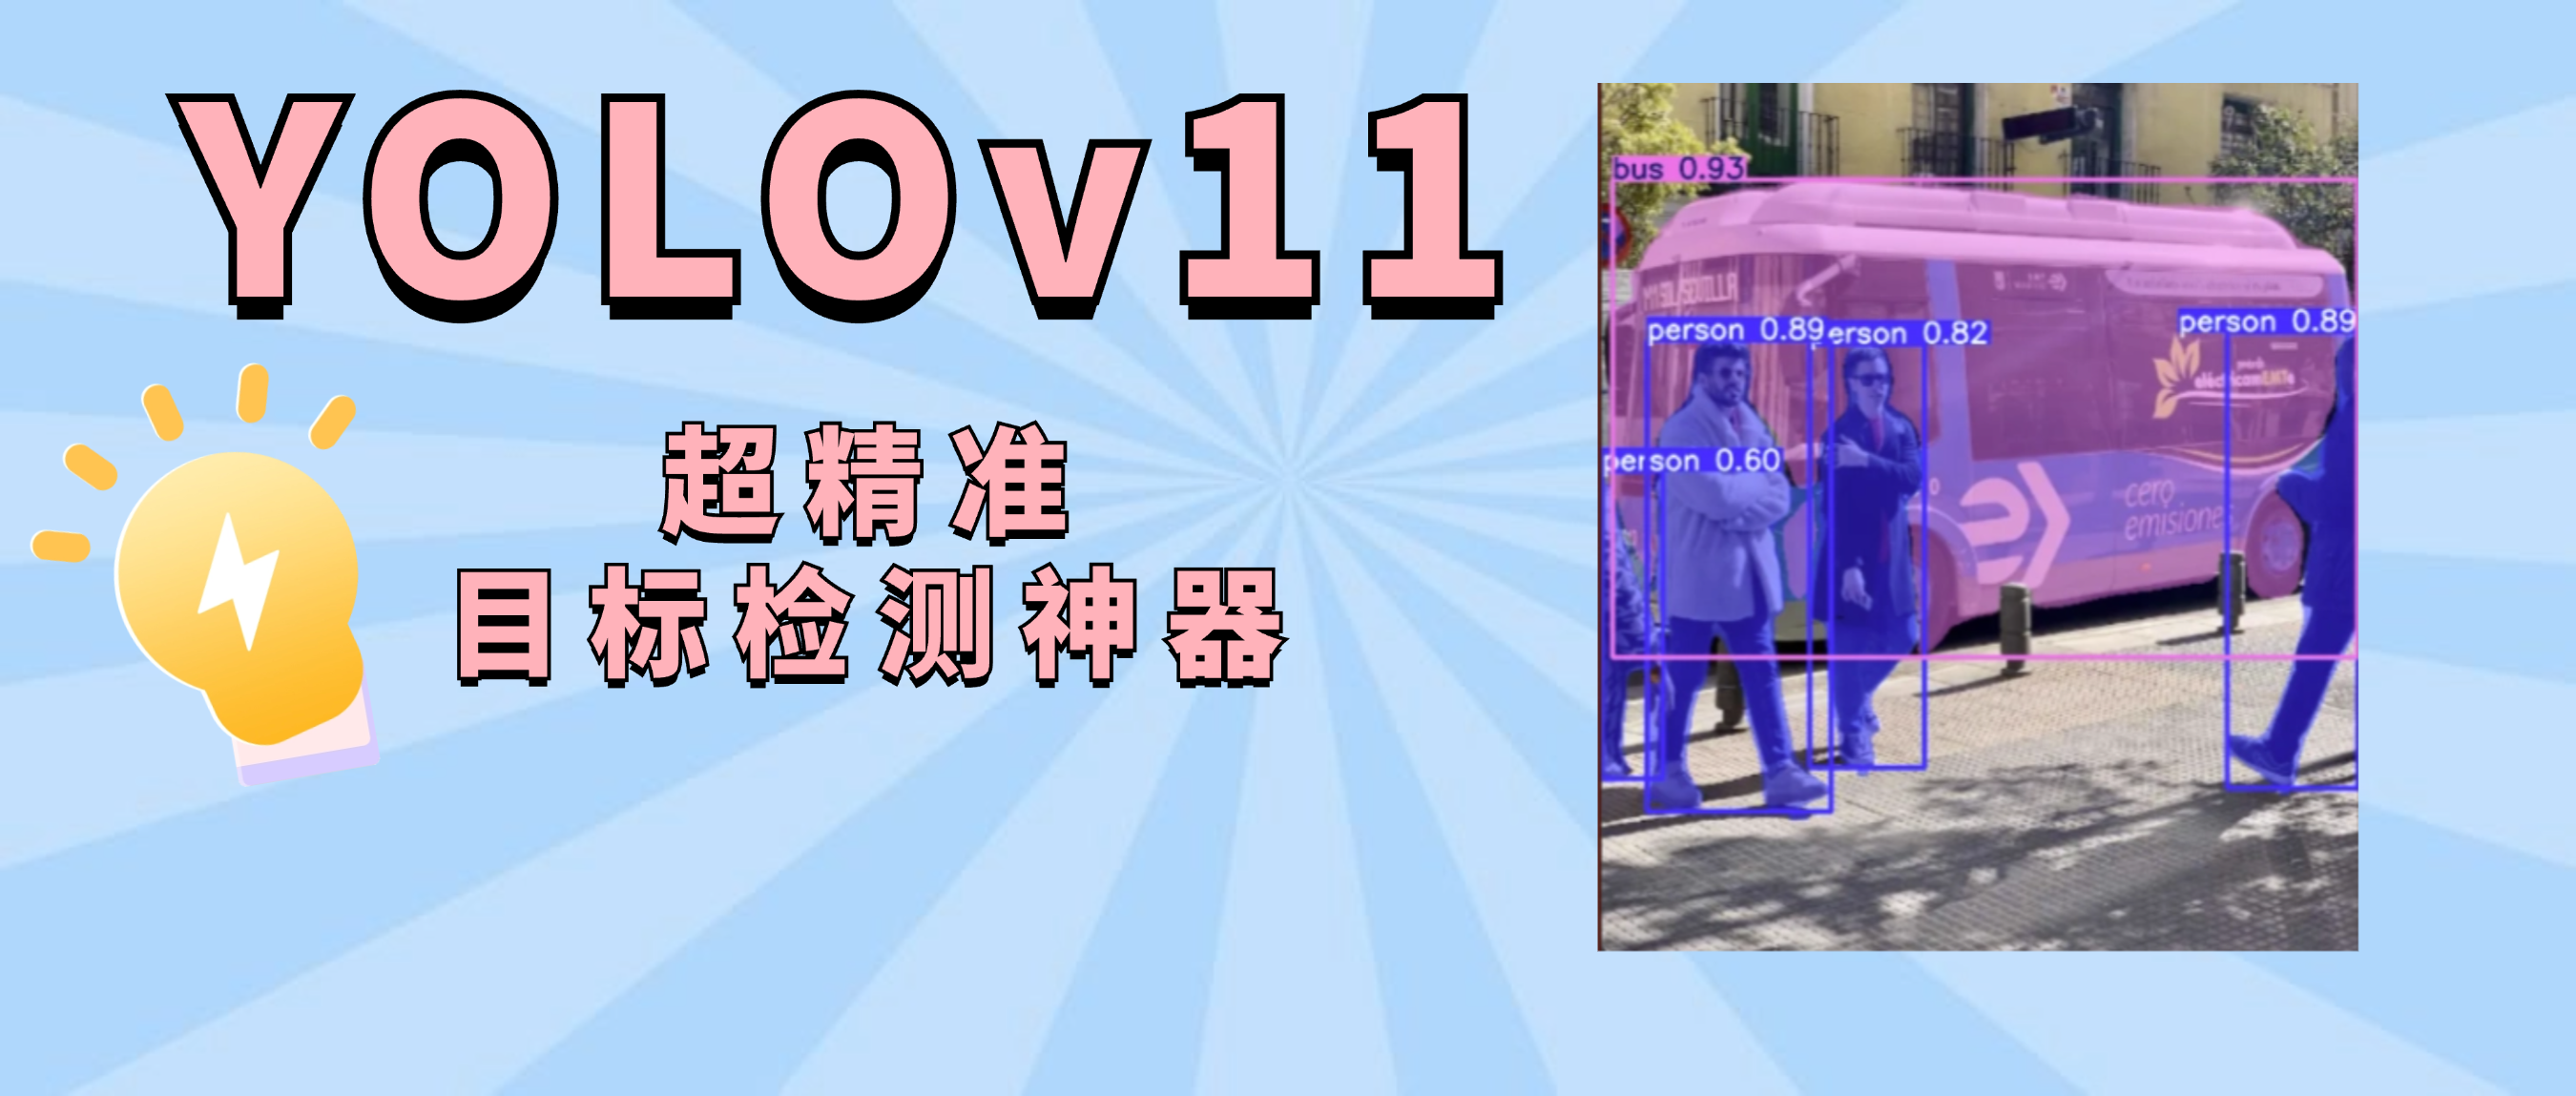
YOLO 模型一直是目标检测的经典之选。YOLOv11 作为新一代的目标检测模型,YOLOv11 能够同时完成多个视觉任务:从基础的物体检测和物体分类,到精细的实例分割,甚至能通过姿态估计分析人体或物体的动作。同时,YOLOv11 在定位物体检测方面也表现出色,能够精准地定位并识别图像中的目标,满足更复杂场景的需求。例如,在自动驾驶中,它不仅能精准识别前方车辆和行人,还能准确定位车道线和交通标志,
OpenBayes 新春福利「龙」重登场!即日起至 2024 年 2 月 29 日 23:59,购买 9.9 元龙年福袋,即可获总价值为 99 元的多种算力资源!
该模型旨在统一处理文本、图像、视频等多模态数据的理解与生成任务。MedGemma-4b-it 专为医疗图像与文本的联合分析设计,采用了 SigLIP 图像编码器,该编码器经过专门预训练,使用的数据涵盖去标识化的医学图像,包括胸部 X 光、皮肤病图像、眼科图像和组织病理切片。该模型在推理基准测试中表现出强大的性能,可与 DeepSeek-R1、Qwen3-235B-A22B、Seed1.5-Thin
DeepSeek-R1-0528-Qwen3-8B 参数量为 80 亿,通过将 DeepSeek-R1-0528 的复杂推理能力蒸馏到较小的 Qwen3-8B 基座模型上,融合了 Qwen3 的多语言能力和 DeepSeek-R1 的推理优化,性能媲美 GPT-4,支持单卡高效部署,是学术与企业应用的理想选择。Nanonets-OCR-s 能识别文档中的多种元素,比如数学公式、图片、签名、水印、复

本文介绍了5个公共数据集和5个AI相关教程资源。数据集包括遥感图像、智能体推理、文档解析、记忆压缩和食品检测等专业领域,涵盖多模态数据和应用场景。教程资源覆盖神经网络构建、视频目标跟踪、大模型应用、图像生成和扩散模型等热门AI技术,提供从基础到进阶的学习路径。

摘要:LeggedGym 是基于 IsaacGym 开发的强化学习仿真框架,通过深度封装 PPO 等算法大幅降低腿足机器人控制开发门槛。该框架支持7类机器人控制任务,包括四足机器狗(A1 / Anymal 系列)在平地和粗糙地形的步态生成、双足机器人(Cassie / PF2)行走等高难度任务,开发者只需专注奖励函数设计即可快速验证算法。
该数据集包含多种环境、光照条件和视角下的车辆图像,图像预处理为 416×416 分辨率,适用于 YOLO、SSD 和 RetinaNet 等现代目标检测模型提供COCO、YOLO、Pascal VOC 和 TensorFlow 格式的多种注释格式,兼容多种机器学习框架,包含平衡的训练/验证/测试分割,以评估模型性能。该数据集通过将每张图像转化为结构化的数值特征,包括全局强度统计、纹理描述符(GLC

基于视觉-语言预训练框架的系统,如 OpenAI 推出的 GPT-4V(Vision 版本),以及 Google 的 Gemini 系列,都展示了在文档理解、表格解析、复杂版式分析方面的强大能力。不同于传统的级联式 OCR 模型(检测 + 识别),LightOnOCR-2-1B 强调端到端处理能力,能够直接将像素映射为结构化文本,支持多语言识别以及表格、公式等结构化内容的提取。此外,在保持 0.9
