- @AIGCer


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
解决的问题:现有的视觉-语言-动作(VLA)模型在推理速度慢和需要大量机器人数据进行预训练方面面临挑战,限制了实际应用。提出的方案:引入一种新型紧凑型视觉-语言-动作模型TinyVLA,提供更快的推理速度和更高的数据效率,消除预训练阶段的需求。应用的技术:TinyVLA框架包括两个关键组件:1) 使用高效的多模态模型初始化策略骨干;2) 在微调过程中集成扩散策略解码器,以实现精确的机器人动作。达到

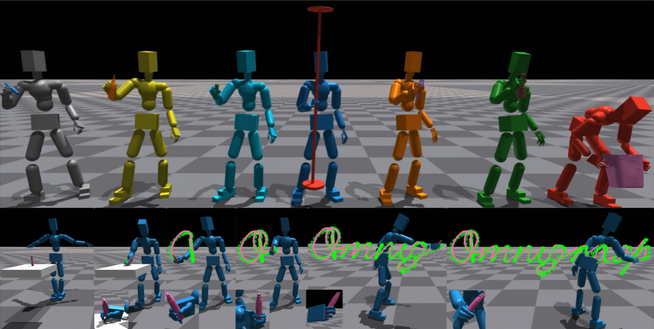
尽管Omnigrasp展示了控制模拟人形机器人抓取各种物体并在保持物体的同时跟随全方向轨迹的可行性,但仍然存在许多限制。例如,尽管输入和奖励中提供了6自由度(6DoF)输入,系统在旋转误差方面仍需进一步改进。Omnigrasp尚未支持精确的手内操作。轨迹跟随的成功率可以提高,因为物体可能会掉落或无法被拾起。另一个改进领域是实现对物体的特定类型抓取,这可能需要额外的输入,例如所需的接触点和抓取方式。
文章链接:https://arxiv.org/pdf/2405.14093本综述是关于具身智能领域中新兴的视觉-语言-动作模型的首次全面回顾。对具身智能领域中涌现的VLA模型进行了全面回顾,涵盖了架构、训练目标和机器人任务等各个方面。引入了当前机器人系统的分层结构分类法,包含三个主要组件:预训练、控制策略和任务规划器。预训练技术旨在增强VLAs的特定方面,如视觉编码器或动力学模型。低层次控制策略根

MetaVLA:高效多任务协同训练的视觉-语言-动作模型后训练框架 本文提出MetaVLA框架,针对当前视觉-语言-动作(VLA)模型存在的任务依赖性强、计算成本高和泛化能力弱等问题,通过元学习协同训练机制实现高效后训练。该框架采用基于注意力神经过程(ANP)的记忆增强模块Meta-Action-Reasoner,集成多样辅助任务提升泛化性,同时保持主干架构无关性。

解决的问题多模态大语言模型(MLLMs)在支持多任务方面缺乏统一性,特别是图像和视频的联合处理能力不足。模型在细粒度像素级理解上存在局限,无法实现高精度的视觉区域定位与编辑。视觉功能单一,难以支持从视觉理解到生成、分割、编辑等全方位任务。多任务间存在协作性不足,任务间可能互相影响,难以实现统一优化。**提出的方案 **统一架构设计:VITRON 采用基于 LLM 的框架,前端集成图像、视频和像素级

本文探讨了阴影分析中的开放问题,重点关注图像和视频感知、编辑以及对AIGC和大型视觉/语言模型的影响。本文的见解建议了未来的研究方向,为阴影分析及其应用的进展提供了路线图。

区分不同LLM生成的文本:研究旨在识别和区分不同大型语言模型(LLM)生成的文本,揭示各模型的独特输出模式。理解LLM的独特行为:通过分析LLM生成的文本,探讨这些模型的独特行为及其在语义层面的表现。

医学领域的推理能力尚未被充分探索,尽管其重要性与数学领域相似。医学推理的验证比数学更具挑战性,需要可靠的答案来满足高标准的医疗保健需求。

身份失真:现有方法在动画生成过程中难以保持人物身份的稳定性,导致身份信息泄露或扭曲。背景不稳定:动画生成时背景容易出现抖动或不一致的现象。面部表情不真实:特别是在仅头部动画的场景中,面部表情缺乏真实感。全身动画的挑战:当动画扩展到全身时,现有方法容易产生视觉伪影或不自然的动作。身份与运动融合的困难:现有方法难以在保持身份一致性的同时,实现细腻的表情和动作生成。给定输入视频序列和参考肖像图像,从视频
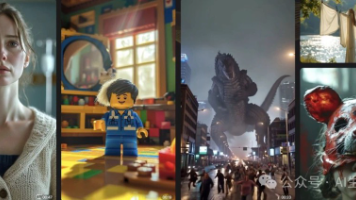
人工智能在文本、图像和声音的创意内容生成方面已经决定性地扩展了其应用范围。在视觉领域,扩散模型被广泛用于图像生成和修改。开源项目如Stable Diffusion在文本转图像方面取得了显著进展。然而,在视频生成方面,当前模型仍面临一些挑战,如质量欠佳、视频长度有限以及运动不自然,这表明该技术还有很大的进步空间。一些开创性的研究在利用Stable Diffusion方法进行视频合成方面取得了进展,重