- @weixin_74085818


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
22级本科生博主开启系统刷题计划,聚焦力扣题库与"代码随想录"学习笔记。内容涵盖PyTorch和C++技术探索,分享算法解题心得,目前已发布数组专题解析。博主以"寻找理想的天空之城"为格言,在编程学习中追求成长与突破。博客主页持续更新力扣刷题系列,包含往期数组典型题目详解,为读者提供实用算法学习资源。
串:是一种特殊的线性表,它是由字符组成的,是由零个或多个字符组成的有限序列。一般记为:S = “a1a2a3……an” (n≥0)如:A= “BEIJING”, B= “JING”

LS=(a1,a2,a3,…,an其中,LS是表的名称,n是表的长度。在线性表的定义中,ai(1

大括号 量词符重复次数中括号 字符集合任选一小括号 优先级// 中括号// 大括号// 它只是让c 重复3次 abccc// 小括号//它是让 abc 重复3次在线测试正则表达式:https://c.runoob.com/一项脚本语言的标准。
一般的抽象系统,如社会系统、经济系统、农业系统、生态系统、教育系统等都包含有许多种,多种因素共同作用的结果决定了该系统的发展态势,其中,哪些是主要因素,哪些是次要因素;曲线越接近,相应序列之间的关联度就越大,反之就越小。p,分辨率大小,一般取0.4,0.5,0.6,越大,更关注指标差异性,越小,更注重指标相关性。根据加权关联度大小,对各评价对象进行排序,可建立评价对象的关联序,关联度越大,评价结果

VGG16模型本次实验VGG16模型修改冻结前13层卷积,只修改全连接在全连接层前添加BN层、全局平均池化层,起到降维作用,因为VGG16的计算量很大全连接层中添加Dropout层修改后代码:# 导入官方VGG16模型# 冻结卷积权重# 获取卷积层输出# 添加BN层# 添加平均池化,降低计算量# 添加全连接层和Dropout# 创建模型结果最好结果,个人感觉想要继续提升精度,最简单方法,是结合Re

target与chol、没有什么相关性,fbs是分类变量,chol胆固醇是数值型变量,但是从实际角度,这些都有影响,故不剔除特征。其中分类变量为:sex、cp、fbs、restecg、exang、slope、ca、thal、target。数值型变量:age、trestbps、chol、thalach、oldpeak。测试集表现不是很理想,合理尝试变化不同的批次,会有不同效果。这里先划分为:训练集:

ppa地址在国外,下载会很慢,故可以换成国内的源。输出Hello world!:需要在root用户下操作才能成功。

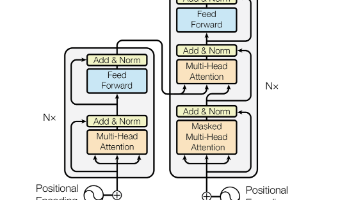
精读transformer论文
本文介绍了Ollama本地大模型部署工具的使用方法。主要内容包括:下载安装Ollama(版本0.16.3)、部署轻量级qwen3:0.6b模型、运行与退出操作。重点讲解了Ollama提供的API接口,包括聊天对话、文本向量化、模型管理等8个核心接口的调用方法和Python示例代码,特别详细说明了/chat和/embeddings接口的使用场景和请求格式。文章还提及了因硬件限制选择小模型的考虑,为本