- @m0_59163425


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
在本地终端环境中,开发者早已习惯使用 Claude Code、Cursor 或各类命令行 Agent 进行自主编码与系统运维。模型推理循环与操作系统的 Shell、文件系统和环境变量运行在同一台宿主机上,通过本地进程树与内存字典直接驱动。这种“脑与手同机”的拓扑,在个人开发机上极其高效,因为单机操作系统天然屏蔽了网络故障域、进程隔离与多租户审计的复杂性。

大型语言模型(LLMs)在复杂任务中展示了令人印象深刻的推理能力。然而,它们缺乏最新的知识,并在推理过程中出现幻觉,这可能导致不正确的推理过程,从而降低其性能和可信度。知识图谱(KGs)以结构化格式捕捉大量事实,为推理提供了可靠的知识来源。然而,现有的基于KG的LLM推理方法仅将KG视为事实知识库,忽视了其结构信息在推理中的重要性。在本文中,我们提出了一种新方法,称为图上推理(RoG),它将LLM

链接:https://arxiv.org/abs/2404.14777v2原标题:ClinicalAgent: Clinical Trial Multi-Agent System with Large Language Model-based Reasoning。

大型语言模型 (LLM) 作为近年来人工智能领域的明星技术,以其强大的文本生成、翻译、问答等能力,吸引了广泛的关注。然而,LLM 并非魔法,其能力的发挥很大程度上取决于我们如何与之“沟通”,即如何编写有效的 Prompt。想象一下,LLM 就像一位技艺精湛的画家,而 Prompt 则是你提供的画布和颜料,以及对作品的期望描述。Prompt 的质量直接影响着最终作品的风格和效果。因此,优化 Prom

这个人从未学过编程,但由于热衷于游戏,于是在玩了十个小游戏后,就学会了python编程,他的老师说,也许是因为他在这方面太有天赋吧!首先这十个游戏是来自某份教程,而且是那种在这份教程中,没有冗长枯燥的理论,一切都是以趣味为前提,一切都用游戏带python学习者深入其中,换句话说,那么这到底是什么游戏呢?这份教程,每个知识点,都对应了一个游戏,总共十个,而只要学会这十个知识点,python基础就基本
大模型方向面试,和传统后端面试完全不一样。后端八股背完就能说,大模型面试你得**真做过项目、真踩过坑**,面试官一追问细节就露馅。录友们经常问我:大模型面试到底考什么?Agent、RAG、Transformer这些方向,每个都有一堆题,怎么准备?

你写了不少SKILL,但有没有遇到过这些情况:Token消耗巨大可输出质量不稳定?Agent该问的时候不问,不该猜的时候瞎猜?输出的格式一次一个样,团队根本没法复用?
**让我们来讲一个故事**今天和女朋友吵架了,(假设你有女朋友)。今晚又是一个人睡沙发,这天晚上,你躺在沙发上,夜不能寐因为--------

在信息爆炸的时代,推荐系统帮助用户发现符合个人兴趣的内容。传统的推荐系统主要依赖用户和项目的历史数据,而新兴的多模态推荐系统能够利用文本、图像、音频和视频等多种类型的数据,提供更丰富、更准确的个性化推荐。这项研究有助于推动推荐系统的发展,使其能够更好地理解和预测用户的喜好。个性化推荐作为用户发现信息或根据其兴趣定制项目的一种普遍渠道。然而,传统推荐模型主要依赖于唯一ID和分类特征进行用户-项目匹配

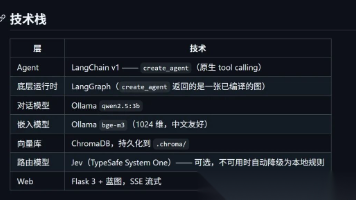
本地化部署小模型通常智力水平低,模型稳定性差,边缘设备输出token过慢。jev模型,一款垂类的决策模型,区别于传统大模型,该模型不能生成文本,只能用于决策 ,但该模型响应更快,稳定网络情况下通常 100~300 毫秒左右。