登录社区云,与社区用户共同成长
邀请您加入社区
2026 年 9 月,信创数据库大单像开了闸一样密集落地。江苏银行 1884 万采购国产数据库服务器,海光和鲲鹏 CPU 成标配。杭州市"全市信创一朵云"项目预算 1.5675 亿元。上海航空工业 205.82 万采购国产集中式数据库。江西洪都商用飞机 98.8 万采购国产数据库系统。北京市农业农村局 148.75 万采购金仓数据库。中央政府采购数据库框架协议结果正式出炉。这些大单不是孤立事件,它
本文详细介绍了MySQL 8.0主从同步与读写分离的实现方案。附录包含网络拓扑建议和详细参数说明,为数据库高可用方案提供实践参
本文探讨了多租户系统中的数据库架构设计方案,分析了四种典型架构的优缺点和应用场景。架构1是单数据库简单方案,架构2通过ORM库对接多个数据库提升扩展性,架构3采用多ORM库对接动态数据库,架构4结合微服务实现租户隔离。文章指出架构选择需考虑安全性、性能、扩展性等因素,多租户系统需处理逻辑/物理隔离、多样性管理、迁移复杂性等问题。建议根据业务需求选择合适架构,并利用连接池等技术优化性能。系统架构设计
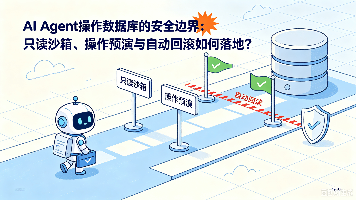
当AI Agent从“只读查询”走向“自主变更”,数据库的安全模型需要重新设计。人类DBA执行DELETE前会反复确认,Agent可能因为一个理解偏差直接执行。本文拆解Agent操作数据库的三层安全机制——只读沙箱隔离风险、操作预演预判影响、自动回滚兜底失误,给出可落地的安全框架。
是一个开源的分布式数据库中间件,提供了数据库的分库分表、读写分离、数据分片等功能。分库分表:可以将数据按照一定规则分散到不同的数据库或表中,实现数据的水平切分,提高数据库的扩展性和性能。读写分离:可以根据需求将读操作和写操作分发到不同的数据库节点,实现读写分离,提高数据库的负载能力。数据分片:可以按照某种特定的规则将数据分散到不同的数据库节点上,并通过统一的接口对外提供访问,实现数据的分布式存储。
一、库分表在redis,memcached等缓存系统盛行的互联网时代,构建一个支撑每秒十万只读的系统并不复杂,无非是通过一致性哈希扩展缓存节点,水平扩展web服务器等。支付系统要处理每秒十万笔订单,需要的是每秒数十万的数据库更新操作(insert加update),这在任何一个独立数据库上都是不可能完成的任务,所以我们首先要做的是对订单表(简称order)进行分库与分表。在进行数据库操作时,一般都会
Spring Boot + Mybatis 多数据源配置实现读写分离应用场景:项目中有一些报表统计与查询功能,对数据实时性要求不高,因此考虑对报表的统计与查询去操作slave db,减少对master的压力。根据网上多份资料测试发现总是使用master数据源,无法切换到slave,经过多次调试修改现已完美通过,现整理下详细步骤和完整代码如下:实现方式:配置多个数据源,使用Spring AOP...
主从复制的两种形式1)基于文件的日志传送创建一个高可用性(HA)集群配置可采用连续归档,集群中主服务器工作在连续归档模式下,备服务器工作在连续恢复模式下(1台或多台可随时接管主服务器),备持续从主服务器读取WAL文件。连续归档不需要对数据库表做任何改动,可有效降低管理开销,对主服务器的性能影响也相对较低。直接从一个数据库服务器移动WAL记录到另一台服务器被称为日志传送,PostgreSQL通过一次
一. 简介 1. 版本springboot版本为2.0.3.RELEASE,mybatisplus版本为2.1.9, druid版本为1.1.9,swagger版本为2.7.02.项目地址 该地址有初始sql和测试方法 3. 留个记录,方便查找 开发步骤: 1. 新建springboot项目。 2. 导入依赖 --> devtools,lombok,web,thymele
采用三台真实的部署在公网的服务器(系统为centos)搭建hadoop集群。(两台腾讯云,一台阿里云)包含jdk,hadoop的安装,配置环境变量,配置hadoop配置文件,初始化,启动。云服务器搭建hadoop集群。hadoop cluster cloud。
数据库架构不是选个库就完事。结合踩坑经历,讲清楚架构是什么、怎么演进、三层设计法怎么用、存储选型怎么避坑。
分库分表通常不是系统一开始就要做的事情,而是在核心表数据量、写入吞吐、查询延迟、索引体积和历史数据归档逐渐成为瓶颈后,需要认真评估的一类架构改造。本文结合响应式技术栈下的预研过程,整理 WebFlux + R2DBC 场景中如何判断是否需要分库分表、如何选择 ShardingSphere-Proxy 或自研路由、如何设计时间分片和哈希分片、如何处理跨分片查询、分页排序、全局 ID、分布式事务,以及
PostgreSQL全文检索系统搭建指南 摘要:本文详细介绍如何利用PostgreSQL内置的全文检索功能构建搜索系统。文章首先解析了全文检索的核心概念,包括文档向量(tsvector)和查询向量(tsquery)的转换原理,以及二者的匹配机制(@@操作符)。接着通过实例演示了创建支持全文检索的数据表,包括预计算tsvector列、建立GIN索引和自动更新触发器。最后讲解了实际的搜索实现,涵盖基本
doris
中科晟达注塑机智能管控系统以数据驱动为核心,帮助注塑企业实现设备互联、生产协同和质量可控。未来,系统将进一步融合人工智能算法,在工艺优化、预测性维护和智能排产等方向持续深化,助力企业迈向智能制造。
其中,helper_fe_ip 为当前 FE 集群中任一存活的节点。vim /opt/doris/apache-doris-3.1.2-bin-x64-noavx2/fe/conf/fe.conf 文件 修改成以下配置。## fe_edit_log_port 可以从 fe.conf 中查看,默认为 9010。在启动其它的 FE 节点前,需要先在 FE 集群中注册新的 FE 节点。在启动新的 BE
本文深入解析天外客AI翻译机的数据库架构,通过读写分离与分库分表策略应对高并发和大数据量挑战。采用MySQL主从复制分流读写压力,结合ShardingSphere实现用户ID哈希分库与时间分表,显著提升查询效率与系统吞吐能力,支撑全球百万级用户低延迟访问。
第一、postgresql数据库的膨胀问题例如,其多版本并发控制(MVCC)机制虽然提升了读并发性能,但也可能带来存储空间需要定期通过 VACUUM等操作进行维护的考虑其实这个存储空间,也就是表膨胀,索引膨胀,wal日志膨胀这几个膨胀对于运维工作来说,是非常不友好的表膨胀和索引膨胀对于postgresql数据库的性能来说,影响是非常巨大的,并且这两个膨胀是没有限制的,也就是说,如果发生了表膨胀而你
摘要:TDengine作为国产开源时序数据库,在性能、架构、成本等方面展现出显著优势。TSBS测试显示,其写入速度达2.1M点/秒,查询性能比竞品快5-68倍,压缩比达18:1。创新架构采用"一个设备一张表"设计和超级表模型,结合内置流式计算,使系统复杂度降低60%。在实际应用中,TDengine可降低70%硬件成本,减少75%运维人力。3.0版本通过原生分布式架构升级,实现线
分析每种个体存在多少种不同的关系,将这些关系分为不同的集合,最后通过并查集维护。欢迎指出疏漏。
《构建高并发Go+MySQL数据库层的核心实践》 本文分享了支撑日均亿级请求的Go+MySQL数据库层设计经验。关键点包括: 连接池管理:正确配置MaxOpenConns(100-200)、MaxIdleConns(20-30%最大连接数)和ConnMaxLifetime(1小时)等参数,平衡性能与资源消耗。 安全CRUD操作:严格使用预处理语句防止SQL注入,推荐使用go-zero框架自动生成安
系统采用Spring Boot框架进行后端开发,结合MySQL数据库实现数据的有效存储,并利用协同过滤算法在首页提供精准的饮食推荐。此外,系统支持病人信息、饮食数据等多方面的管理,确保了平台资源的高效运作与维护。通过这一平台,不仅病人可以获得更加科学合理的饮食指导,而且各角色用户均能体验到便捷的操作流程和优质的服务,极大地提升了整体系统的效率与用户体验。
本文深入探讨MySQL读写分离架构下的核心挑战与实战解决方案。文章详细解析了Sharding-JDBC的配置要点与路由机制,并重点剖析了主从延迟导致的典型业务陷阱,如“写后立即读”和“读后写”场景。同时,提供了基于HintManager的强制路由、业务层补偿设计以及构建完整监控告警体系等实战处理方案,帮助开发与运维人员有效规避数据一致性问题。
pache Hudi(发音为 “Hoodie”)是一个开源的数据湖管理框架,全称为Hadoop Upserts Deletes and Incrementals。它旨在简化增量数据处理,为数据湖提供 ACID 事务支持、高效的更新删除操作、数据版本管理和增量数据查询等核心能力。简单来说,Apache Hudi 就像是数据湖的 “管理员”,它让原本杂乱无章的 “数据沼泽” 变得有序可控,让开发者能
GaussDB SQL执行计划是SQL调优的核心部分,如何分析SQL执行计划在本文中着重详细描述。
微博数据库技术负责人杨尚刚将从技术选型、方案设计到落地实践等维度,深度解析这场关乎亿级用户体验的数据库进化之路。
RocksDB通过ColumnFamilyData实现表级隔离,每个列族独立管理MemTable、Immutable MemTable和SST文件。借用MVCC机制,Version管理不同时刻SST文件分布,实现读写并发控制。SuperVersion包含MemTable、Immutable MemTable和Version,确保查询一致性
库存管理是企业供应链的核心环节,其数据体系直接影响运营决策效率。然而,企业数据仓库的构建常面临模型设计混乱、数据孤岛、口径不一致等痛点。本文以库存管理为切入点,系统解析数据仓库的模型设计方法、总线架构落地实践及数据治理核心策略,为企业提供可落地的解决方案。记录每次库存操作(入库、出库、调拨、报损),核心字段包括:设计要点:按天/周粒度记录库存静态状态,解决高频查询性能问题:优化策略:适用场景:分析
MySQL数据库进阶学习笔记分享-内容超级齐全-简单易懂!!
在数据飞轮模型中,数据不仅被收集和存储,而且被不断地用于驱动业务流程的优化、创新和增长。更重要的是数据飞轮则是在此基础上,指出数据消费的重要,并提供配套的便捷、易用的数据消费工具,帮助企业形成数据应用和业务价值提升的良性循环。这个枢纽站就像是数据的集中管理和整合中心,将不同来源的数据集中起来,进行清洗、归类和整合,以便可以高效地供各个业务部门使用。而数据飞轮则可以想象为一个共享单车系统,单车(数据
当表 的数据量大到一定程度时, 分区也不太好解决问题,此时就要拆分表结构,把一张表拆分成多张表,查询的时候根据拆分表的方式去相应的表中查询数据。,因为在单表中我们可以用数据库主键做唯一 ID ,但是如果做了分库分表,多张单表中的自增主键就会发生冲突。但是不管什么算法,都要保证一个前提,那就是同一个分表字段,经过这个算法处理后,得到的结果一定是一致的,不可变的。一致性哈希可以将常用的 hash 算法
(1)数据中台直接产出的核心指标必须实施强管理,由数据中台团队的专人或者小组负责,最好是数据产品经理的角色。(2)指标的管理必须结合系统+规范的治理方法,明确每个角色的职责,通过系统化的方法实现。(3)不同的两个指标描述的相同业务过程中的相同事实部分口径不一致,是指标梳理过程中最常见的问题,需要通过拆分原子指标和派生指标的方式解决。
本文的整个变更过程中,变更是围绕库分组进行的,库分组可以根据企业的实际业务场景自由添加,具有非常高的通用性,并且操作十分便利,因此可以适用于各种分库变更的场景。而对于上文中提到的几个变更难题,NineData 的库分组解决方案都可以轻松化解,从此分库变更只需点几下鼠标就完事,不用再绞尽脑汁地写脚本了。最后补充一个新手大礼包,如果企业的数据源数量不超过 10 个,那么就可以永久免费使用上述功能,不仅
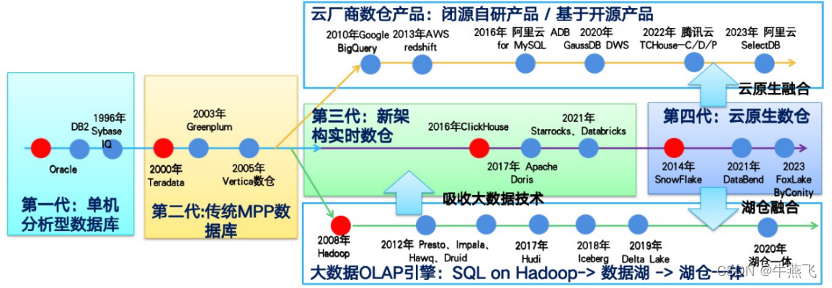
但是数据仓库从概念上看是一个面向主题、集成、相对稳定和反映历史变化的数据集合,在数据仓库中信息是在不同的业务系统中进行集成,并经过一系列加工、整理和汇总等过程,形成规范性的关于确定主题的一致的全局信息,可以对这些数据进行频繁的可重复的分析。数据仓库的演进变革的因素有很多,例如快速的业务模式与群体规模的数据量带来的大数据处理技术、互联网的发展带来的数据源及数据类型的增多、人工智能的发展带来数智的融合
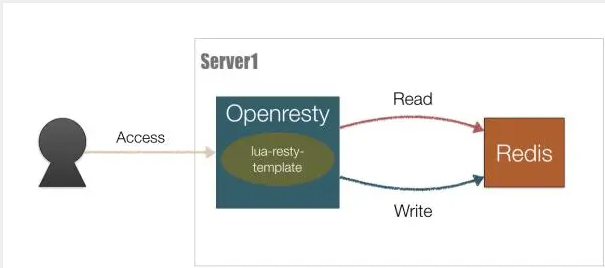
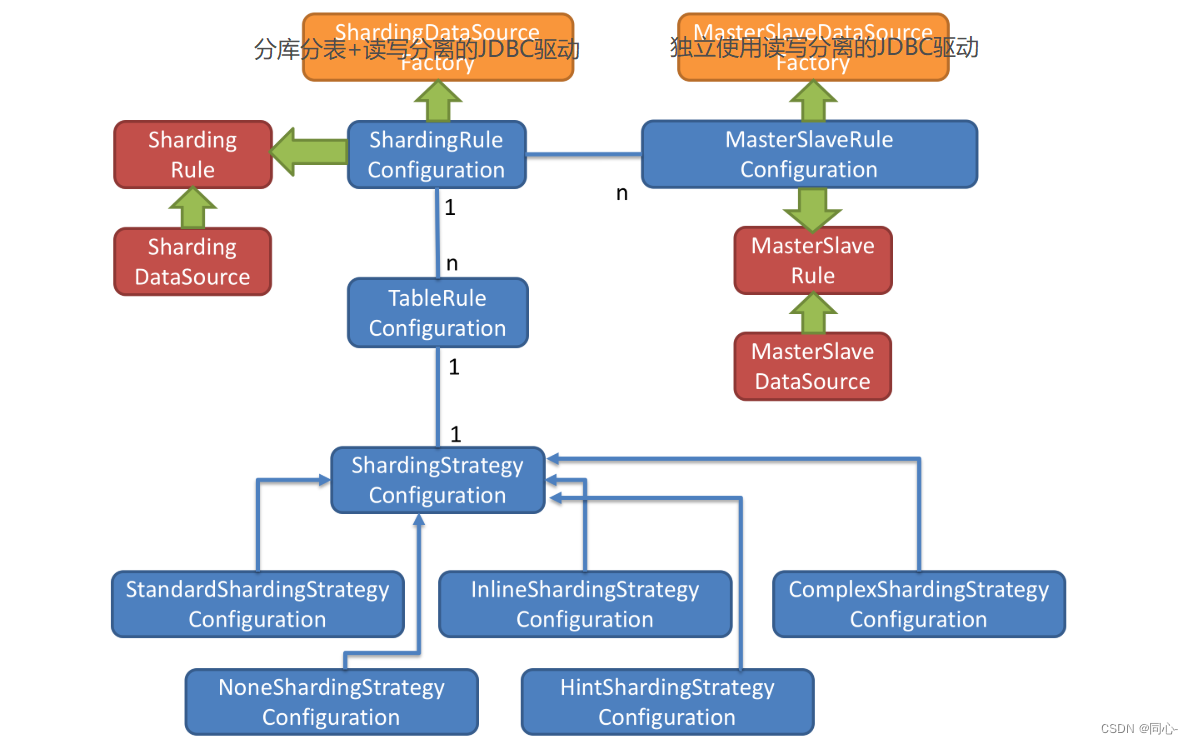
读写分离是一种常见的数据库架构,它将数据库分为主从库,一个主库(Master)用于写数据,多个从库(Slave)进行轮询读取数据的过程。主从库之间通过某种通讯机制进行数据的同步。
Apache ShardingSphere 是一款分布式的数据库生态系统, 可以将任意数据库转换为分布式数据库,并通过数据分片、弹性伸缩、加密等能力对原有数据库进行增强。
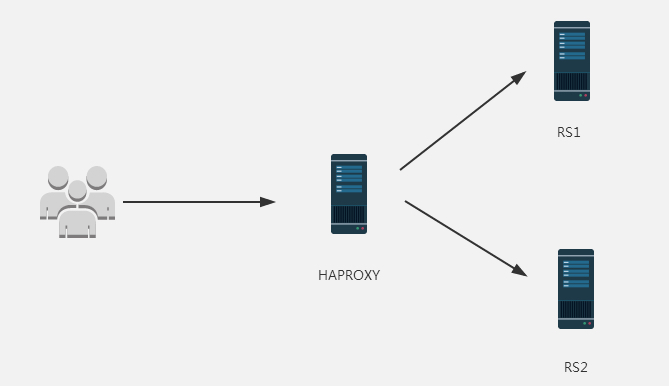
作为一名开发人员,随着经验的增加和技术的沉淀,需要提高自己架构方面的知识,同时对于一个企业来说,搭建一套高可用、高性能的技术架构,对于公司的业务开展和提高服务的性能也是大有裨益的。本文重点从软件安装和搭建tidb负载均衡数据库服务介绍下HAProxy的使用
oracle 数据库中文简体繁体乱码为什么我保存后,就变成了繁体。但是系统中还是显示简体
建表2个库,4个表-- ------------------------------ Table structure for admin0-- ----------------------------DROP TABLE IF EXISTS `admin0`;CREATE TABLE `admin0`(`id` bigint(20) NOT NULL,`role_id` bigint(20) NU
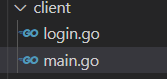
# command-line-argumentssrc\chartroom\client\main.go:46:10: undefined: login在同一个目录下,引用另外一个go文件的一个函数,不能使用。两段代码如下package mainimport(//"chartroom/ser""fmt""os")//定义两个全局变量,一个表示用户的id一个表示用户的密码var userId int
1.创作目的主要是进行一个平时开发的思路记录,便于后期进行查询。平时都在写代码,做crud,很少有时间静下来写具体的设计思路及想法,暂且把想到的都写下来,算是一种经验积累吧。2.设计思路整个平台将基于多账户、多模块的设计,暂时将账户分为3种类型:企业级账户、小微企业账户、普通账户,不同的账户拥有不同的扩展权限。在数据库方面根据不同的账户进行数据存储,企业级账户使用独享数据库、小微企业账户分表存储、
ShardingSphare5.0 proxy自定义规则定义和引用。通过继承StandardShardingAlgorithm接口来实现。在配置文件中需要通过CLASS_BASED 声明
分片算法name下划线(_)改成横杠(-)即可
seata安装1.下载seata-serverhttps://github.com/seata/seata/releases2.创建seata-server数据库及表https://github.com/seata/seata/tree/1.4.0/script/server/db3.修改seata-server的registry.conf文件#修改为如下配置registry {# file 、n
提示:文章写完后,目录可以自动生成,如何生成可参考右边的帮助文档文章目录前言一、表设计1.画像表和行为表分离2.画像&行为大宽表3.画像&行为大宽表+ 画像表二、数据库优化1.推送优化2.数据推送3.二级索引4.TTL列 TTL表 TTL删除分区三、遗留的问题前言业务背景是一个典型的电商场景,基于用户画像和用户行为的人群圈选,后续就可以进行人群的分析及打标等。提示:以下是本篇文章正
分区:对业务透明,分区只不过把存放数据的文件分成了许多小块,例如mysql中的一张表对应三个文件.MYD,MYI,frm。根据一定的规则把数据文件(MYD)和索引文件(MYI)进行了分割,分区后的表呢,还是一张表。分区可以把表分到不同的硬盘上,但不能分配到不同服务器上。优点:数据不存在多个副本,不必进行数据复制,性能更高。缺点:分区策略必须经过充分考虑,避免多个分区之间的数据存在关联关系,每个分区
炫“库”行动—人大金仓有奖征文—金仓读写分离集群优势金仓读写分离集群实现了真正的高可用。为了保障数据的安全性,金仓数据库集群由多个数据库节点通过集群软件组织起来,客户通过访问集群的VIP来访问数据。并且只要有一个数据库节点正常,就不会中断业务。同时金仓读写分离集群可以保证用户能够 7×24 小时不间断的对数据进行访问,使得客户业务能够顺利进行。金仓读写分离集群同样具有高可用、灾备、负载均衡等特性,
搭建MySql集群 Slave_SQL_Running=no解决方式MySql集群搭建扩展MySql互主集群 MySql主从架构的数据延迟问题 MySQL的高可用方案 MySql实现分库分表
1.查询数据库中的锁select * from v$lock;select * from v$lock where block=1;2.查询被锁的对象select * from v$locked_object;3.查询阻塞查被阻塞的会话select * from v$lock where lmode=0 and type in ('TM','TX');查阻塞别的会话锁select * from v
连接池配置文章目录连接池配置一、Redis连接池二、jar包准备三、编写代码配置,创建连接池,并调用处连接总结一、Redis连接池与JDBC中在与数据库进行连接时耗时,从而需要引入连接池一样。Java在与Redis进行连接也是需要时间的。所以在Java于Redis进行连接中也需要引入连接池(以空间换时间)。示例:pandas 是基于NumPy 的一种工具,该工具是为了解决数据分析任务而创建的。二、
数据库架构
——数据库架构
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 鲲鹏昇腾开发者社区

 乐奇 Rokid 开放社区


 AI Agent技术社区



 天工造物局




 亚马逊云科技技术品牌专区