- @qq_64684039


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
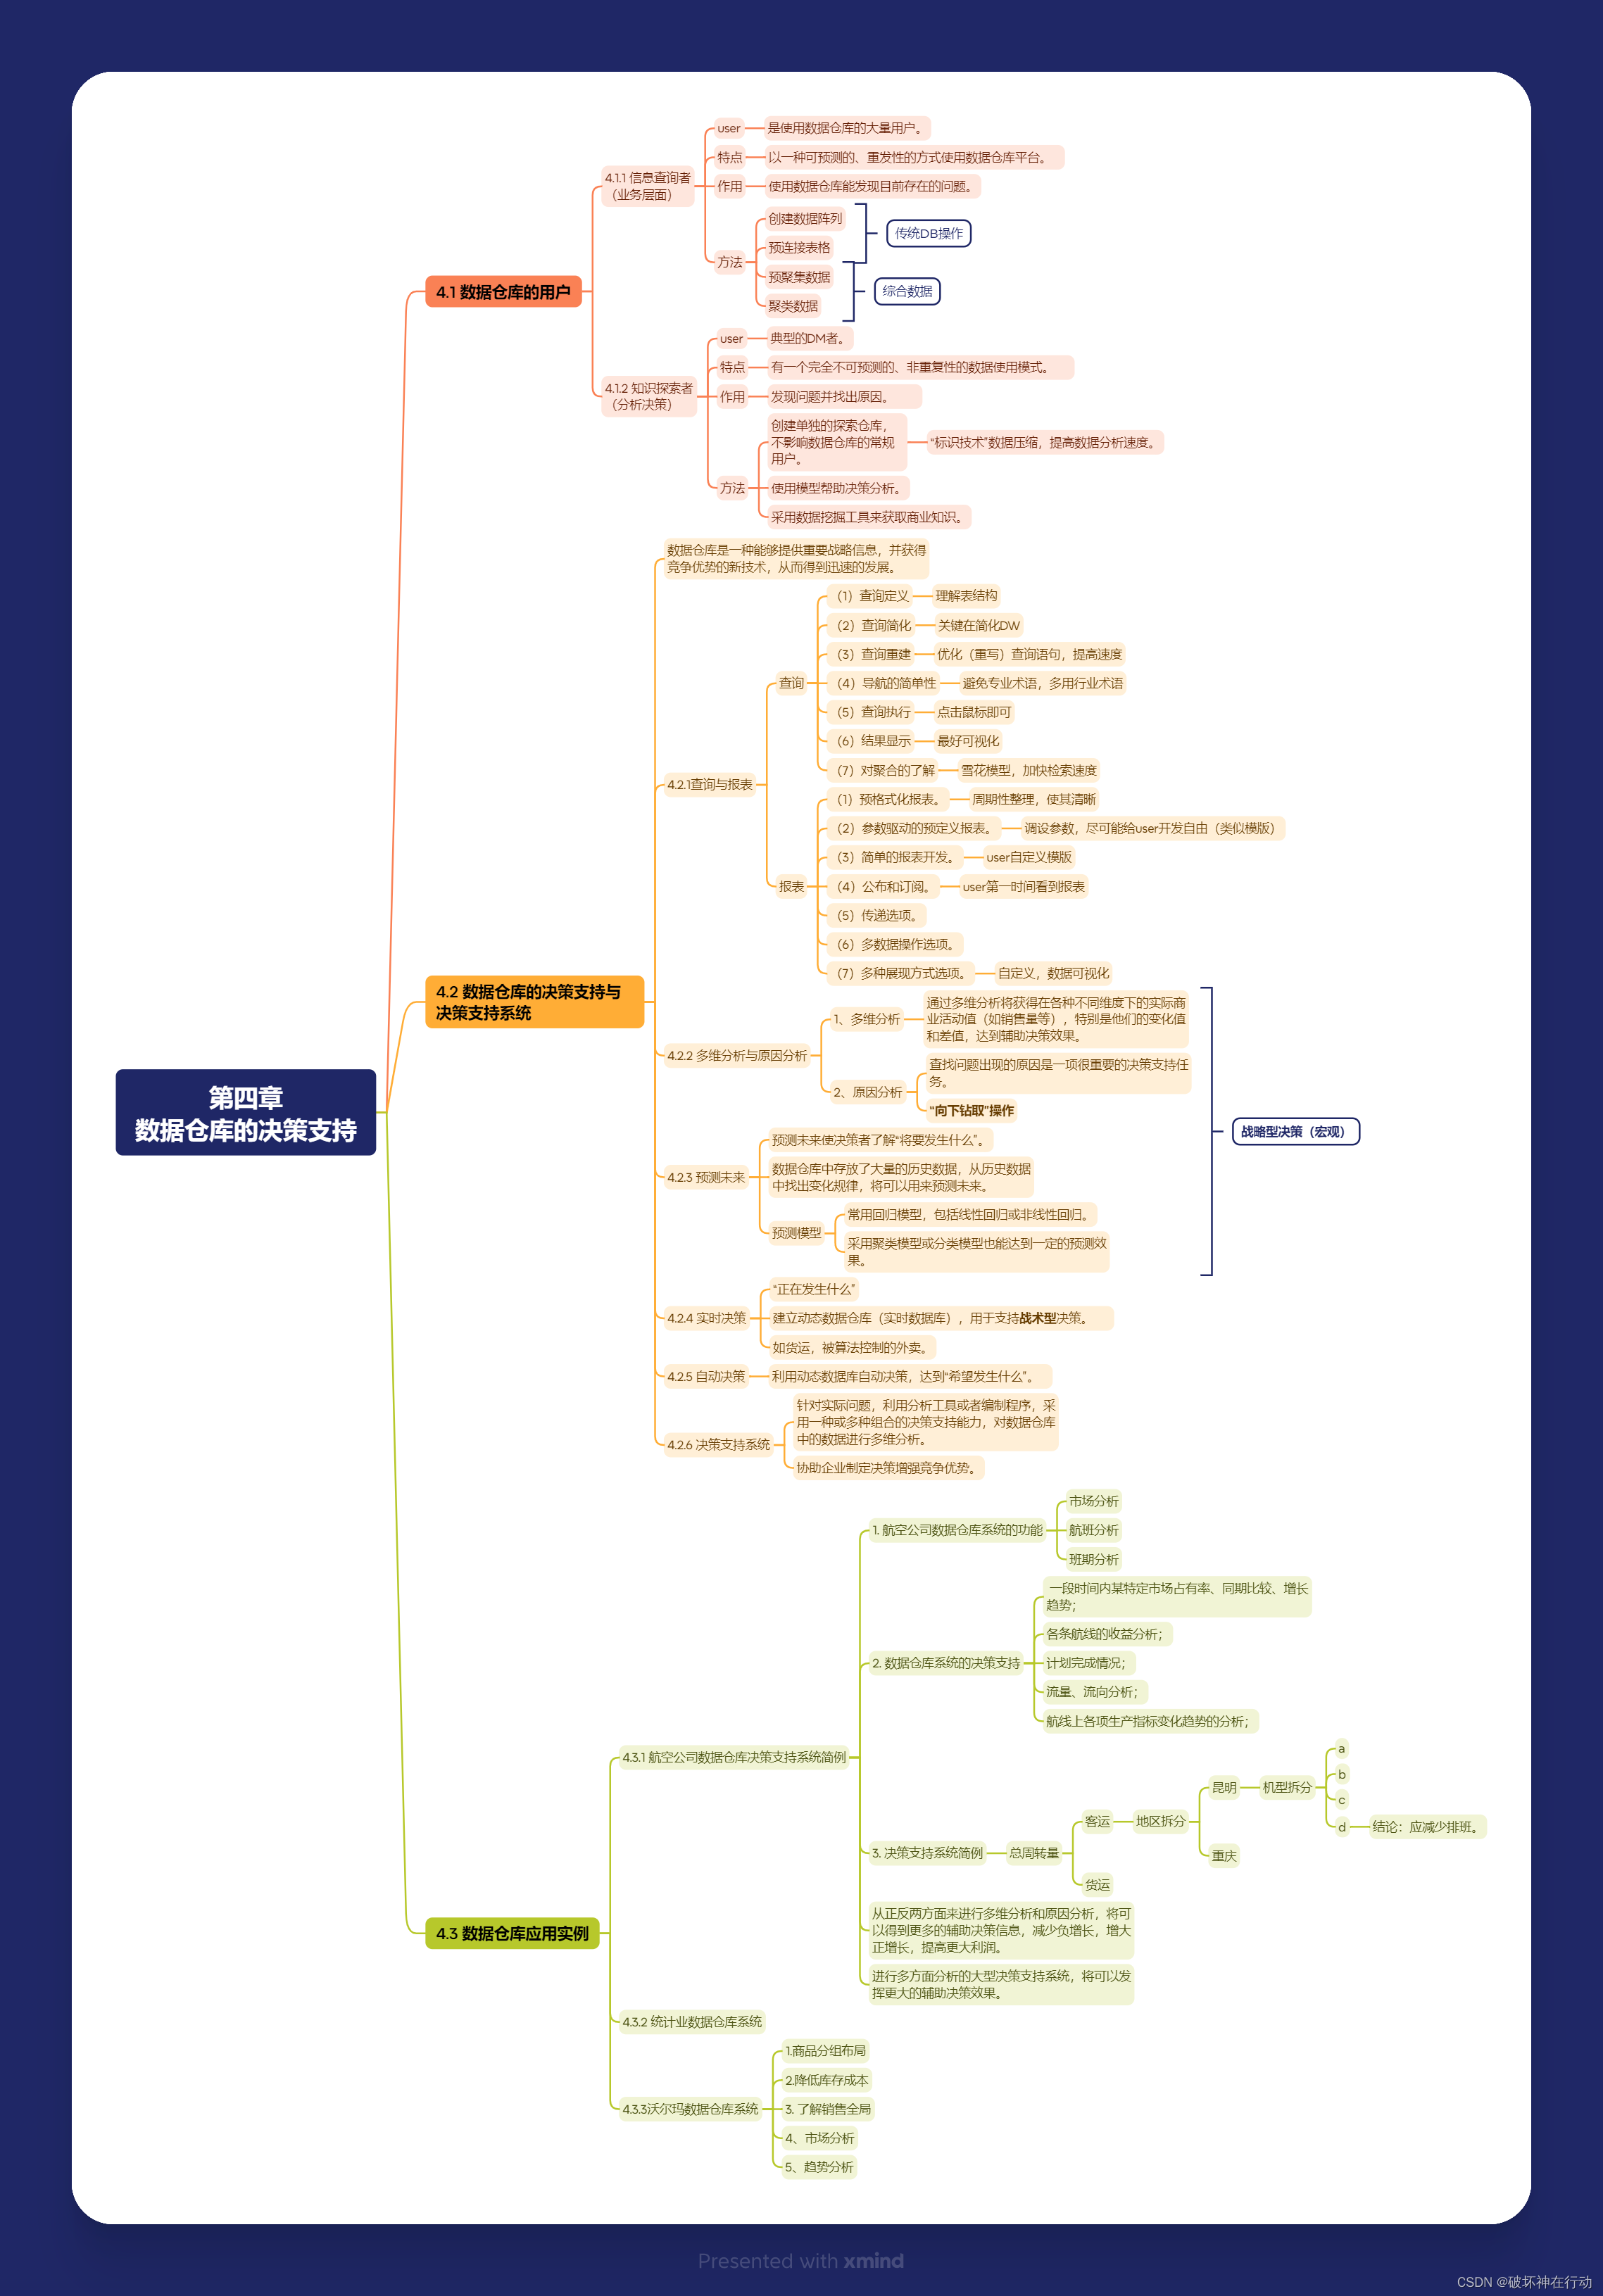
user是使用数据仓库的大量用户。特点以一种可预测的、重发性的方式使用数据仓库平台。作用使用数据仓库能发现目前存在的问题。方法创建数据阵列预连接表格预聚集数据聚类数据。
《数据仓库与数据挖掘》 总复习

《数据仓库与数据挖掘》 总复习
user是使用数据仓库的大量用户。特点以一种可预测的、重发性的方式使用数据仓库平台。作用使用数据仓库能发现目前存在的问题。方法创建数据阵列预连接表格预聚集数据聚类数据。
数据仓库与数据挖掘(实验一2024.4.24)

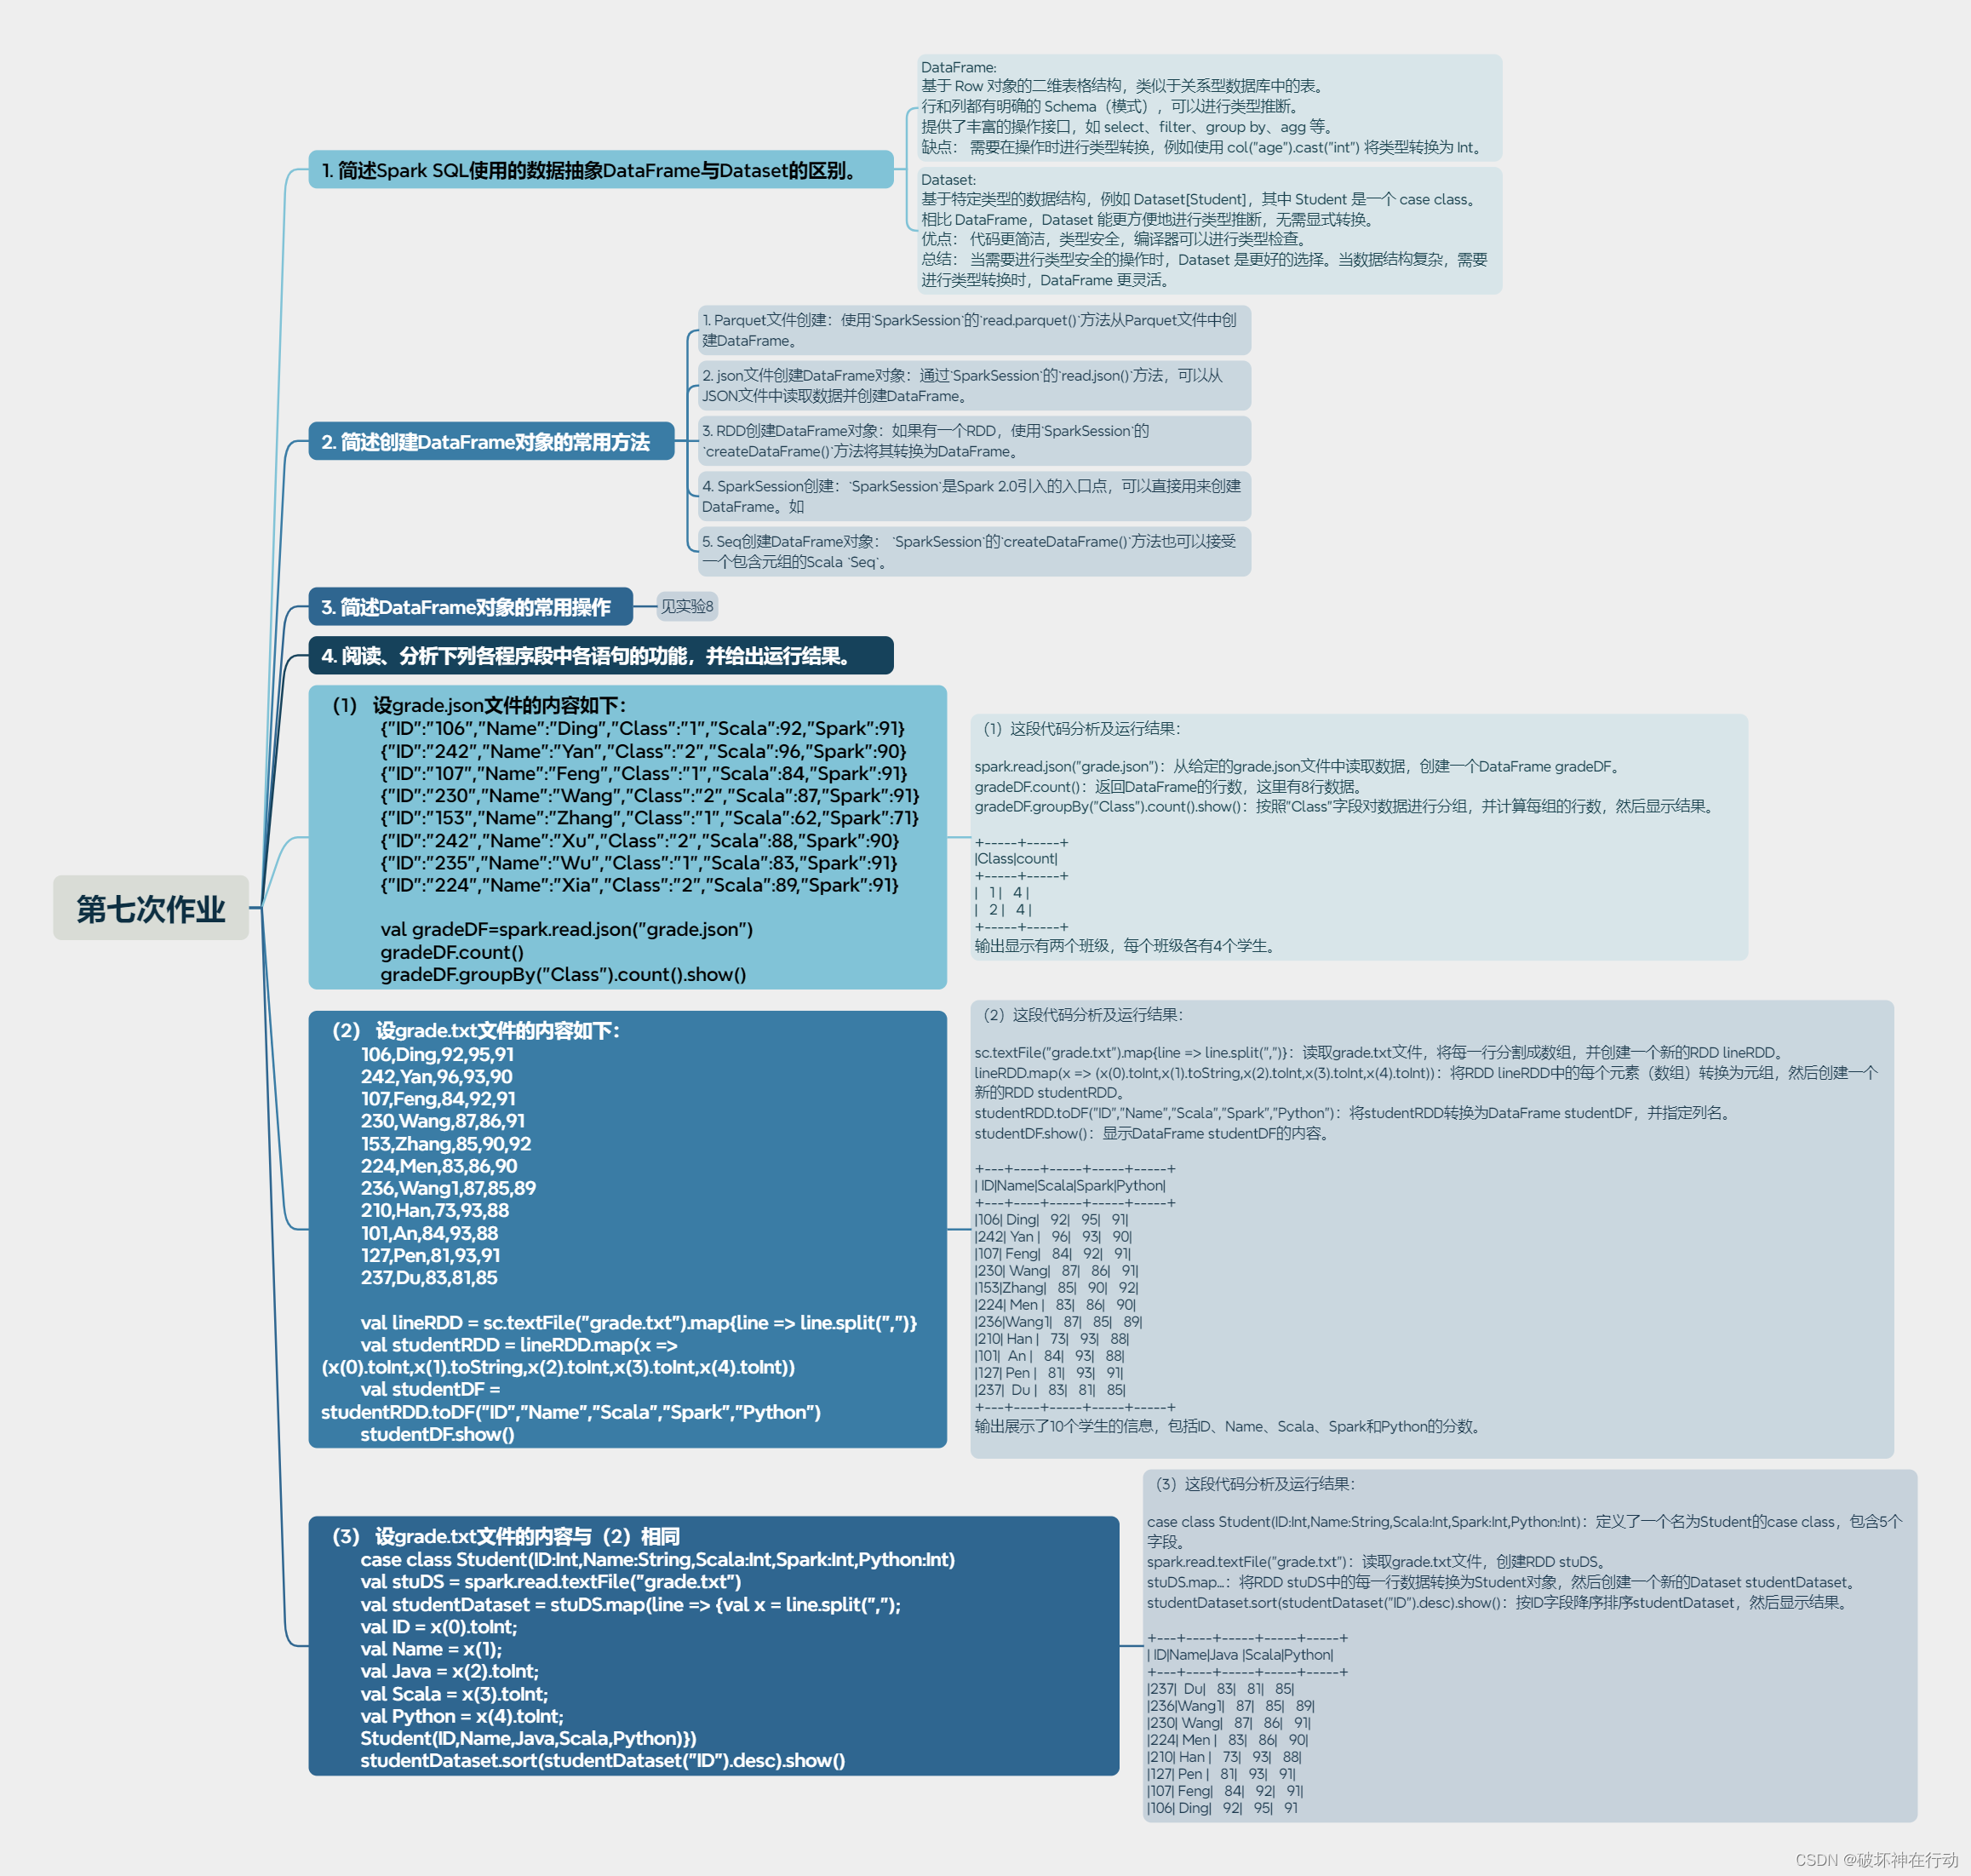
Hadoop+Spark大数据技术 第七次作业
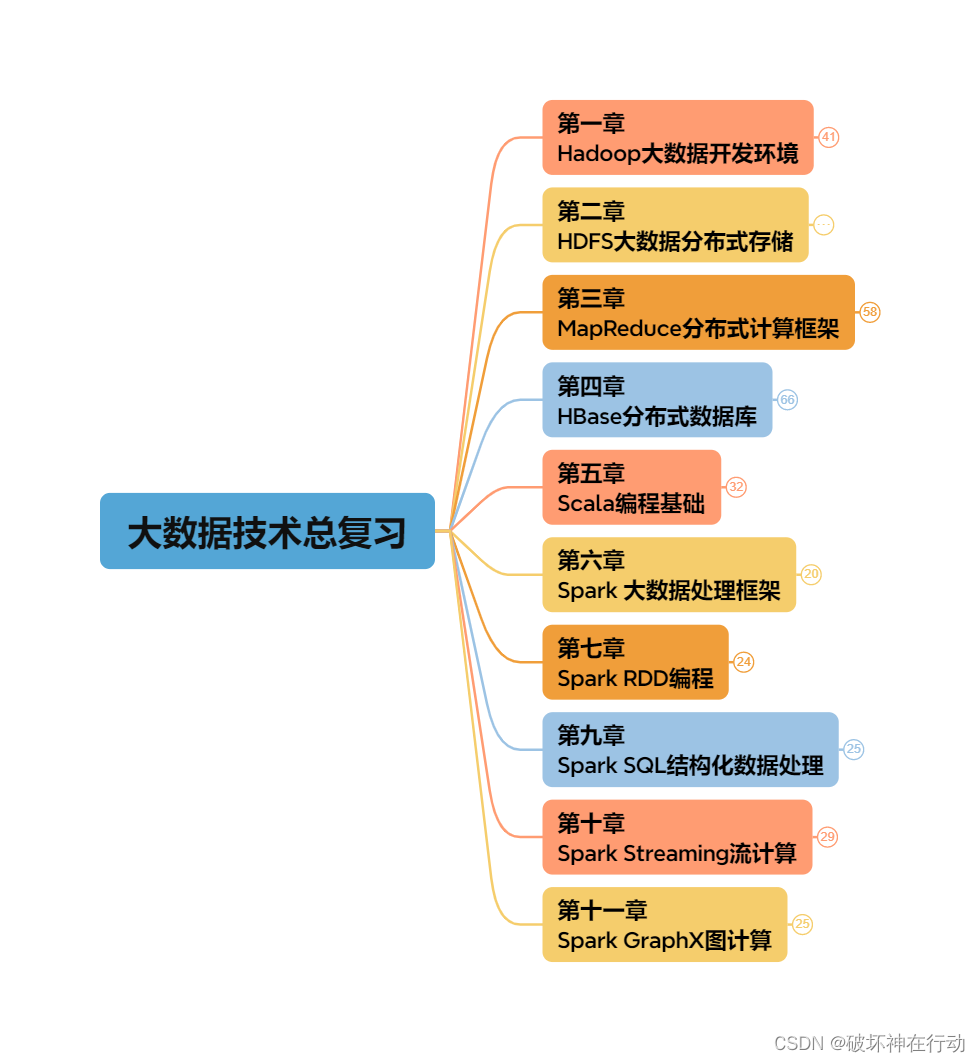
Hadoop+Spark大数据技术(微课版)总复习
1. Hadoop 核心组件包括:A. HDFS 和 HiveB. HDFS 和 MapReduceC. HBase 和 SparkD. YARN 和 ZooKeeper2. HDFS 数据块存储方式的优势不包括:A. 文件大小不受单一磁盘大小限制B. 简化存储过程C. 提高数据访问速度D. 提高数据容错能力3. NameNode 的主要功能是:A. 存储数据块B. 处理数据读写请求C. 管理文件

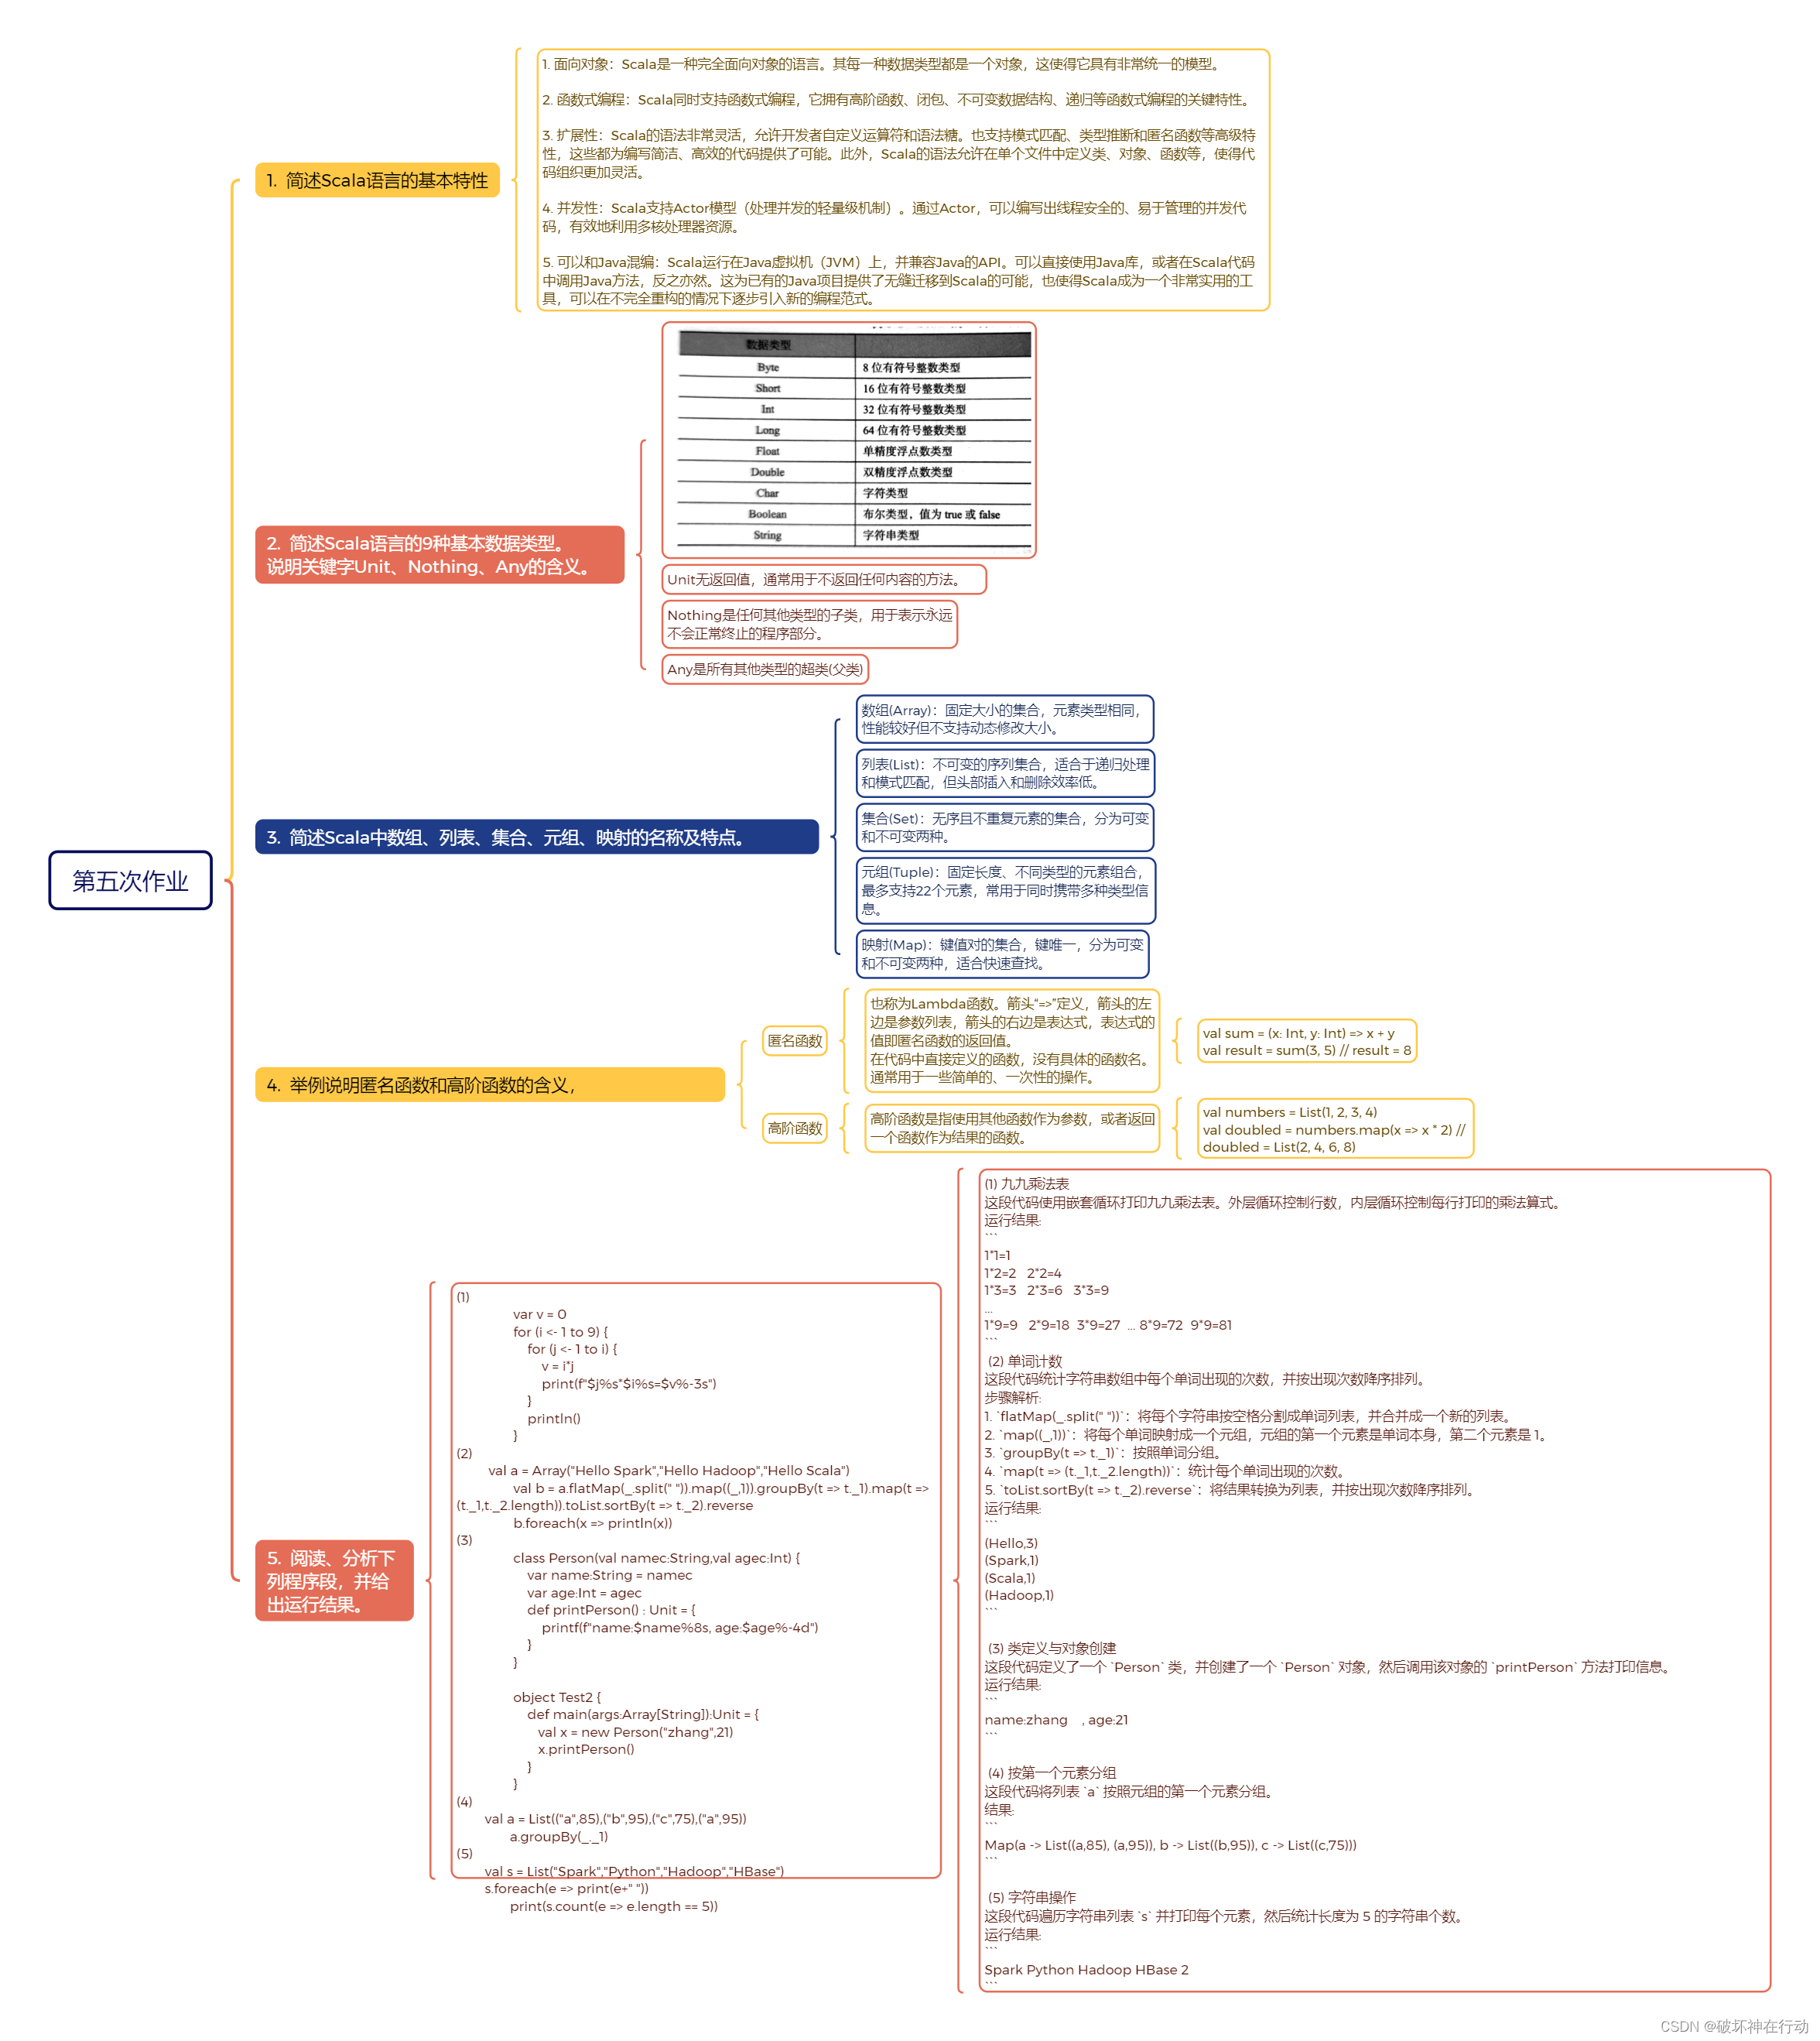
1. 面向对象:Scala是一种完全面向对象的语言。其每一种数据类型都是一个对象,这使得它具有非常统一的模型。2. 函数式编程:Scala同时支持函数式编程,它拥有高阶函数、闭包、不可变数据结构、递归等函数式编程的关键特性。3. 扩展性:Scala的语法非常灵活,允许开发者自定义运算符和语法糖。也支持模式匹配、类型推断和匿名函数等高级特性,这些都为编写简洁、高效的代码提供了可能。此外,Scala的
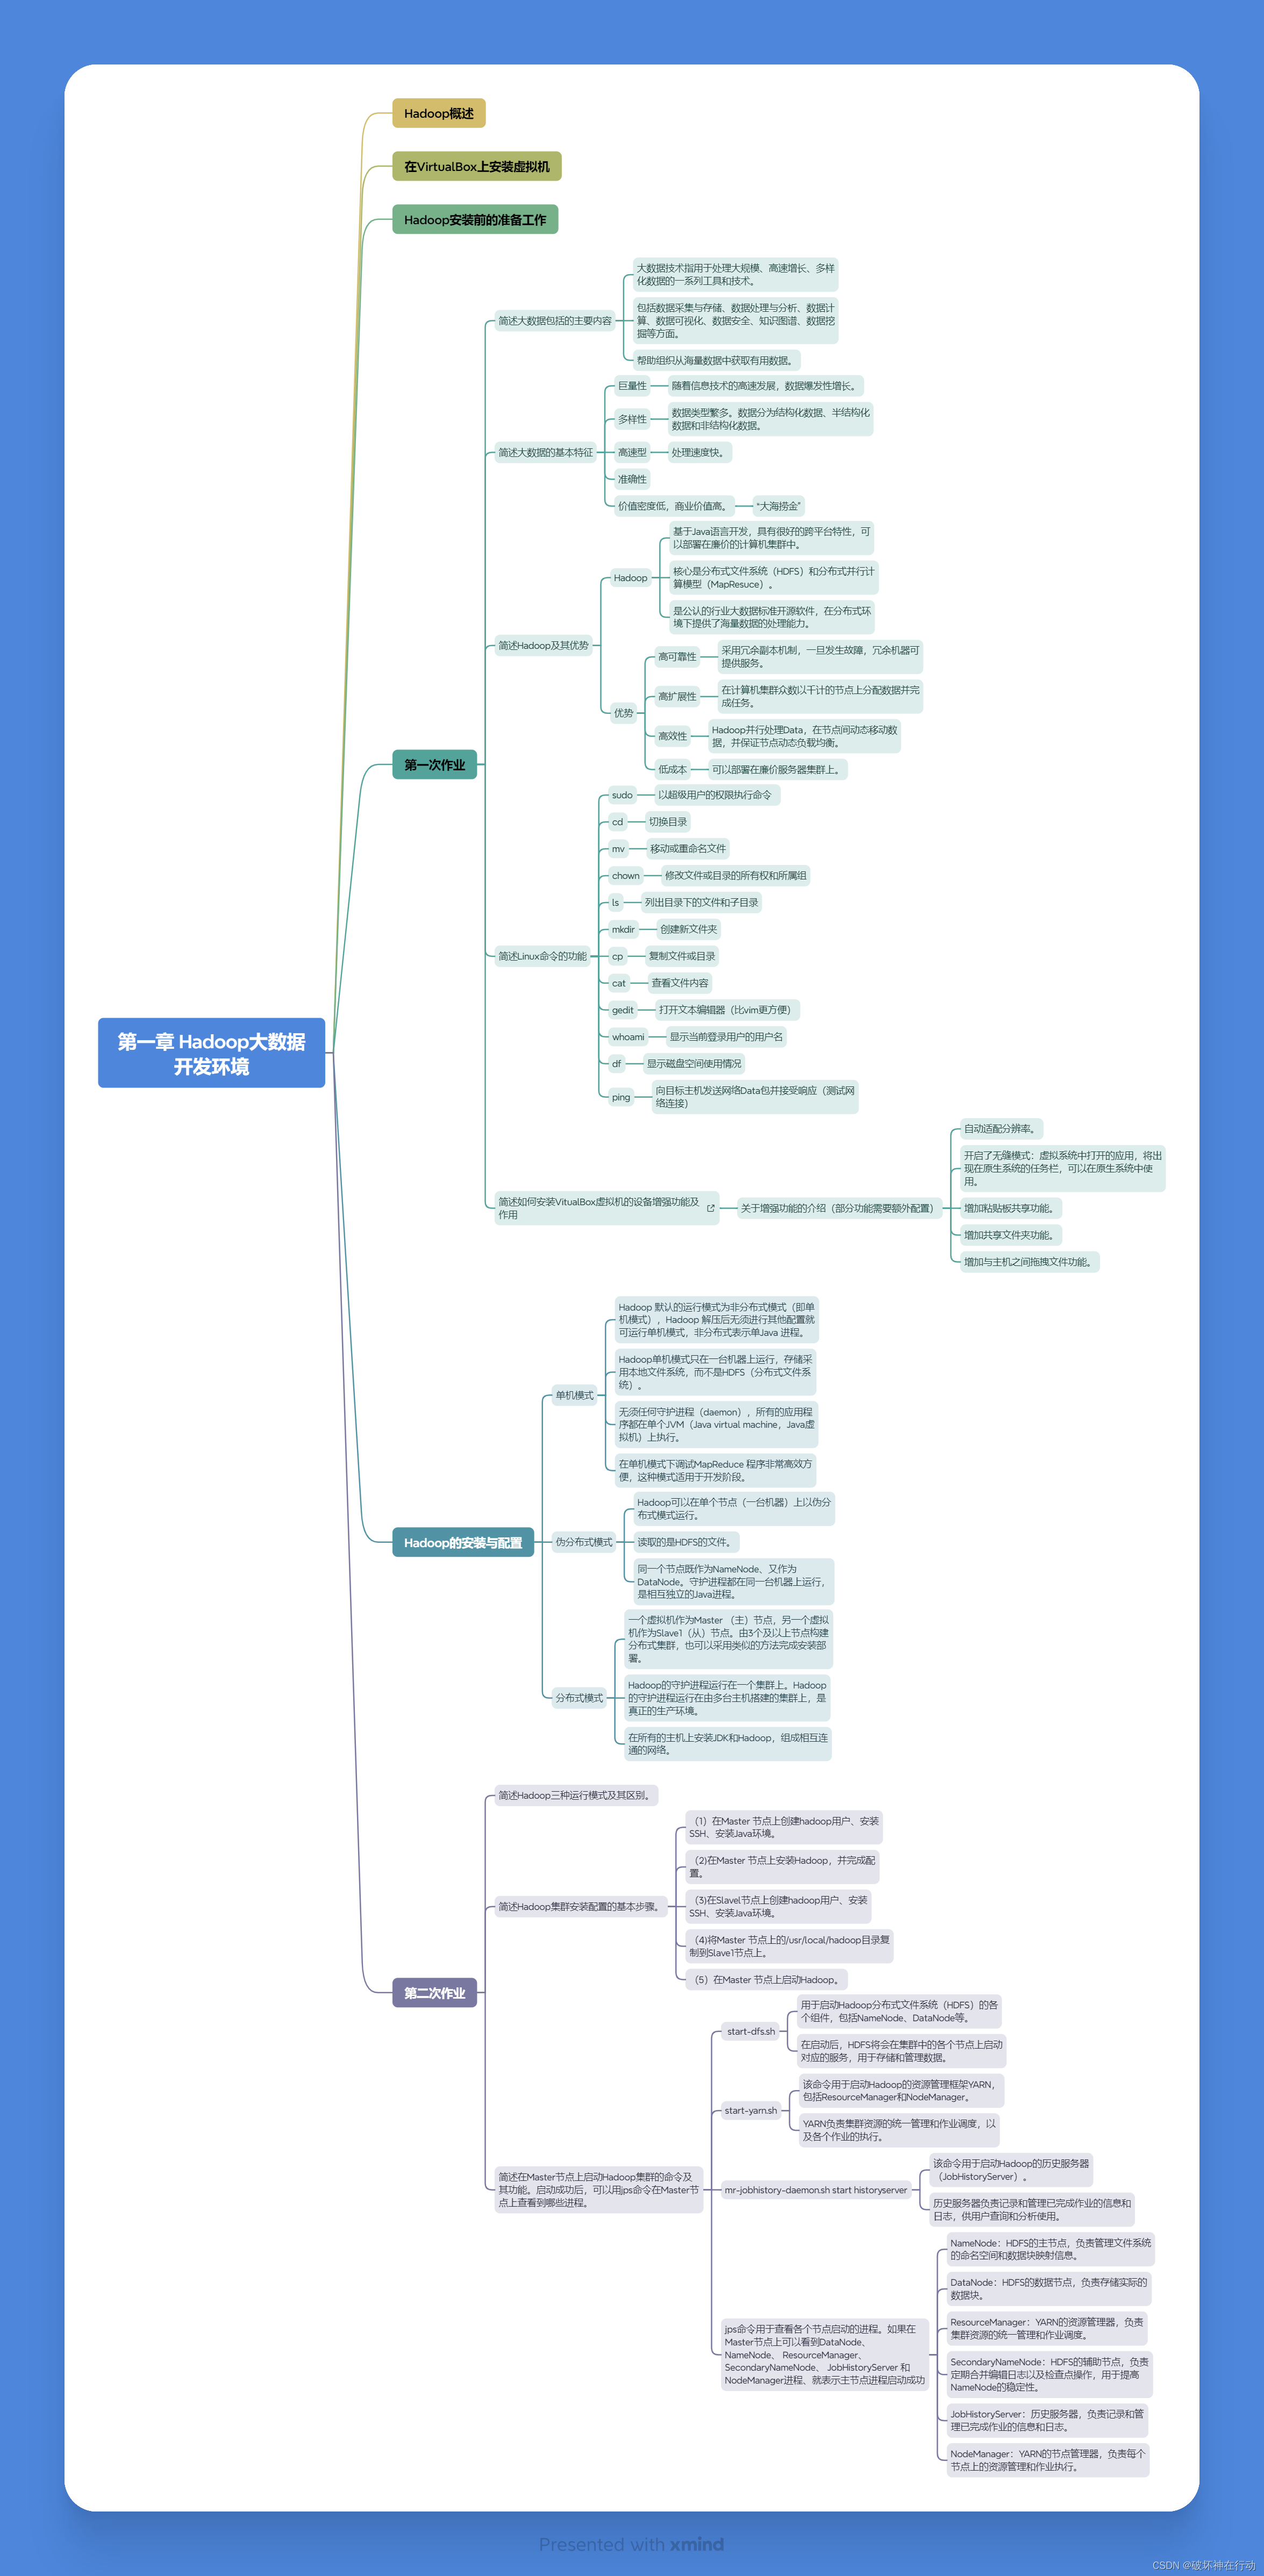
Hadoop概述在VirtualBox上安装虚拟机Hadoop安装前的准备工作。