登录社区云,与社区用户共同成长
邀请您加入社区
作为一位过来人也是希望大家少走一些弯路,如果你不想再体验一次学习时找不到资料,没人解答问题,坚持几天便放弃的感受的话,在这里我给大家分享一些自动化测试的学习资源,希望能给你前进的路上带来帮助。
记录一个删除特殊字符(#、换行符、回车符、制表符)的正则表达式,用来删除凭证中一些文本里传输或者粘贴过来的特殊符号。
本文介绍了一个Python实现的强密码验证函数,使用正则表达式检查密码是否符合8位以上且包含大小写字母、数字和特殊字符的要求。函数通过正则表达式分组确保所有字符类型都存在,并提供了测试用例验证不同场景。代码结构清晰,可扩展性强,方便调整密码策略。测试部分展示了合法密码和常见错误密码的验证结果,便于理解验证规则。
推荐做法静态常量预编译java使用Holder模式延迟加载javaPattern.compile("复杂正则");缓存动态生成的正则java。
Notepad++可以使用正则表达式替换字符,功能强大。
提示:在编写复杂的正则表达式时,建议先在正则表达式测试工具中验证,然后再在SQL中使用。这样可以更容易地调试和修改表达式。
- 解释:^[0-9] 数字开头, . 任意字符, [aeiou] 元音字母, .{2,} 至少2个任意字符。在实际的数据库工作中,两者都是重要的工具,根据具体需求选择合适的使用才是关键!确实可以做到,而且应该优先使用,因为它的性能可能更好。-- ... 需要写30种组合,极其繁琐!-- 使用 LIKE几乎不可能实现。:通常无法利用索引,全表扫描,性能较差。-- 能利用索引(如果name有索引)-
一、交互式学习与练习平台 1. RegexLearn(强烈推荐新手) 网址: https://regexlearn.com/特点: 渐进式交互教程,从零开始逐步学习优势: 专门为初学者设计,有完整的学习路径和练习语言: 支持多语言界面 2. RegexOne 网址: https://regexone.com/特点: 通过实际问题学习正则表达式优势: 任务驱动式学习,每课都有明确目标适合: 有编程基
查找以“w”开头,中间的“o”连续出现2到5次,再以“d”结尾的行,并显示行号。查找以“w”开头,中间的“o”连续出现至少2次,再以“d”结尾的行,并显示行号。查找以“w”开头,后面跟着任意两个字符,再以“d”结尾的行,并显示行号。查找包含“o”,并且“o”可以重复0次或多次的行,并显示行号。查找以“w”开头,中间有一个“o”且“o”可以重复0次或多次,再以“d”结尾的行,并显示行号。查找以“w”
正则表达式转义字符使用指南:介绍了需要转义的特殊字符(如.*+?等)及其匹配方法,列举了常见转义序列(\n、\d等),说明字符类中的特殊转义规则。特别提醒编程时需注意双重转义问题,推荐使用原始字符串。提供了邮箱、URL等实用匹配示例,并给出非捕获组、具体字符集等优化建议。强调测试验证的重要性,建议通过实践掌握转义字符的准确使用。
正则表达式匹配模式是控制匹配行为的选项,主要包括: 忽略大小写(i) - 使匹配不区分大小写 全局匹配(g) - 查找所有匹配项 多行模式(m) - 改变^和$的行为 点号匹配所有(s) - 使.匹配换行符 详细模式(x) - 允许添加空格和注释 Unicode模式(u) - 支持Unicode属性匹配 粘性模式(y) - 从指定位置精确匹配 这些模式可以单独或组合使用,不同编程语言的实现略有差异
提取 ply文件的点数(头部element vertex N)匹配隧道区段编号提取混凝土用量清理日志时间戳前缀文件名标准化。
本文介绍了Java中正则表达式的基本语法和API使用方法。主要内容包括:1)正则表达式基础语法,如字符类、预定义字符类、量词和定位符等;2)Java正则API的核心类Pattern和Matcher的使用方法,包括匹配、查找、替换和分割等操作;3)实用技巧如预编译正则表达式、嵌入条件表达式和使用零宽断言;4)正则表达式在文本处理、数据验证等场景的应用。文章通过代码示例详细演示了各种正则表达式的使用方
本文提供正则表达式语法指南和文本替换实用技巧,包含基础语法(元字符、量词、字符类)和常见替换场景(空格处理、敏感词过滤、数据脱敏等)。重点总结了20种典型文本处理场景的正则表达式解决方案,如日期格式转换、字符全半角转换、重复行删除等,并配有示例说明。同时提醒开发者注意贪婪匹配、分组引用、特殊字符转义等常见问题。附带正则表达式查询库下载链接,覆盖数据验证、文本清洗、日志分析等100种应用场景,帮助开
正则表达式是一种强大的字符串匹配工具,可用于验证、提取、替换和分割文本。Python通过re模块提供正则表达式支持,包含match()、search()、findall()等核心函数。基础语法包括字符匹配(如.、^、$)、量词(*、+、?)、字符类([abc])和预定义字符类(\d、\w等)。高级特性包括分组捕获、命名分组、预编译和标志参数(如忽略大小写)。实际应用涵盖邮箱验证、手机号校验、HTM
Python正则表达式入门:30分钟搞定文本查找替换!
正则表达式是一种用来描述字符串模式的规则。功能:检索、替换、过滤符合特定规则的字符串。
本文介绍了Java中正则表达式的基本用法,包括字符类、逻辑运算符、预定义字符、数量词、分组等功能。通过示例代码演示了如何用正则表达式验证字符串格式(如用户名、密码、邮箱等),以及String类中split()和replaceAll()方法的使用场景。文章还提供了常用正则表达式模板(如手机号、身份证校验)和在线正则生成工具。正则表达式是字符串验证的强大工具,能高效处理各种格式校验需求。
本文深入探讨了在Vue项目中,如何为Element UI的el-input组件实现健壮的数字输入限制。文章提供了从整数、小数到特殊字符过滤的完整实战方案,并重点剖析了正则表达式的常见陷阱与浏览器兼容性问题,旨在帮助开发者提升表单交互体验与数据准确性。
摘要:Regex101是一个专业的正则表达式在线测试工具网站(https://regex101.com/),提供实时匹配测试、语法高亮、解释功能等。该工具支持多种正则表达式风格,可帮助开发者快速验证和调试正则表达式模式。网站界面简洁直观,包含可视化匹配结果展示区域,是学习和使用正则表达式的实用在线平台。(95字)
本文深入探讨了HALCON在工业视觉项目中的字符串处理实战技巧。从基础的格式化输出、元组转换,到字符串分割、截取与搜索等核心操作,并重点介绍了正则表达式这一强大工具在智能文件管理、复杂文本解析与替换中的应用。掌握这些方法能有效处理产品序列号、系统日志等文本信息,提升视觉系统的自动化与智能化水平。
本文详细介绍了如何利用EmEditor的正则表达式功能快速完成文本降噪与内容提取任务。通过实战案例展示,EmEditor作为专业文本编辑器,其强大的正则引擎能高效处理日志清洗、数据提取等复杂操作,5分钟即可完成传统编程需数小时的工作,大幅提升文本处理效率。
在数据库查询中,我们经常需要进行复杂的模式匹配。虽然 MySQL 提供了 LIKE 操作符进行简单的模糊匹配(使用和),但对于更复杂的模式匹配需求,正则表达式是更强大的工具。MySQL 通过REGEXP和RLIKE操作符支持正则表达式匹配,其语法与 Perl 兼容的正则表达式(PCRE)类似,为开发者提供了强大的模式匹配能力。fill:#333;color:#333;color:#333;fill
正则表达式描述了一种字符串匹配的模式,可以用来检查一个串是否含有某种子串、将匹配的子串替换或者从某个串中取出符合某个条件的子串等。普通字符包括没有显式指定为元字符的所有可打印和不可打印字符。这包括所有大写和小写字母、所有数字、所有标点符号和一些其他符号。
方式一:
一文秒懂Java正则表达式中 `\\1` 和 `$1` 的使用场景
d: 匹配一个数字,等同于[0-9](注意:在BRE中可能不支持,通常使用[0-9])\D: 匹配非数字,等同于[^0-9]\w: 匹配字母、数字、下划线,等同于\W: 匹配非字母、数字、下划线\s: 匹配空白字符(空格、制表符、换行符等)\S: 匹配非空白字符。
正则表达式语法速查表 本摘要整理了正则表达式的核心语法元素,包括字符匹配、数量限定、位置锚点、分组引用等常见用法,以及实用的应用示例。 基础匹配: 普通字符直接匹配(如abc) 特殊字符:.匹配任意字符,[]定义字符集,[^]取反 预定义字符类:\d(数字)、\w(单词字符)、\s(空白符)等 数量限定: *(0次+)、+(1次+)、?(0或1次) 精确控制:{n}(n次)、{m,n}(m到n次)
本文详细介绍了如何利用VScode正则表达式功能一键清理代码注释与空行,提升代码整洁度。涵盖JavaScript、HTML、Python等多种语言的注释清理方案,并提供空行处理的高级技巧与常用正则表达式大全,帮助开发者高效维护代码质量。
正则表达式是一种强大的文本处理工具,具有高效、灵活的特点,适用于数据提取、表单验证等多种场景。其核心包括元字符、量词、字符集与分组等语法规则,可通过零宽断言实现精确位置匹配。虽然正则表达式功能强大,但存在学习门槛高、可读性差、性能陷阱等问题,不适合处理嵌套结构文本(如HTML)。建议从基础语法入手,借助在线工具调试,注意贪婪模式的影响,并在复杂场景中结合传统字符串处理方法。
对于xpath和bs4不能匹配的数据,可以用正则表达式。正则表达式可以用于匹配复杂的数据,获取目标数据。
如下图7所示,试试不同case分支下的返回值,尤其是不常见用的返回值,如PARTIAL、INCOMPATIBLE等。我们学习必然是为了找到高薪的工作,下面这些面试题是来自阿里、腾讯、字节等一线互联网大厂最新的面试资料,并且有字节大佬给出了权威的解答,刷完这一套面试资料相信大家都能找到满意的工作。那么,如果某个变量不在定义的类型范围内呢,要使用列表或集合的功能处理这个变量,会怎么样?探索性测试是一门
本文深入解析JMeter正则表达式提取器中三个关键配置项:"RegularExpression"用于设置匹配响应数据的正则表达式,支持分组捕获(带括号)和不分组捕获($0$);"Template"用于设置捕获结果的保存格式,可通过$1$、$2$等引用捕获组内容;"MatchNo."则用于指定匹配项的序号。文章详细介绍了分组捕获的编号规则和
正则匹配时需要匹配某些特定的正则只用于匹配,而不在匹配最终结果中显示,这就要用到断言
std::smatch 是 C++ 标准库中用于存储正则表达式匹配结果的容器类型。之前的代码中因为只设置了一个捕获组,所以match[0]和match[1]相同。match[1]:存储第一个捕获组的内容(第一对括号 () 内匹配的内容)那么在这几句代码中,使用match[0]和match[1]有什么区别吗?match[0]:存储完整匹配的内容(整个正则表达式匹配到的字符串)这段代码的作用是从文件名
.匹配到实际的点号;对于中国大陆的手机号码,其正则表达式可以定义为^1(3\\d{2}|4[5-7]\\d{2}|5[0-35-9]\\d{2}|66\\d{2}|7[0-35-9]\\d{2}|8\\d{3}|9\\d{2})(0[0-9]{2,3}|[1-9][0-9]{2,3})$ ,这个表达式在前面已经详细解释过,它涵盖了不同运营商的各种号段,并且严格限定了手机号码的格式。它与普通分组(p
Python正则表达式指南摘要:本文详细介绍了Python中re模块的正则表达式功能,包括基本语法、特殊字符、预定义字符集、量词分组等核心概念。重点讲解了re.match()、re.search()、re.findall()等常用方法,以及正则表达式编译和标志参数的使用技巧。通过实际应用示例(如邮箱验证、电话号码提取、URL解析等)演示了正则表达式的实用场景,并提供了性能优化建议和调试技巧。文章还
摘要 本文系统介绍了Python中正则表达式的核心知识和re模块的高级应用。主要内容包括: 正则表达式基础语法:详细解析元字符、字符类和量词的使用方法,通过代码示例展示.、\d、\w等核心元字符的匹配规则,以及贪婪/非贪婪匹配的区别。 Python re模块功能:全面对比re.match()、re.search()、re.findall()等核心函数的特点和适用场景,分析各函数的性能差异和使用技巧
学习Unicode属性 escapes(Java 9+),如。
正则表达式(Regular Expression)作为文本处理的核心工具,广泛应用于网络安全、数据挖掘和编译器等领域。本文深入探讨如何通过硬件加速技术(如FPGA、GPU)优化正则表达式匹配,结合算法改进与硬件特性,实现高效能计算。正则表达式引擎通常采用NFA(非确定有限自动机)或DFA(确定有限自动机)实现。通过硬件描述语言(如Verilog)实现多个DFA实例并行运行,每个实例独立处理输入文本
POSIX 字符集是正则表达式中用于表示“一类字符”的预定义集合,本质是对常用字符范围的标准化缩写。用代替[0-9](表示任意数字)用代替[a-zA-Z](表示任意字母)跨平台兼容性:在所有遵循 POSIX 标准的系统(Linux、Unix、macOS)中均可使用;多语言支持:部分集合(如)不仅包含英文字母,还支持带重音的字符(如 é、ñ 等);语义清晰比更易读,减少编写错误。POSIX 字符集是
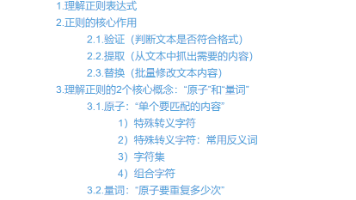
本文系统介绍了正则表达式的核心概念与应用。主要内容包括:1)正则的本质是将自然语言匹配规则转化为符号代码;2)三大核心功能(验证、提取、替换)及典型案例;3)组成要素"原子"和"量词"的详细分类说明;4)使用原则(定位优先、转义必要、量词跟随);5)常用场景模板(手机号、邮箱、密码强度等)。通过原子与量词的组合,正则能用简洁模式替代复杂代码逻辑,是处理文本规
回顾之前讲的内容,原理篇重在建立直观理解,帮你建立信心,这是第一轮的认知迭代。应用篇帮你涉足应用领域,在解决领域问题时发挥编译技术的威力,积累运用编译技术的一手经验,也启发你用编译技术去解决更多的领域问题,这是第二轮的认知迭代。而为时三节课的算法篇将你是第三轮的认知迭代。在第三轮的认知迭代中,我会带你掌握前端技术中的核心算法。而本节课,我就借“怎样实现正则表达式工具?在词法分析阶段,我们可以手工构
如后端开发验证后端传入参数的格式(邮箱,手机,身份证号),密码强度检测,批量处理(替换)页面的文本内容,或者提取日志中的有效信息,统一数据格式。正则表达式:^[1-9]\d{5}(19|20)\d{2}(0[1-9]|1[0-2])(0[1-9]|[12]\d|3[01])\d{3}[\dXx]$说明:以 1 开头,第二位为 3-9 的数字,后续跟 9 位数字,覆盖所有中国大陆手机号段。正则表达式
enum Ast {Chr(Char)Opt(Ast)Chr(chr)@fs.Opt(self)Chr(Char)- 匹配单个字符字面量- 序列匹配,即一个模式紧跟另一个模式- 重复匹配,None表示无限次重复,Some(n)表示恰好重复 n 次Opt(Ast)- 可选匹配,相当于标准正则语法中的pattern?举个例子,正则表达式(ab*)?
⏹正则表达式 跨行匹配指定内容之间的所有内容
结果为have,但是你把str换成abc123就是no,因为它需要全字匹配,你可以把正则表达改成abc\\d+,如果你需要部分匹配可以使用下面例子。匹配字符串是否包含某些字符,可以使用regex_match,但是这个是全字匹配,不能部分匹配,比如。4、求出字符串所有匹配到的结果,比如提取字符串中所有数字。代码语言:javascript。代码语言:javascript。代码语言:javascript
编程进阶必学:正则表达式用来快速查找、匹配或替换文本中符合规律的内容
正则表达式(Regular Expression)是一种强大的文本处理工具,用于模式匹配、搜索和替换字符串。在C中,自C11标准起,标准库引入了。通过以上示例,您可以快速上手C正则表达式。实际应用中,结合具体需求调整模式,如邮箱验证。下面通过逐步示例展示C中的实现。代码使用C11或更高版本编译,需包含。头文件,提供了一套完整的正则表达式支持。检查字符串是否完全匹配给定模式。在字符串中搜索符合模式的
正则表达式
——正则表达式
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 天工造物局