登录社区云,与社区用户共同成长
邀请您加入社区
三种方式根据需要弄哈;增量的,我觉得实际业务中,除非没有update操作才适合使用JDBC这种增量方式,不然都是扯犊子,毕竟hdfs对随机写不是很友好。这是全量的,慢的很。没有sqoop快。1、JDBC Query Consumer (单表全量)2、 JDBC Multitable Consumer (单库多表全量)3、分区同步建议使用下面的 (单表分区)配置文件很简单。这里不说,有需要的小伙伴可
大数据进行数据抽取(ETL)中离不开从源系统的数据库增量全量同步数据到大数据平台(hive)中。我的平台(带有调度工具):联想大数据平(LeapHD)。
一、前言elasticsearch-bulk-insert-plugin插件,如下图,参数配置不能使用kettle.properties文件设计的变量,不利于作业迁移。考虑到ES支持rest api,尝试使用REST Client组件往ES迁移数据二、方法1、转换总览2、表输入3、JSON Output拿到源表数据后转成JSON类型:此步骤将从mysql表拿到的数据转成了如下...
kettle后台命令执行任务kitchenPan配置定时任务kitchenkitchen是一个作业执行引擎,用来执行作业。这是一个命令行执行工具,参数说明如下-rep:Repository name 任务包所在存储名-user:Repository username 执行人-pass:Repository password 执行人密码-job:The name of the job...
hive映射elasticserch的实践与优化,问题总结
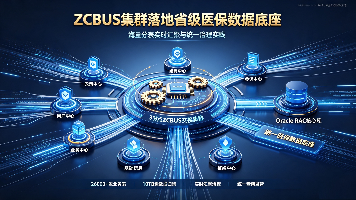
省级医保体系分中心多、分库分表数量庞大,数万张业务数据表散落于各个业务中心,统一查询、医保结算、常态化监管难以落地。本文以省级医保数据底座建设项目为原型,围绕ZCBUS 3 节点交换集群落地实践,讲解依托平台实时计算与数据汇聚能力,完成超 26000 张分散数据表整合、10TB 级数据归集,构建统一医保实时数仓,支撑全省医保一站式查询、结算监管业务落地。
get_data() 返回结果(formuuid, version, createtimegmt, modifiedtimegmt, title,creator,modifier, actionexecutor, data)1.如果是 form 需要先获取表单实例ID UUID, 再获取实例ID 的数据。2.如果是 processes 可以直接获取 表格数据 ,但是获取的数据没有主键。通过 app
ETL 工具与数据中台的关系与区别
在Oracle数据库中,拉链表用于保存数据的历史变化记录。这种表通常用于审计或跟踪数据的变更历史。拉链表通常包含额外的列来记录每条记录的有效时间段。:拉链表除了包含业务数据外,还需要包含开始日期和结束日期,以及一个标志位表示记录是否当前有效。:当数据发生变化时,新的记录被插入到拉链表中,并标记旧记录为不再有效。:查询时,需要过滤出当前有效的记录。
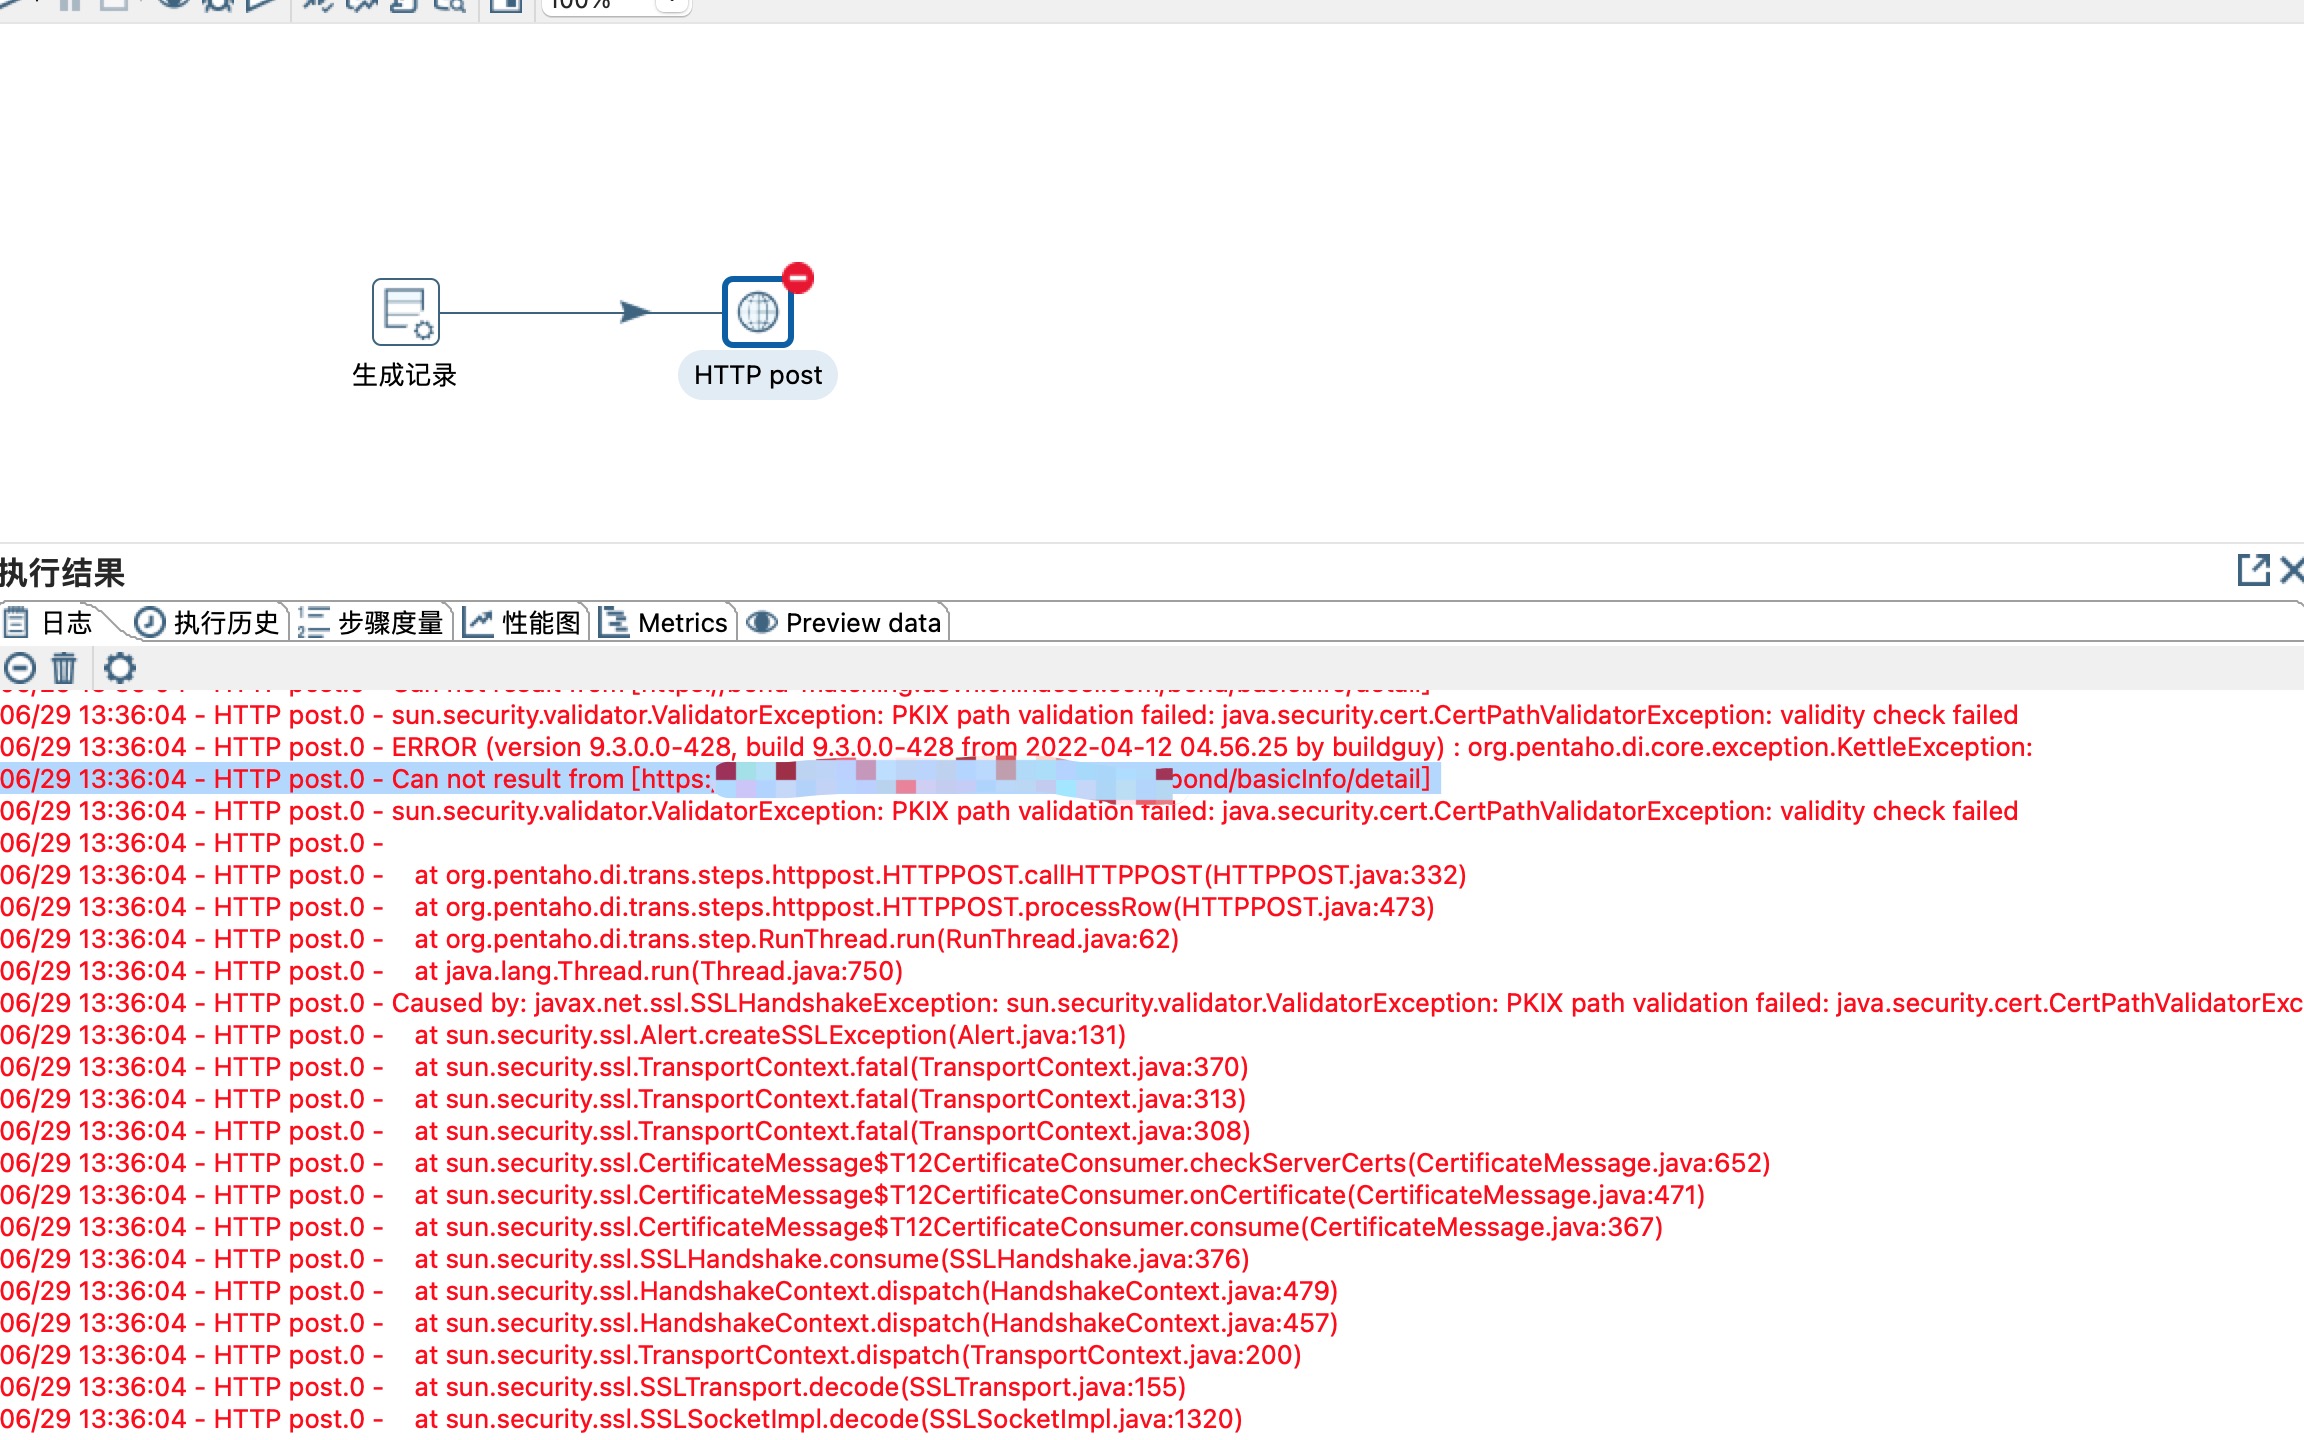
1、在使用kettle调用接口的时候不可避免要调用http或者https接口,调用http接口kettle可以正常工作,但是遇到https接口的时候kettle就会提示证书有误,无法正常调用接口,今天咱们一起通过自研插件的方式来解决这个问题。自研插件需要有一定的java基础,git上有比较多的例子,本次不讲解如何开发组件,这里介绍下如何使用自研http/htts插件的使用。resultField:
尤为重要的是,它为医生科研项目提供了强大的数据分析工具与平台,助力医生深入挖掘数据价值,分析各平台数据间的关联与趋势,为临床研究、疾病预测、治疗方案优化等提供科学依据,推动医疗科研水平的提升。后台会启动异步的Compaction进程对历史版本的数据进行清理,当用户在查询时,Doris会将最新版本对应的数据返回给用户,这种设计解决了海量数据的更新问题。在实时数仓构建的过程中,还需面临高并发写入和实时
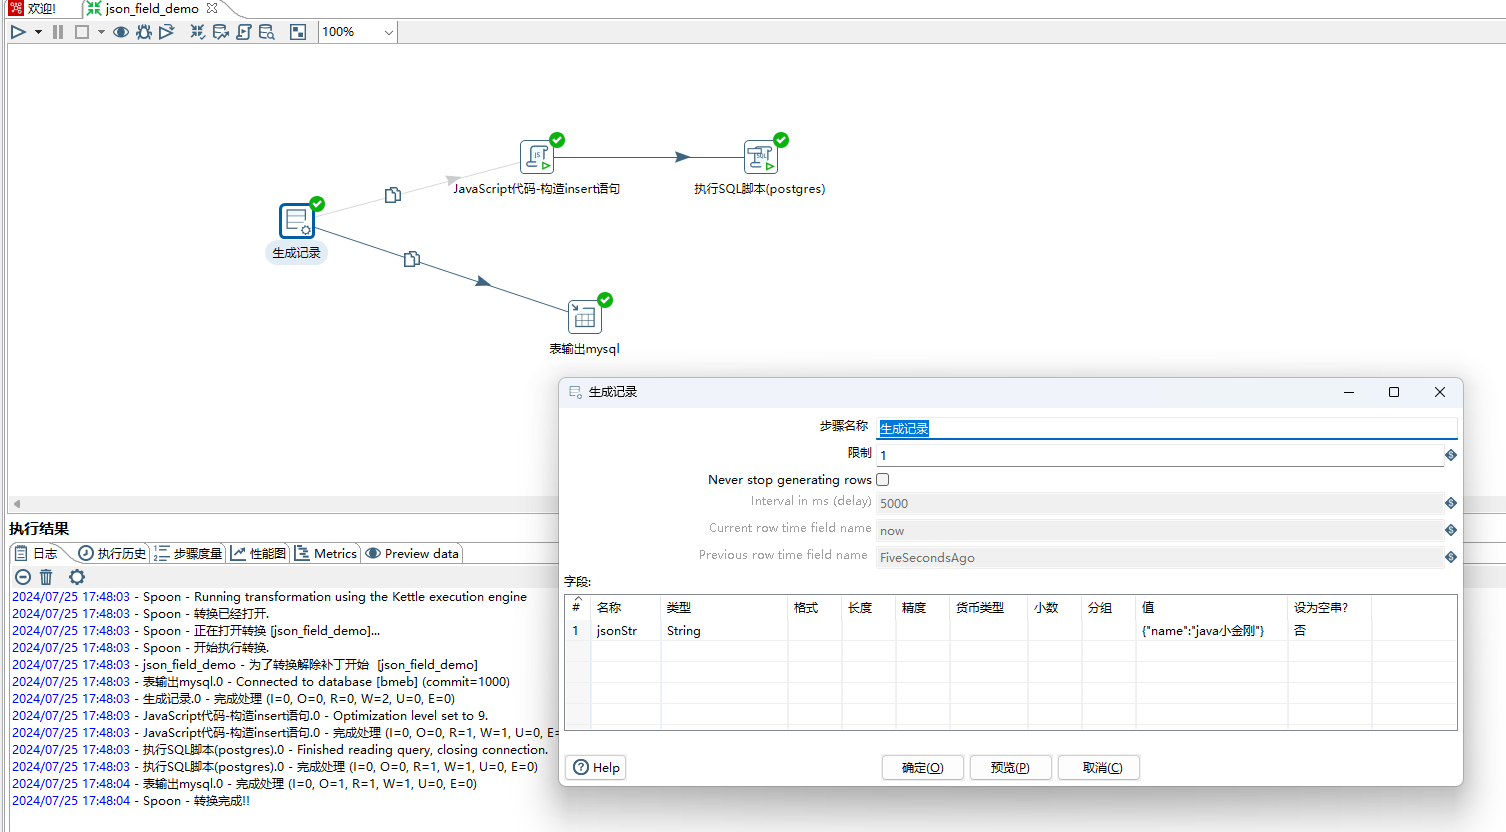
场景:源数据库表为mysql的其中有json字段,通过kettle 查询出来 插入到目标数据库 postgresql中,对应的表中也有json字段。但是报错,提示kettle查询出来是varchar的的字段,无法插入到目标数据库中。本人在DBeaver中直接执行INSERT INTO public.t3 (name) VALUES ('{"name":"java小金刚"}');是可以正常插入到js
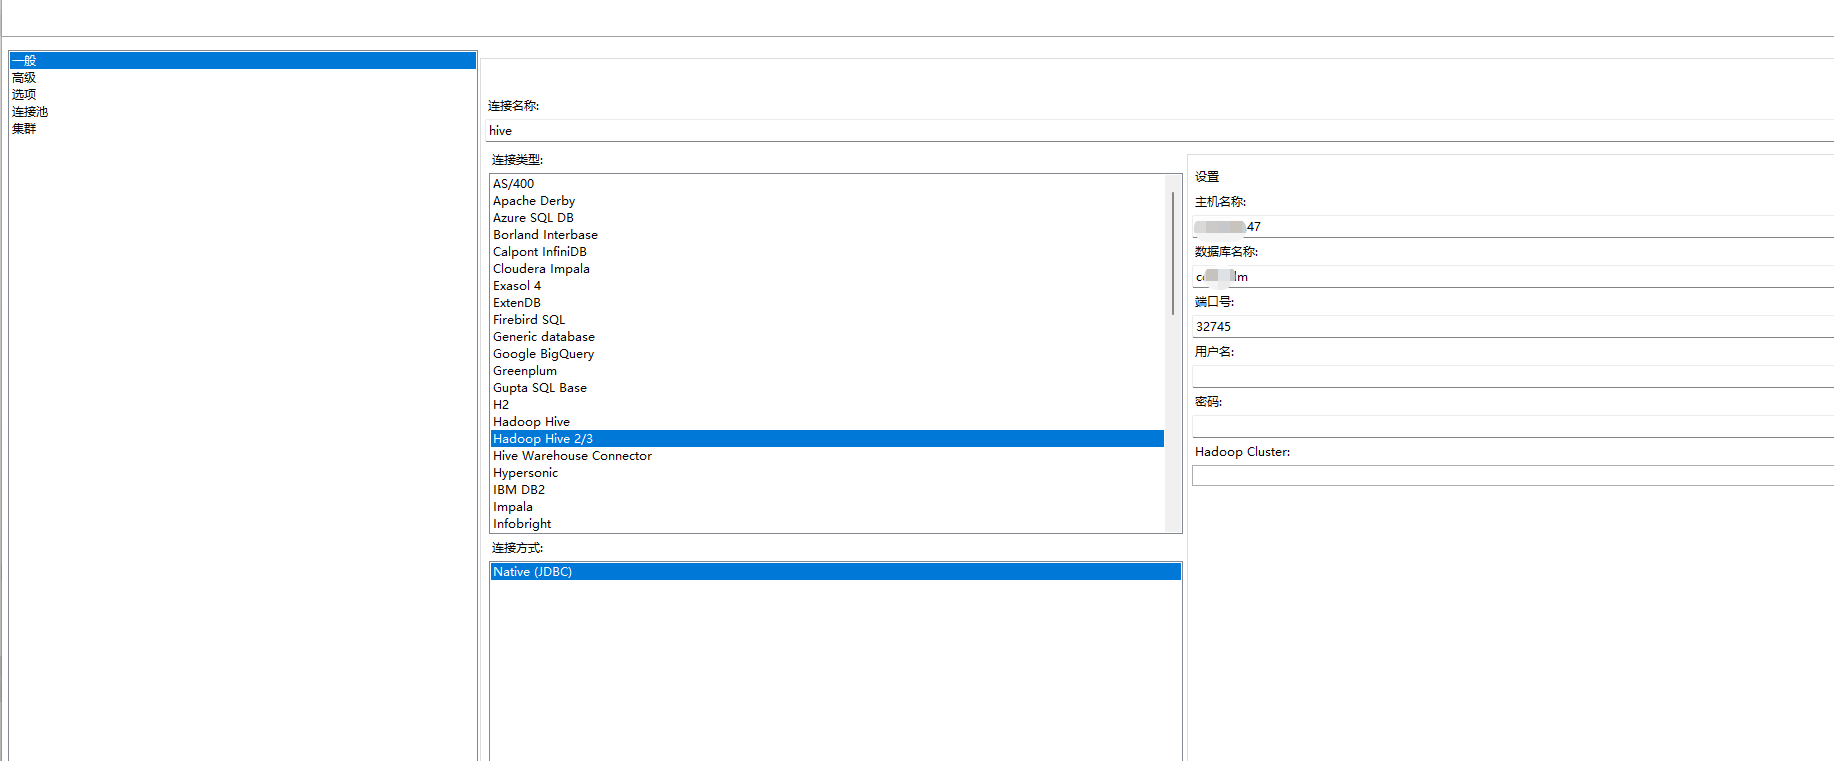
1、群里有小伙伴询问kettle连接hive的demo,今天抽点时间整理下。1)kettle中的lib目录下放hive驱动jar,这里我使用的是kyuubi-hive-jdbc-shaded-1.9.0.jar。6、删除kyuubi-hive-jdbc-shaded-1.9.0.jar,重新运行,出现找不到驱动jar错误,如下图所示。2、下载kyuubi-hive-jdbc-shaded-1.9.
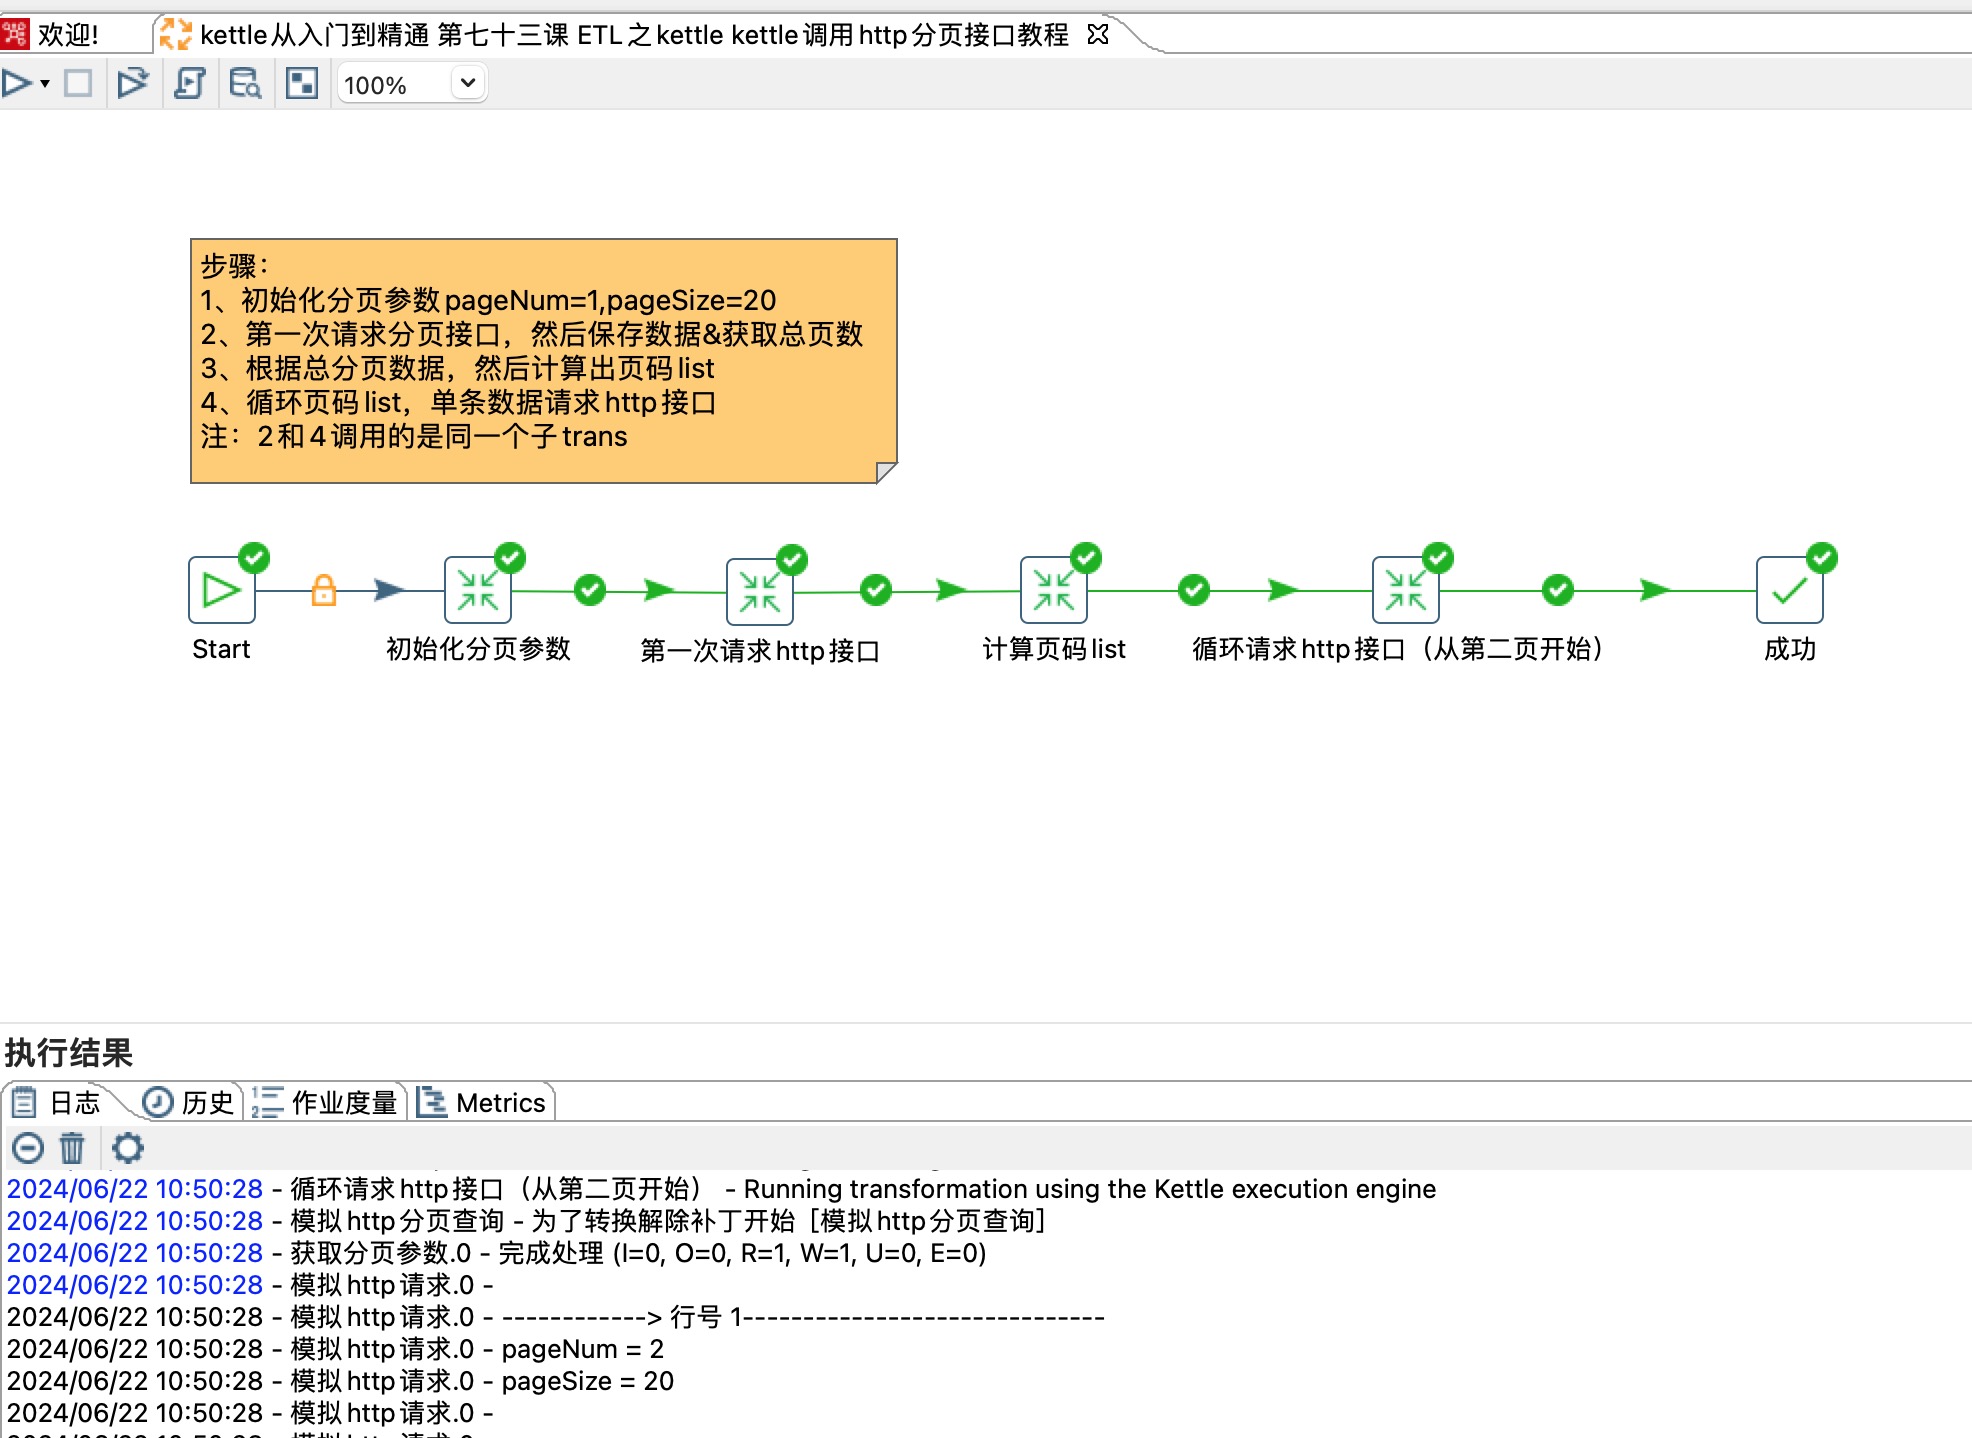
1) 这一步很重要,将单条数据变成list,如上一步的totalNum为3,这里会输出[{"paggNum":"2","pageSize":"20"},{"paggNum":"3","pageSize":"20"}]会循环上一步的结果[{"paggNum":"2","pageSize":"20"},{"paggNum":"3","pageSize":"20"}]2)这里的模拟http请求使用的是写
是英文Extract-Transform-Load的缩写,用来描述将。
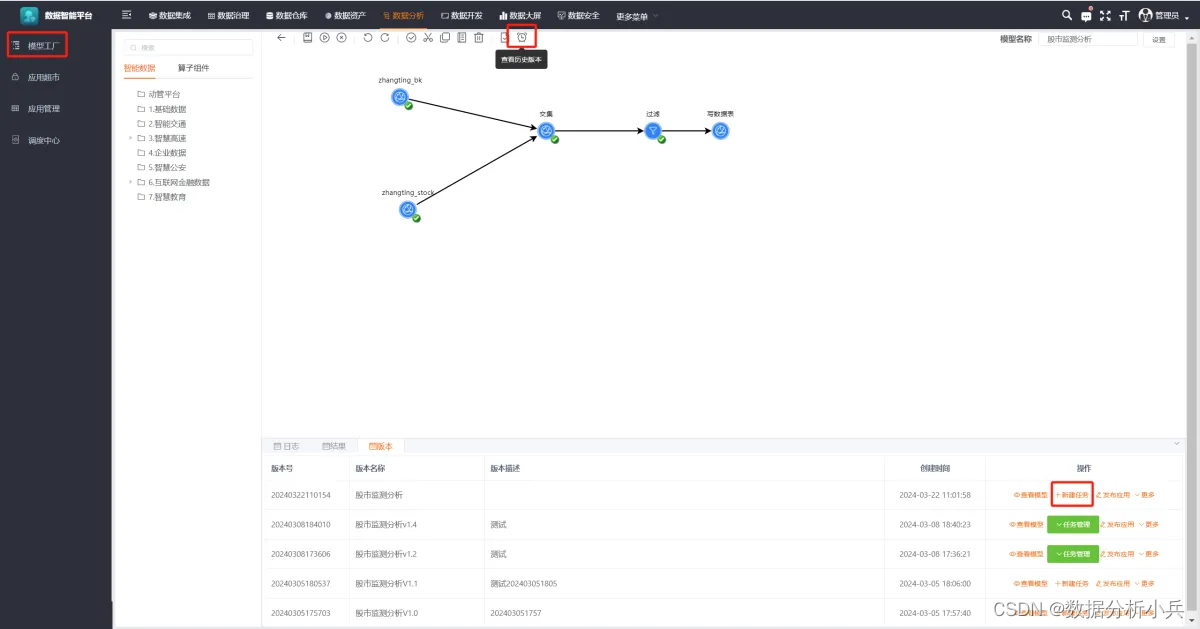
数据建模系统主要由数据集成、数据仓库、模型工厂、任务中心、应用超市和系统管理6部分组成,提供丰富的算子组件,通过可视化拖拽方式进行模型设计,极大的降低了建模的技术门槛,让用户可以轻松高效的完成建模工作。
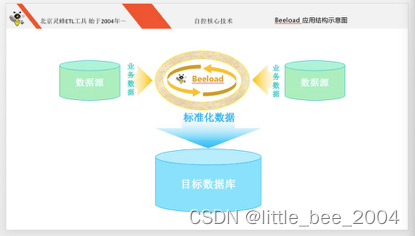
国产ETL工具自控核心Beeload 源自2004年 在公安管控系统中心 应用
编写sqoop的自动shell脚本完成对hive中ods层的增量数据导入
8.3.7 加载演员数据至演员维度表1.打开Kettle工具打开Kettle工具,创建一个转换load_dim_actor,并添加表输入,插入/更新等控件。2.配置表输入控件双击“表输入”控件,进入“表输入”配置界面,单击【新建】按钮,配置数据库连接,配置完成后单击【确认】按钮。在SQL框中编写SQL语句,用于获取字段actor_last_update中的最大值,将该值替换为”1970-01-01
直接步入正题:参数配置软件版本valueoracleOracle Database 19c Enterprise Edition Release 19.0.0.0.0 - Production驱动ojdbc8.jar ,orai18n.jarJDK1.8ETLSpoon 7.1这事是发生在昨天,因之前连接oracle的时候,可以进行连接,但是真正用它的时候连接不上了,后期就问运维的大哥,他说从12
目前正在做的项目需要用将主业务库的部分数据同步出去以作统计用,为了保持数据实时同步需要定时执行同步操作。同步工具运用了比较流行的ETL工具kettle,首先我们在kettle界面工具Spoon中设计好同步文件如 studentTableETL.ktr,然后在web项目通过quartz定时调用studentTableETL.ktr即可。1、以下是pom.xml中的依赖包
.1学习笔记 2012-02-07 08:36:27| 分类:ETL | 标签:kettle |字号大中小 订阅最近公司要用一个ETL工具,Google了一下,发现Kettle用的人好像比较多,于是下载下来试用了一下!首先从网上下载了一些教程学习,主要是针对Spoon设计器的,大部分都比较简单,然后自己摸索,发现Kettle的功能还是很强大的,但
场景:kettle调用https接口,跳过校验SSL。(有些公司内部系统之间的https的接口是没有SSL校验这一说,无需使用用证书的)解决方案:自定义插件或者自定义jar包通过javascript调用https接口。//这里注意参数body如果是json字符串的话,这里自动转换为对象了,1)将自定义jar放到lib目录下。//索引这里要重新转换为字符串。
标准化轻量级数据中台旨在以低成本、快速方式助力企业数字化运营。其优势包括快速启动、灵活扩展、低学习成本及敏捷化服务,助企业应对复杂、高成本挑战,实现业务价值。
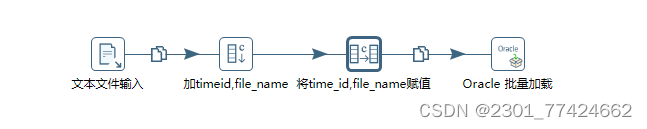
2、控制文件:只需要配置路径以及ctl名称(ctl名称可自定义),程序运行会自动生成ctl。3、日志文件和错误文件同控制文件相同,只需配置相应的存放路径和名称即可,会自动生成。1、kettle流程:文本文件输入---oracle批量加载相应配置。即 82.222.22.22:1527/IPMS。格式为 :数据库服务器名:端口号/数据库名称。,不然就会一直报sqlldr连接不上的错误。数据文件:加载
国产ETL etl-engine 流批一体数据交换引擎 轻量级 跨平台 易集成 适应 物联网 大数据 高可用 场景
1:EOF 漏掉;符号2:dt分区要加3:覆盖写的时候对于分区表要加对应时间4:单双引号问题
有个SQL定时任务,每个月1号,查询上个月1号到上个月最后一天的数据,需要在SQL里面确定时间范围,hive数据表里面的时间格式是yyyyMMdd这个问题,涉及几个时间函数的综合应用,关键点是:时间范围要小于等于上个月最后一天,同时大于等于上个月第一天上个月最后一天:当前时间是当月第一天:trunc(CURRENT_TIMESTAMP,'MM'), trunc(sysdate, 'mm'),返回当
quartz+kettle8二次开发-实现集群高可用quartz+kettle8二次开发-实现集群高可用quartz+kettle8二次开发-实现集群高可用
本文介绍如何通过ETLCloud平台与飞书多维表格API结合,实现数据同步与集成,支持建表、建数据表及写记录,提升企业数据流转效率。
etl-go是一款基于Go语言开发的开源ETL工具,具有可视化界面和轻量高性能的特点。它提供开箱即用的常用数据库(MySQL,PostgreSQL,Doris)和文件(CSV,JSON)支持,通过WebUI实现任务编排、参数设置和执行监控。采用插件化架构,支持数据转换、过滤、脱敏等处理逻辑,内置定时任务调度和变量管理系统。技术栈采用Go+Gin+Vue3前后端分离设计,内置SQLite数据库,无需
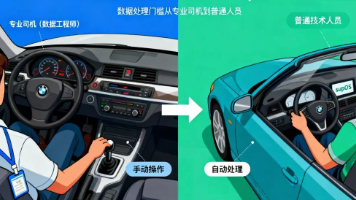
它提供了一个图形化的操作界面,业务人员或实施人员经过一定学习后,可以自主完成数据源的连接、数据处理任务的开发、发布与监控运维,减少了对专业IT或数据工程师的深度依赖。supOS的ETL在Web端通过拖拉拽可视化开发组件和配置的方式,让你可以像搭积木一样灵活编排数据处理流程,屏蔽了背后大数据技术的复杂性,从而显著降低了数据开发的门槛和成本。统一数据接入与集成:supOS工厂操作系统充当统一数据底座,
SQL正则表达式是处理字符串模式匹配的强大工具,主要用于数据验证、内容清洗和信息提取。各数据库通过扩展函数实现正则功能,包括模式匹配(如REGEXP)、替换(REGEXP_REPLACE)和提取(REGEXP_SUBSTR)。使用时需注意不同数据库的语法差异和转义字符处理,大数据量场景下应优先使用简单条件过滤并优化正则模式。正则表达式能显著提升文本处理的灵活性,是数据清洗和分析的重要技能。
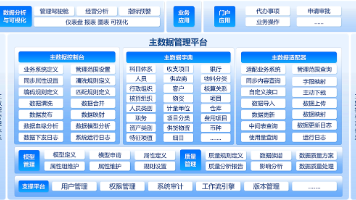
主数据管理系统(MDM)与数据中台本质不同,前者管理核心静态数据(如客户、商品信息),后者处理动态业务数据(如订单、日志)。企业数字化转型应优先建设MDM,因其能快速解决数据质量问题,见效快且成本低。数据中台无法替代MDM,两者需协同工作:MDM确保数据准确性,数据中台实现数据价值转化。现阶段市场更倾向先夯实数据基础,再考虑数据中台建设。
滴滴顺风车业务需要实时地监控和分析订单数据,以支持业务决策和运营优化。为了满足这一需求,滴滴数据团队决定构建一个实时数仓。
如何 部署 及 使用 etl crontab 和 etl engine
3、我现在想把hive中某一张表的数据导出来,就先点击输入下面的表输入,输出就是用什么格式的文件存储,比如我想用csv存储就选择这个文本文件输出。4、点击新建,配置好数据库连接信息,如果你配置了无须用正确的用户名和密码访问就还需要进入选项配置auth=noSasl。6、然后点击导出的csv进行简单的配置,比如保存的目录文件名称,设置分隔符,编码格式等(点击浏览可以设置)。7、然后按住shift键别
为了提高sql的查询效率比如:假如数据量比较大,这个sql就是全表扫描,速度肯定慢。可以将数据按照天进行分区,一个分区就是一个文件夹,当你查询20230826的时候只需要去20230826这个文件夹中取数据即可,不需要全表扫描,提高了查询效率。总结1)分区表实际上就是对应一个HDFS文件系统上的独立的文件夹。2)该文件夹下是该分区所有的数据文件。3)Hive中的分区就是分目录,把一个大的数据集根据
切分多个Task之后,DataX Job会调用Scheduler模块,根据配置的并发数据量,将拆分成的Task重新组合,组装成TaskGroup(任务组)。对于sqoop和datax,如果只是单纯的数据同步,其实两者都是ok的,但是如果需要集成在大数据平台,还是比较推荐使用datax,原因就是支持流量控制,支持运行信息收集,及时跟踪数据同步情况。ETL是将业务系统的数据经过抽取、清洗转换之后加载到
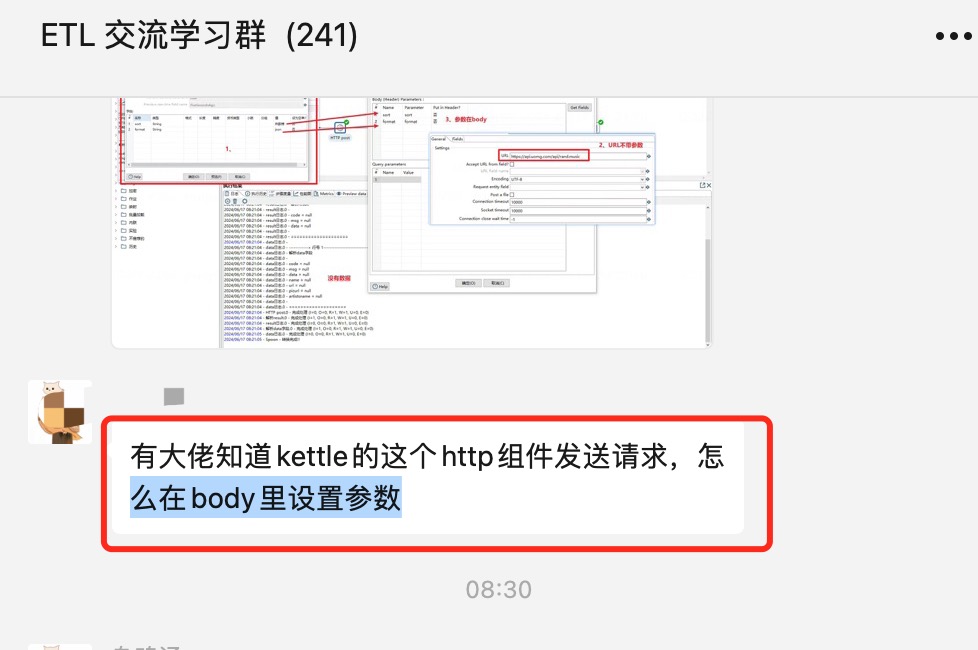
3、http post参数设置,这了填写URL、Request entity field,其他默认。1)从日志可以很清楚的看到接口http://127.0.0.1:5000/api/data的Content-type设置不对。4、定位问题之后,我们把Content-type设置为Application/json,进行再次验证,接口调用成功。2)以行级日志模式进行运行,可以看到默认的Content-
navicate连接postgresql数据库不成功,报 错:字段datlastsysoid找不到
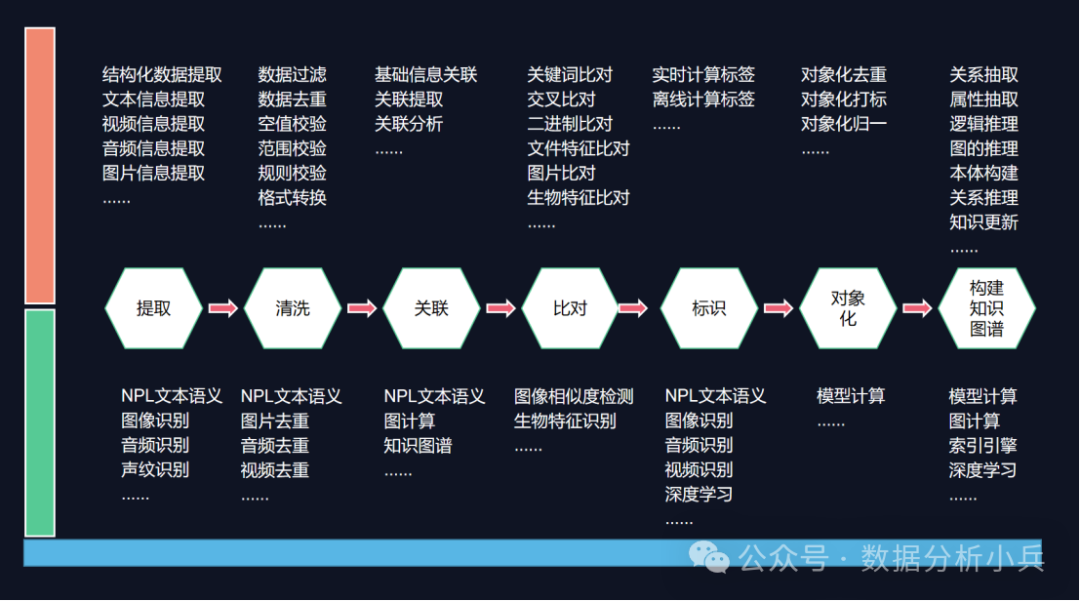
数据加工处理是实现数据标准化的过程,包括了数据的提取、清洗、关联、比对、标识、对象化等操作,支持实时计算和离线计算,支持批量处理操作。数据传输过程支持分布式数据传输方式。在数据处理过程中,引入人工智能技术,实现结构化和非结构化数据的处理,采用图计算和内存计算技术,实现数据的价值提升。在数据处理过程中,引入模型体系和标签工程和知识图谱技术,进一步提升数据价值密度,为数据智能应用实现数据增值、数据准备
希望对大家有帮助,谢谢大家的支持!!❤️❤️❤️
就是成本F由两个要素确定,一个是实际位置的成本G,由其自身固定的地理位置决定,另一个是启发值H,由下一个位置与目标位置的相对距离决定,然后在循环中,是要找下一个成本最小的F。只考虑G成本不考虑启发值的A*就是朴素的dij。堆优化dij可以认为是一个A*算法。H为启发值,由启发性公式决定,,体现了当前的步数成本。
Pentaho Community Edition Download | Hitachi Vantara
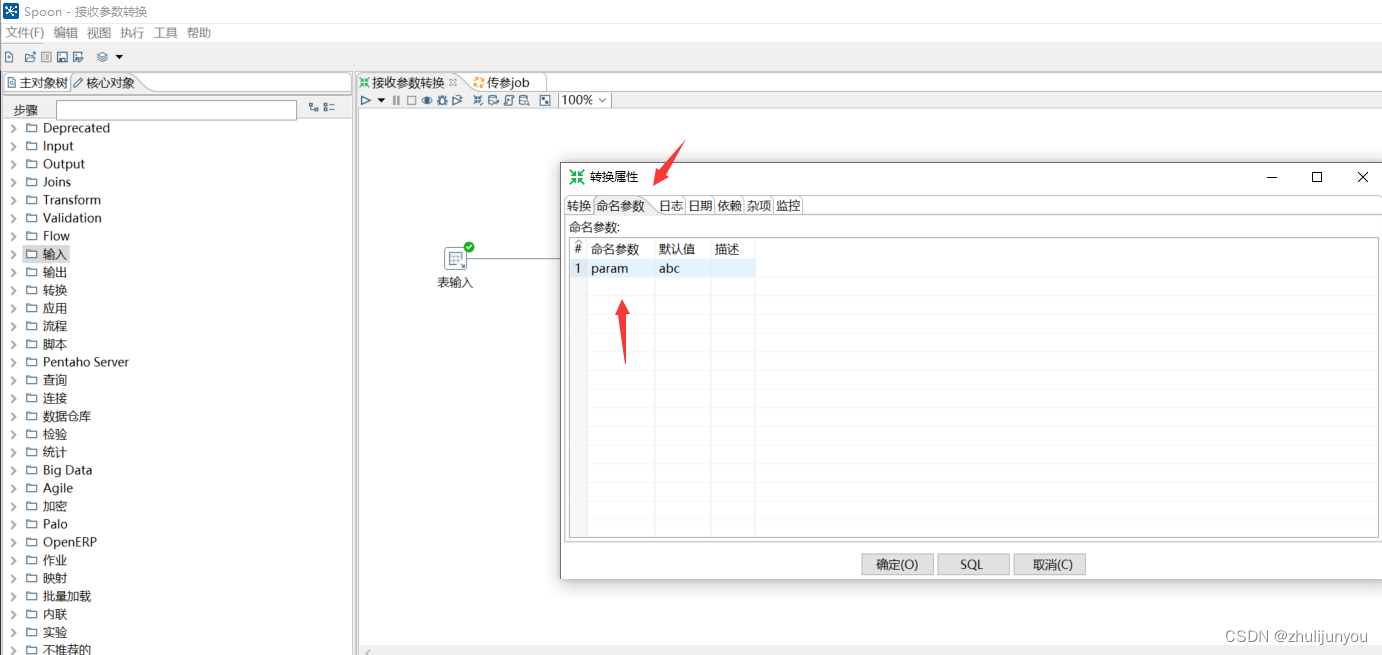
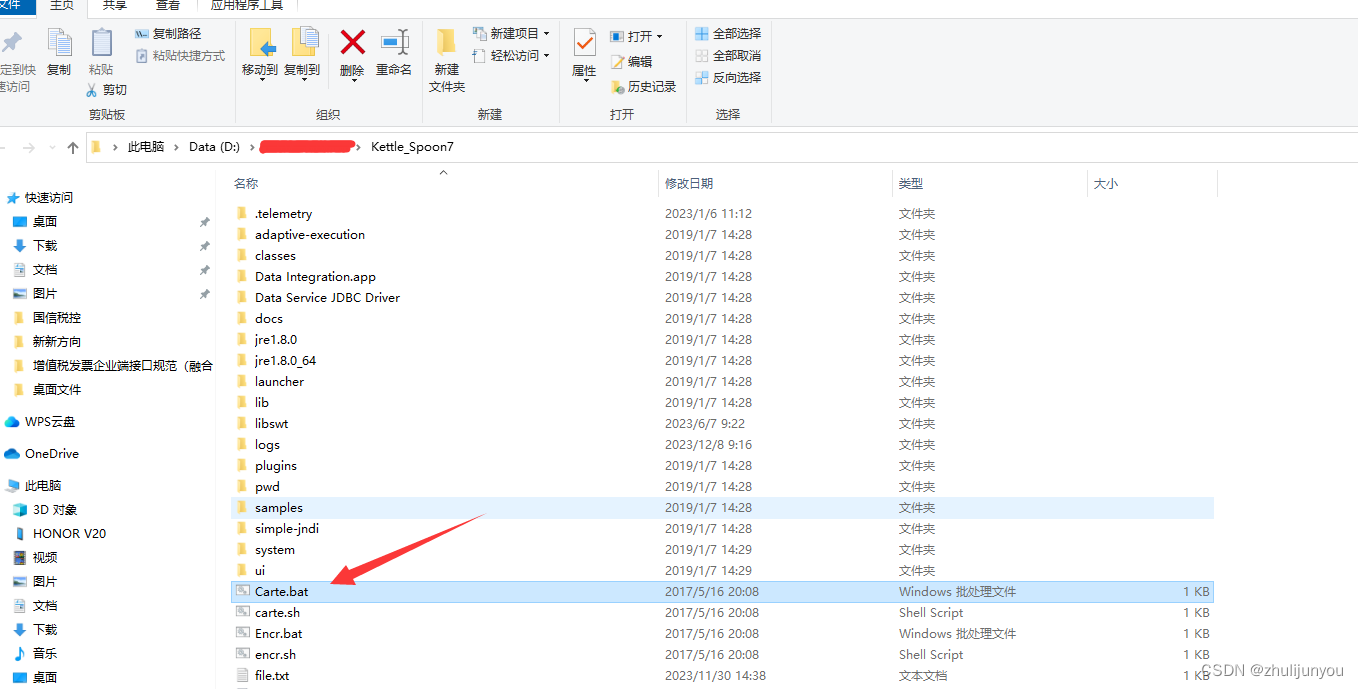
使用carte方式发布kettle任务之后,可以通过http方式启动,停止,监控 服务的运行。同时启动的时候可以把自定义的参数一同传递给job或转换任务,本文简单介绍如何传参。
Carte:轻量级的HTTP服务器(基于Jetty),后台运行,监听HTTP请求来运行一个作业。可以用来 http 请求允许,停止 ,监控 job和trans的运行。其也用于分布式和协调跨机器执行作业,也就是Kettle的集群。运行Carte的服务器在kettle术语里称为slave server。
【代码】kettle simple-jndi 配置中心。
2023/07/22 11:03:13 - JavaScript代码.0 -at org.pentaho.di.trans.steps.scriptvalues_mod.ScriptValuesMod.processRow(ScriptValuesMod.java:548)2023/07/22 11:03:13 - JavaScript代码.0 -at org.pentaho.di.trans.s
etl
——etl
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 乐奇 Rokid 开放社区









 天工造物局