登录社区云,与社区用户共同成长
邀请您加入社区
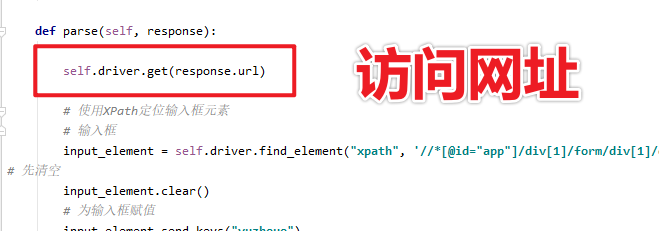
md知乎的程序猿是干什么的我不知道,反爬真不一般,深受其害!!!试了一千万种方法,哎,终于呀(千万不要被知乎的程序猿看到了,要不然就又要凉凉了),其他方法特别是用request的好像都失效了(哪位大神要是还能用告诉兄弟一声)算是半手动吧,selenium里面的js模块实在不会,还望大神看到了指教一下,这只是个半成品,但是基本登陆还是有的,使用第三方账号登陆,绕过验证码,(注意是第三方,...
好久没用过scrapy,这两天用到了,写了一个爬虫,今天一运行,竟然报错了,突然一下有点摸不着头脑因为用到了linkextractor了,网上搜了半天也没有类似的问题,报错截图spider部分代码截个图然后item、pipline、settings、middware一路检查...
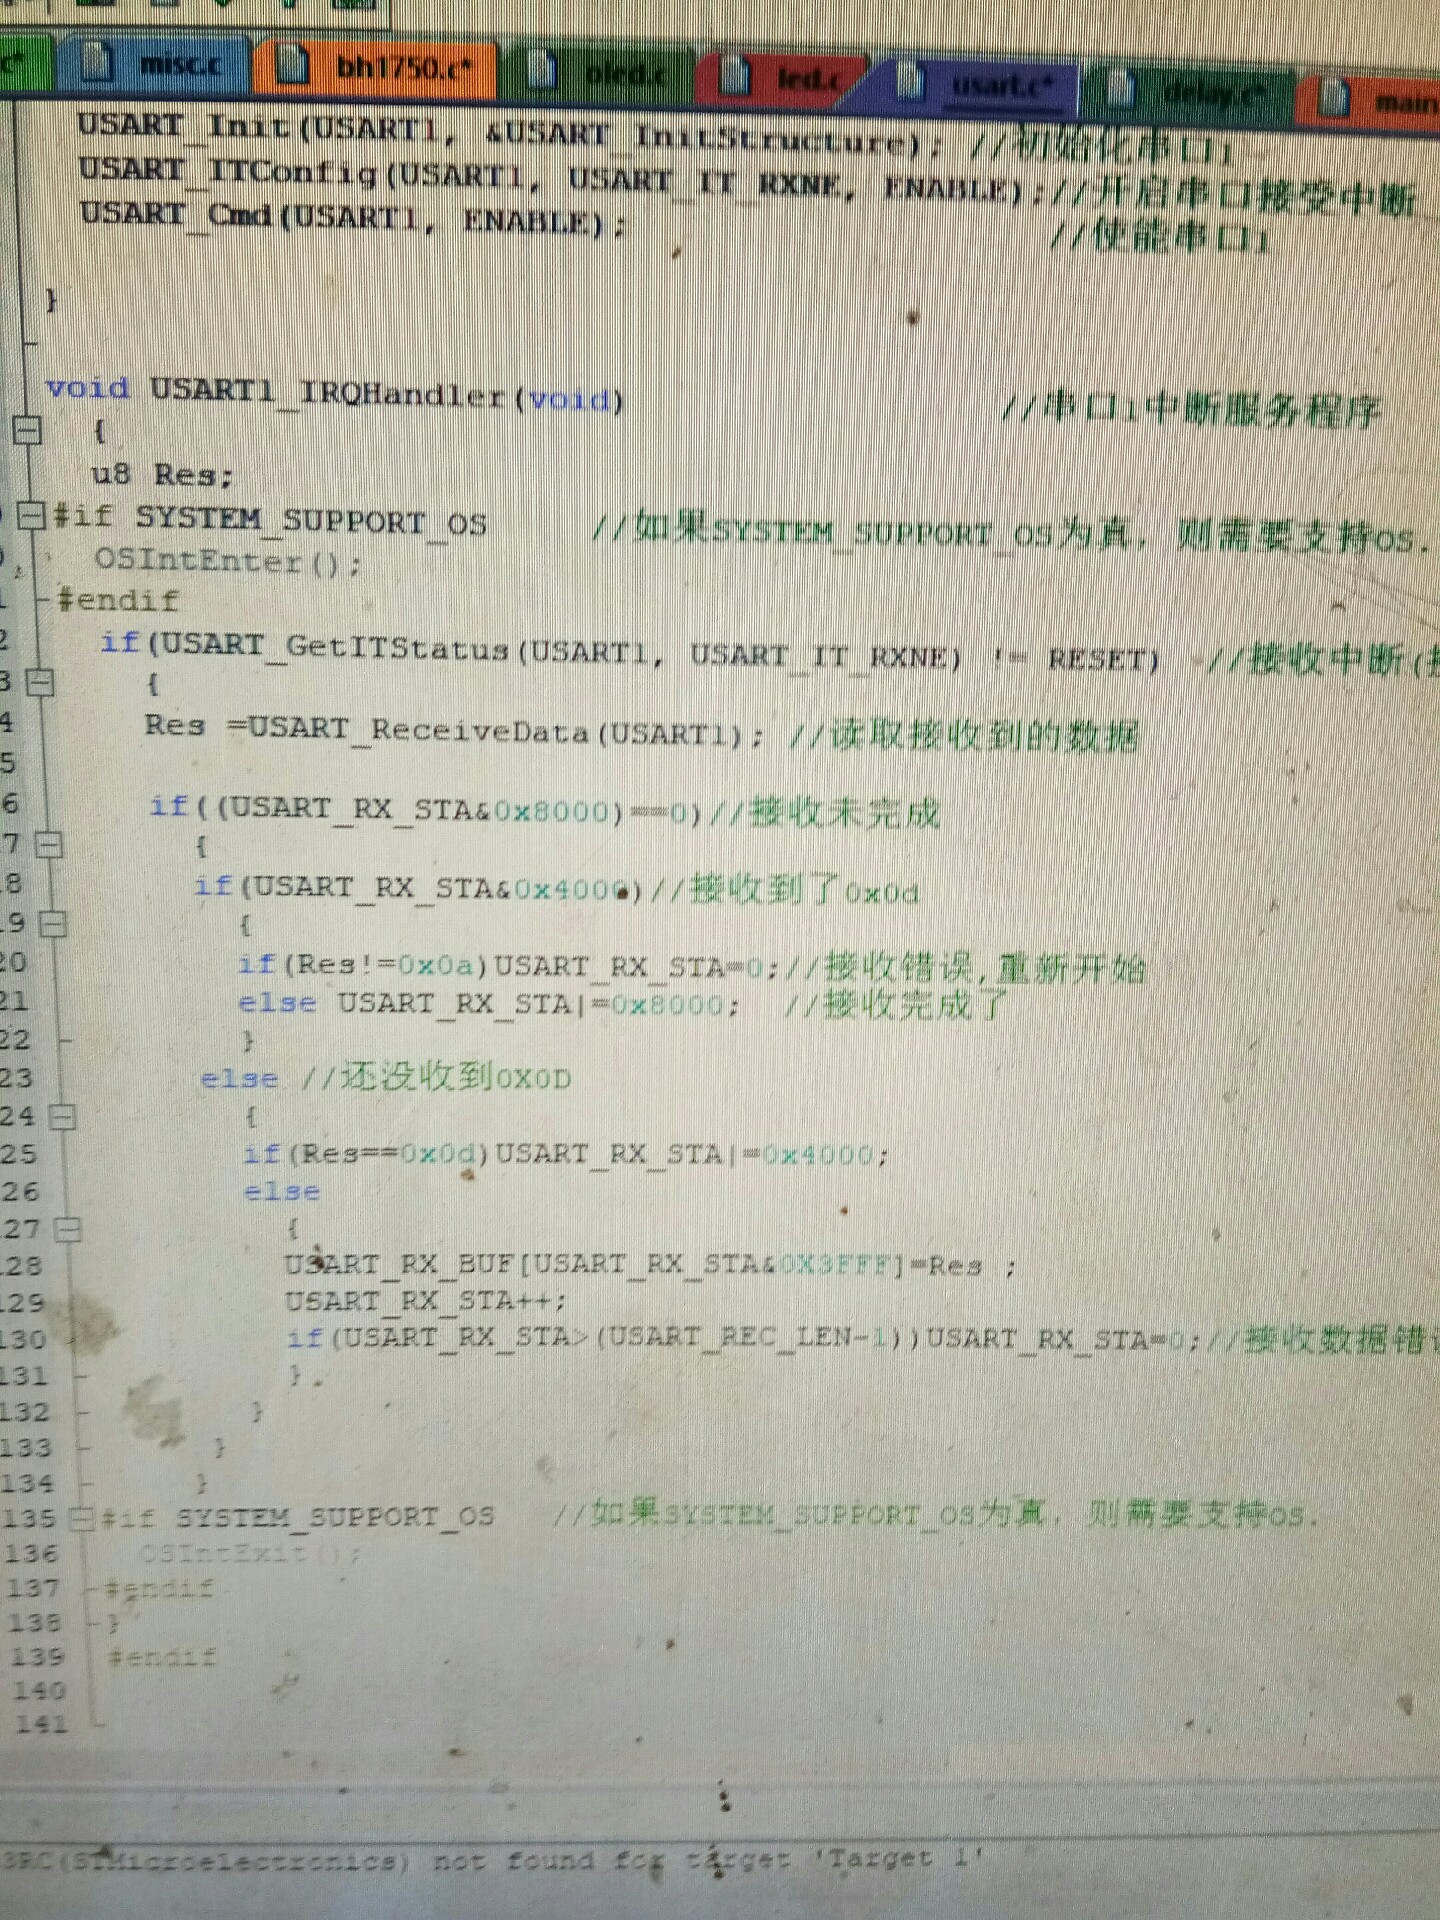
先看硬件接线(原理图其实就几条线):BH1750和0.96寸OLED都是I2C设备,直接挂在同一组I2C总线上就行。刚玩STM32那会儿总想搞点有意思的传感器联动,最近用BH1750光照传感器配了个OLED屏,实测效果还不错。STM32和BH1750光照传感器和IIC总线通讯OLED显示程序源码,通过BH1750,光照传感器采集光照信息,通过oled显示光照值。STM32和BH1750光照传感器和
摘要 Selenium和BeautifulSoup是Python中两大重要的Web抓取工具,分别擅长处理动态网页和解析静态HTML。结合使用二者可以显著提升数据采集效率:Selenium模拟浏览器行为获取动态内容,BeautifulSoup解析提取结构化数据。本文介绍了安装配置方法、基本使用流程(Selenium加载页面+BeautifulSoup解析)、实用技巧(模拟交互、等待加载、滚动页面、处
F12再右键复制XPATH。
②点击账户登录,随意输一个手机号,密码随便输。①安装完成后登录面板。
它可以自动帮你识别当前运行环境下系统信息以及对应浏览器信息,并自动下载对应的webdriver,再也不用担心webdriver版本问题!!!
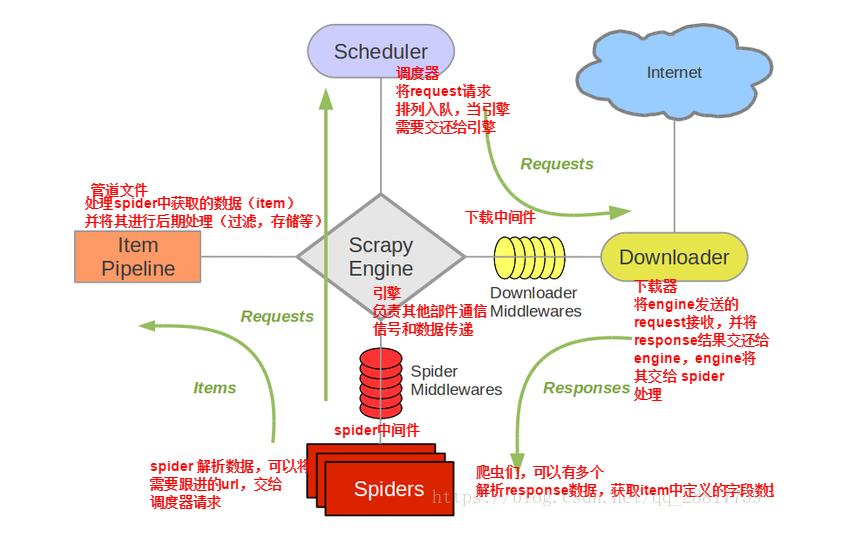
当引擎将国内板块url对应的请求提交给下载器后,下载器进行网页数据的下载,然后将下载到的页面数据,封装到response中,提交给引擎,引擎将response在转交给Spiders。Spiders接受到的response对象中存储的页面数据里是没有动态加载的新闻数据的。要想获取动态加载的新闻数据,则需要在下载中间件中对下载器提交给引擎的response响应对象进行拦截,切对其内部存储的页面数据进行
解决scrapy命令执行代码(scrapy crawl xxx)运行报错问题
本文主要讲述模拟登录。
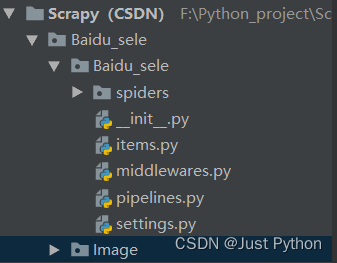
Scrapy中使用seleniummiddlewares.pysettings.pybai_sele,py
机器学习(ML)是人工智能的一个分支,它使计算机无需显式编程即可从数据中学习模式。ML 模型会识别数据集中的趋势,从而基于新的输入进行预测和决策。从股票市场分析到图像识别,机器学习在现代技术中都至关重要。然而,ML 模型的有效性取决于用于训练它的数据质量和数量。这正是网页抓取变得不可或缺的地方。确定你需要的网站和数据。例如,从 Yahoo Finance 抓取股票价格,可以作为构建预测性 ML 模
基础命令scrapy3 startproject demo [project_dir]在project_dir目录下创建一个Scrapy项目。如果project_dir未指定,project_dir则与相同myproject。cd demo 进入到项目内scrapy genspider mydomain mydomain.com创建一个蜘蛛爬虫全局命令:startpr...
本文仅作经验分享,不做商业用途,如涉及权利问题,请通知删除。scrapy+selenium爬取淘宝商品信息建立scrapy项目对目标网站进行分析selenium模拟登录合理的创建标题,有助于目录的生成如何改变文本的样式插入链接与图片如何插入一段漂亮的代码片生成一个适合你的列表创建一个表格设定内容居中、居左、居右SmartyPants创建一个自定义列表如何创建一个注脚注释也是必不可少的KaTe...
Downloader Middleware (下载中间件) 是 Scrapy 中处理请求/响应 的 hook(挂钩) 框架。是处于 Scrapy 的 Engine 和 Downloader 之间的处理模块。用于全局更改 Scrapy 的请求和响应。
我又滚回来更新了,这一次我们的目标是网易云音乐,想要通过输入歌单的链接,然后把整个歌单的歌曲都下载下来,说做就做,看看这一次有会遇见怎样的问题把。需要注意的点:这一次使用的框架仍然是scrapy,不同于上个框架的是这一回加上了selenium,我是蛮不想借助这个的,但是让工具发挥他最大的用处,这才是我们该做的VIP才能下载的音乐依然无法下载,现在还没有那个实力,只能下载歌单中不是vip的音...
scrapy的cookie不生效,需要在项目的settings文件中修改# Disable cookies (enabled by default) .COOKIES_ENABLED = False这样你spiders中的cookie才会生效
用scrapy对接selenium可以实现返回渲染好的页面,但是selenium是阻塞式的,也就是说,它每次只能进行一次请求,这样就会比较慢,所以并不推荐这种方法,今天这样做,只是为了练习一下下载中间件的使用,如果真要提取渲染好的页面,还是是用scrapy的Splash插件比较好用scrapy对接selenium,必须用到现在中间件,我们知道,下载中间件可以对请求,响应或是错误进行处理。我...
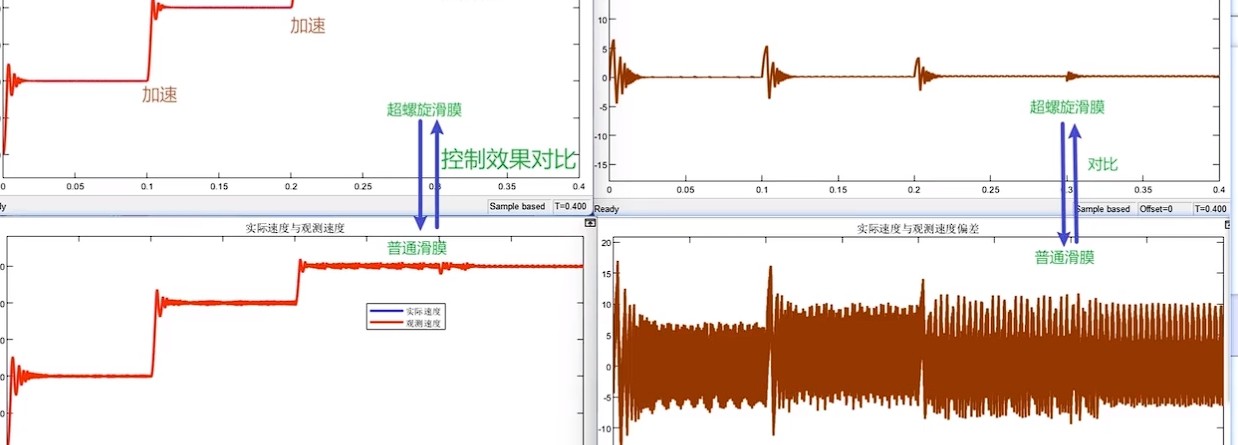
基于超螺旋滑模观测器的永磁同步电机无位置传感器控制策略全套仿真、公式推导、配套论文以及调试过程在电机控制领域,永磁同步电机(PMSM)因其高效、高功率密度等优点被广泛应用。然而,传统的PMSM控制通常依赖位置传感器来获取转子位置信息,这不仅增加了系统成本和复杂性,还降低了系统可靠性。于是,无位置传感器控制策略应运而生,今天咱们就来聊聊基于超螺旋滑模观测器的这种控制策略,顺带分享下全套仿真、公式推导
1.微步在线微步在线提供一种全面的安全情报查询工具,支持全球范围内的IP、域名、Hash、URL、Email、漏洞、关键词查询功能,能够快速识别已知威胁,并提供丰富的上下文数据用于进一步分析,以发现未知威胁。此外,还提供高级查询功能,包括IP的PDNS数据、域名历史Whois、子域名数据等,助力对攻击事件中域名、IP的关联资产进行拓线分析和数据溯源,获取更多幕后攻击团伙的攻击资产信息,以及个人身份
随着的发展和时代的到来,网络已经日渐深入到我们生活、工作中的方方面面,社会信息化和信息网络化,突破了应用信息在时间和空间上的障碍,使信息的价值不断提高。但是,与此同时······网页篡改、计算机病毒、系统非法入侵、数据泄密、网站欺骗等信息安全事件时有发生。在这种背景下,加快了““的发展速度。是指遵照信息安全管理体系和标准工作,防范黑客入侵并进行分析和防范,通过运用各种安全产品和技术,设置防火墙、防
如果要问当下知名的大厂公司,想必同学们脱口而出的便是阿里巴巴、腾讯、京东等企业。其实,不同行业都有属于它的知名厂商,比如网络安全。作为当下的朝阳行业,网络安全已逐渐成为年轻职场人转行的热门首选,而备受青睐的原因之一,便是所在行业具备的产业规模与企业数量。毕竟要看一个行业是否具有发展前景,其厂商实力便是一种彰显,公司多,说明市场需求大,即象征行业的繁荣。本期,知了姐整理出一份网络安全知名厂商名单,大
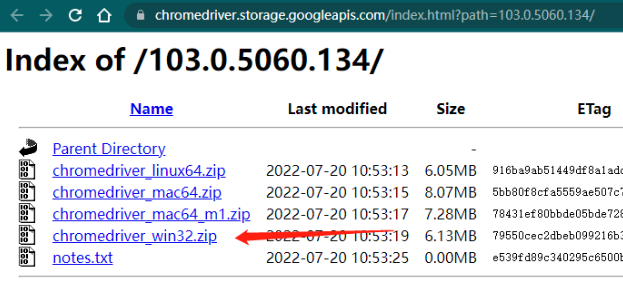
很长时间没有再用谷歌的Chrome浏览器插件做自动化相关的内容了, 最近场合需要使用了下, 发现目前很多国内的景象-淘宝-阿里-豆瓣了 的chromedriver网址都不在维护了, 谷歌官网的下载地址:这个国内需要fan出去才能访问到很不方便。
用selenium模拟搜索爬取酷狗试听歌曲及歌词
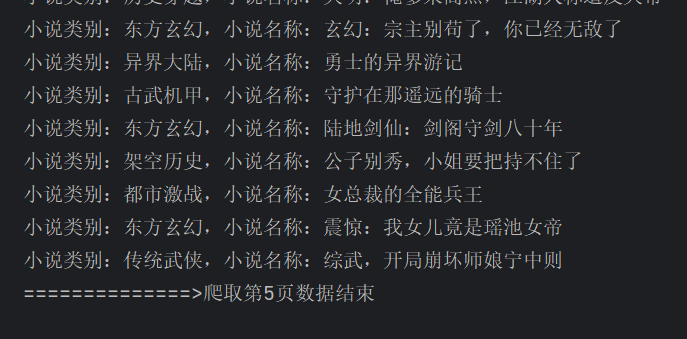
简介本文主要讲常规分页爬取与利用Scrapy框架怎么快捷的爬取分页的数据以及cookie登录,案例网站时17k小说网,url是https://www.17k.com/常规分页爬取Scrapy框架分页爬取cookie登录分页常规分页爬取常规分页爬取,直接观察页面数据,一共有多少页数据,就for循环多少次class Xiaoshuo17ptSpider(scrapy.Spider...
记录scrapy+selenium
【代码】scrapy genspider时报AttributeError: ‘SelectReactor‘ object has no attribute ‘_handleSignals‘
使用WebDriverWait和expected_conditions来等待元素加载。执行滑动操作,可以调用execute_script方法来模拟滑动。使用Selenium定位到滑动条元素。
学习3:scrapy请求对象、模拟登录、POST请求、管道的使用、crawlspider爬虫类
在 Scrapy 中,我们使用 Item 对象来表示爬取到的数据。为了清晰地组织数据,我们需要定义一个数据模型来描述我们感兴趣的信息。在这个项目中,我们主要关注豆瓣电影 Top250 页面中的电影信息,因此我们创建一个名为MovieItem的数据模型来存储这些信息。# 定义了要爬取的关键信息字段ranking = scrapy.Field() # 排名name = scrapy.Field() #
用playwright结合多线程爬取头条图片
不知道你们用的什么环境,我一般都是用的Python3.6环境和pycharm解释器,没有软件,或者没有资料,没人解答问题,都可以免费领取(包括今天的代码),过几天我还会做个视频教程出来,有需要也可以领取~给大家准备的学习资料包括但不限于:Python 环境、pycharm编辑器/永久激活/翻译插件python 零基础视频教程Python 界面开发实战教程Python 爬虫实战教程Python 数据
Scrapy,Python开发的一个快速、高层次的屏幕抓取和web抓取框架,用于抓取web站点并从页面中提取结构化的数据。Scrapy用途广泛,可以用于数据挖掘、监测和自动化测试.其最初是为了页面抓取 (更确切来说, 网络抓取 )所设计的, 后台也应用在获取API所返回的数据(例如 Amazon Associates Web Services ) 或者通用的网络爬虫.Scrapy吸引人的地方在于它
[scrapy.spidermiddlewares.offsite] DEBUG: Filtered offsite request to 'XXX'错误处理方法
该短视频智能推荐的开发和设计根据用户的实际情况出发,对系统的需求进行了详细的分析,然后进行系统的整体设计,最后通过测试使得系统设计的更加完整,可以实现系统中所有的功能,在开始编写论文之前亲自到图书馆借阅 Dango框架书籍,MYSQL数据库书籍等编程书籍,然后针对开发的短视频智能推荐,去网上查找了很多别人做好的系统,参照他们的设计结果,来对自己的系统进行更加详细的系统的设计,将系统中所有的功能结果
等均报错: Fatal Error: The system cannot find the file specified. 此为一个罕见的故障, 直接原因还是Python解释器没找到的问题.Scrapy可能自身在初始安装时就保存了python.exe的路径, 而用户可能某个时候修改过python.exe的上级目录名, 导致Scrapy保存的旧路径不管用了.但如果PyCharm里已经正确设置了Pyt
昨天我遇到了一个有趣的问题,一个同事的代码中出现了一个报错,报错信息为:[scrapy.spidermiddlewares.offsite] DEBUG: Filtered offsite request to...
根据文章标题的需求我只需要使用在以上的文件进行编码就行了,加入要使用到其他的接口爬取方法就要去更改testSpider/setting.py里面的设置,如果感兴趣可以参考我之前的文章:使用Scrapy框架爬取V2ex看看程序员中秋节都在讨论啥。通过selenium可以绕过一些关键的有反扒的接口,得到一些重要的信息。我们学习必然是为了找到高薪的工作,下面这些面试题是来自阿里、腾讯、字节等一线互联网大
数据存入mongodb及多页爬取操作
selenium技术、动态加载
使用scrapy+ selenium + 超级鹰
前一段时间构建了一个使用scrapy+selenium+pyqt5的爬虫可视化界面,用于爬取知乎、百度百家号以及新浪新闻,在界面调试无误后,就需要使用pyinstaller进行打包,将项目变成更容易移植的exe文件。这篇博文主要用于记录打包的主要过程以及问题的解决方法。1. pyinstaller的安装一般来说,使用常用的pip命令即可安装,但我在安装时遇到了如下问题:Installing bui
很多网站是需要登陆的,并且有自己的登录逻辑,通过selenium可以实现模拟网站登录以及事件的点击,是一种比较难拦截的爬虫方案。先决条件:(1)首先需要引入selenium和requests类,在requirements.txt中加上这两个以后,在venv中执行pip install即可,一定要在venv中执行,否则可能报错。(2)安装对应的chromedri...
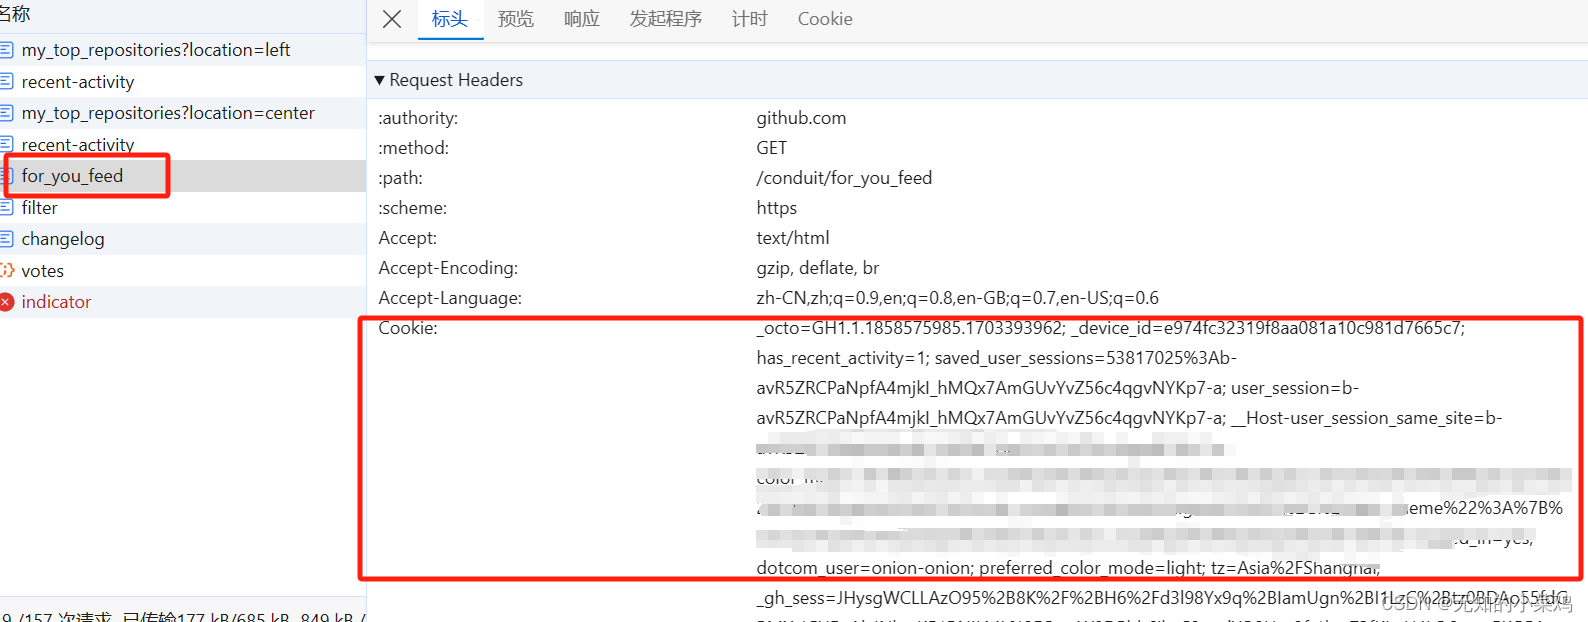
1、请求CookieCookie = response.request.headers.getlist('Cookie')print(Cookie)2、响应Set-CookieCookie2 = response.headers.getlist('Set-Cookie')print(Cookie2)注意:爬虫时一般要获取网页上的cookie是指第一个请求Cookie...
Spider.parse callback is not defined在scrapy中,用FormRequest写post请求登陆人人网的时候,报错Spider.parse callback is not defined代码是这样的# -*- coding: utf-8 -*-import scrapy# from scrapy.spiders import CrawlSpider...
先送上传送门,scrapy中文网,画风清奇的使用说明网站:http://www.scrapyd.cn/doc/139.html安装完python就可以一键安装scrapy了pip3 install scrapy新建一个项目scrapy startproject stock看到如下输出:You can start your first spider with:cd st...
基于selenium+scrapy爬取复仇者联盟4豆瓣影评数据参考资料:黑马程序员爬虫教程静觅爬虫教程mac下anaconda安装selenium+PhantomJSscrapy下载中间件结合selenium抓取全国空气质量检测数据使用xpath的轴(Axis)进行元素定位以下内容只用于学习使用,请勿用于商业用途.五一放假看了《复仇者联盟4》,对影片内容不是很懂,所以写个爬虫,...
继前一篇文章用nodejs+puppeteer+chromium爬取了这个英雄资料后,在本篇同样爬这个页面,思路都差不多,只是用不同语言来实现,可作为参考,个人觉得爬虫还是nodejs比较好用,可能是我python太菜吧本例环境和所需第三方包:python3、pycharm、selenium2.48.0(用3.0+版本会报错,因为新版本放弃phantomjs了,当然也可以用chrome和fir..
scrapy中有三种方式设置headers,cookiessetting中设置cookiemiddlewares中设置cookiesipder文件中重写start_requests方法这里记录第三种,重写start_requests方法,这里以豆瓣网为例一、设置请求头headers在start_request中新增headers = {'User-Agent'...
项目名/spiders/爬虫名.py(爬虫,携带cookie登录):# -*- coding: utf-8 -*-import scrapyimport reclass RenrenSpider(scrapy.Spider):name = '爬虫名'allowed_domains = ['renren.com']start_urls = ['ht...
scrapy
——scrapy
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 乐奇 Rokid 开放社区





 亚马逊云科技技术品牌专区


 天工造物局