登录社区云,与社区用户共同成长
邀请您加入社区
在硬盘批量拷贝现场,最让人头疼的往往不是速度,而是“意外”。如果你的产线常被电脑蓝屏、系统弹窗或误操作覆盖拖累,又希望把拷贝岗位的培训成本降下来,PD800 这类“脱机 + 4 键极简”的工业级拷贝机值得纳入现场评估——它不一定适合所有个人备份场景,但对于稳定、重复、可管理的批量拷贝任务,能明显减少系统环境带来的不确定性。电脑克隆方案需要操作系统、驱动、拷贝软件与硬盘接口协同工作,这些看似常规的组
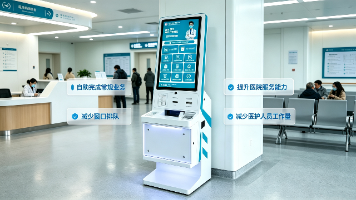
而真正适配信创环境的版本,需要做到软硬件双向适配——绝非简单更换某一零部件,而是整套系统在国产生态中经过完整调试,确保挂号、缴费、打印等各项业务功能均可正常、稳定运行,方为合格。信创环境下的医院自助终端服务系统,并非简单更换国产操作系统,而是指整套软硬件体系完整运行于国产生态之上,涵盖国产芯片、国产操作系统、国产数据库及中间件,满足医院信创项目建设要求,从根本上减少对国外软硬件的技术依赖,是医疗行
大家好!工业自动化控制正向更严苛的微秒级同步迈进,EtherCAT 芯片在伺服驱动器、工业机器人及分布式 I/O 模块中的重要性日益凸显。当下的工业核心部件市场正处于新老交替的节点:需求端不仅面临着海外供应链的长交期波动压力,也越来越重视国产替代方案带来的长期成本优势。然而,工业通信控制芯片的选型绝非简单的概念炒作,而是必须建立在极高的试错成本、底层协议可靠性验证以及规模量产实绩之上。
MindSpore-Transformers LLM数据预处理模块针对大模型训练中的海量数据访问痛点,通过索引预构建、内存映射(MMap)、索引层shuffle与分布式分片,实现百万至千万级数据集的低内存、高随机访问。支持JSONL、Parquet、二进制等多格式,兼容昇腾NPU集群,有效解决全量加载内存爆炸、顺序读取瓶颈、多卡重复采样等问题,显著提升预训练与指令微调效率,助力高效、可复现的大规模
MindSpore-Transformers提出面向昇腾NPU的Transformer模块规范,统一Attention、MLP、DecoderLayer等核心组件的接口、命名与权重映射,解决迁移中权重对齐难、分布式并行适配失败、算子替换困难等问题。遵循该规范可实现HuggingFace模型低成本、高质量迁移至MindSpore生态,原生支持MindSpeed训练、LoRA微调、MindIE推理及全
MindSpore-Transformers是适配昇腾NPU的大模型推理套件,兼容HuggingFace接口,结合MindIE引擎与FastAPI框架,实现高性能、低延迟的LLM服务化部署。支持动态批处理、流式输出、多并发调度与PagedAttention显存优化,覆盖对话机器人、API服务、批量文本处理等场景,提供端到端生产级推理能力,助力大模型在昇腾生态快速落地。
本文记录 GSV5800 国产 4K Serdes 长线传输芯片选型评估,梳理光纤 / 同轴 / STP 多介质延长、音视频 + 双向控制共线传输能力,介绍 AI 机房远程操作台、工业视觉、医疗影像场景,分享阻抗匹配、HDCP、控制通道调试踩坑点,适合做远距离 4K 视频延长方案的硬件工程师参考。
本文系统阐述了TensorFlow模型向昇思MindSpore迁移的全流程,涵盖转换背景、三大开发模式(自动转换、手动映射、ONNX中转)、核心约束与关键步骤。重点强调冻结pb为必要输入,需处理卷积/全连接权重维度转置、算子语义差异及Dropout丢失问题。通过MindConverter工具实现自动化转换,结合精度对齐校验与MindIR导出,确保模型在昇腾NPU上正确部署。总结指出:优先使用工具转
UDP桥接IP核是专为FPGA设计的千兆以太网通信方案,纯硬件实现UDP/IP协议,支持自动校验与重传,确保零丢包、低延迟(<100μs)、高带宽(125MB/s),无需CPU或操作系统。通过标准AXI接口无缝集成于Xilinx、Intel、安路等主流FPGA,大幅降低BOM成本与开发复杂度。配套提供Windows/Linux DLL及完整API,支持设备发现、寄存器读写、高速传输与I2C透传。参
本文基于昇思MindSpore与昇腾NPU,全流程演示大模型在中文关系抽取中的落地实践。通过指令微调+LoRA低秩适配,实现高效微调与部署,涵盖数据处理、模型训练、推理验证及Gradio可视化,并支持MindIR导出与线上服务部署,助力知识图谱、RAG等场景快速构建结构化关系三元组。
本文介绍昇思MindSpore基于昇腾NPU的高效大模型推理方案,覆盖交互式对话、离线批量生成、超大模型多卡并行及高并发服务化四大场景。通过启用KVCache增量推理(use_past=True)、流式输出、动态批处理、量化压缩与模型并行等技术,结合CANN8.5与MindSpore-Transformers1.9环境,实现低时延、高吞吐的生产级部署。实操案例涵盖流式生成、多batch推理、多卡切
本文基于昇思MindSpore与昇腾NPU,以CIFAR-10和ResNet50为例,系统演示图像分类全流程:涵盖数据增强、网络构建、训练调优、评估推理及部署。通过MindData实现高效数据流水线,利用Model高阶API简化开发,结合图模式与分布式训练释放硬件性能。重点介绍昇腾平台调优要点:启用图模式、合理设置batch size、使用预训练模型迁移学习,并规避归一化错误、数据泄露等常见问题,
本文提出一种纯FPGA+UDP桥接方案,以硬件逻辑替代ARM核与Linux协议栈,实现零延迟、确定性通信。通过AXILite/AXIStream接口直连上位机,支持微秒级启动、无操作系统开销,适用于高速数据采集与实时控制。方案集成ARP/ICMP响应、硬件校验与自动重传,保障UDP可靠性,并提供免驱动的C++ API,显著提升开发效率与系统稳定性。
本文系统阐述了在昇腾NPU上通过昇思MindSpore全栈优化提升大模型吞吐量的策略。基于图编译、算子融合、内存复用、PageAttention、ZeroBubbleV并行及动态batching等技术,从训练到推理全流程优化,结合可运行代码与benchmark工具,实现token吞吐逼近硬件上限。重点解决显存碎片、通信开销、调度瓶颈等问题,助力开发者高效释放算力,降低部署成本,尤其在多模态强化学习
昇思MindSpore结合MindStudio,实现RoBERTa在SST-2情感分类任务的高效提示学习。通过软提示调优,冻结主干网络,仅训练少量可学习向量,显著降低显存开销与过拟合风险。依托掩码模板与Verbalizer映射,复用MLM范式完成分类,支持少样本场景。全流程涵盖数据预处理、冒烟验证、精度调试与推理评测,借助Dump、溢出检测与跨平台比对,快速定位数值偏差与配置错误,调试周期由天级缩
本文系统介绍昇思MindSpore-Transformers中上下文学习(ICL)的原理与实践,涵盖从Prompt构造、模型推理到性能优化全流程。基于昇腾NPU,通过开启KV-Cache增量推理、序列并行与Ring-Attention等技术,有效缓解长序列导致的显存暴涨与Prefill耗时问题。强调合理设计示例数量与模板规范,结合use_past、Prefix-Cache等优化手段,提升ICL稳定
实现纯 FPGA 多通道以太网数据采集系统的微秒级确定性延迟,核心在于,采用。通过硬逻辑直接处理数据从采集、缓存到网络封装的全流程,消除操作系统调度抖动和中断延迟。### 1. 核心架构:全硬件数据通路系统不依赖任何软件驱动或操作系统内核,数据在 FPGA 内部通过固定的硬件模块流转,确保每一步操作的时钟周期数固定且可预测。2.1 消除协议栈软件开销传统方案中,TCP/IP 协议栈运行在 CPU
从并行调度、模型级创新、昇腾适配、芯片内数据流和源码实现分析 DeepInfer。
本文对比了Linux内核中常见的内存分配API,重点分析了它们在DMA场景下的适用性。核心区别包括物理/虚拟连续性、缓存一致性、最大尺寸等特性。文档特别强调DMA专用API(如dma_alloc_coherent)与通用分配函数(如kmalloc)的关键差异,指出前者提供硬件级缓存一致性保证。文章提供了详细的选择指南:DMA场景推荐使用dma_pool_alloc/dma_alloc_cohere
在我们编写的代码编译完生成可执行程序之后,下一步就是使用 shell 把它加载起来并运行之。一般来说 shell 进程是通过fork+execve来加载并运行新进程的。一个简单加载 helloworld 命令的 shell 核心逻辑是如下这个过程。// shell 代码示例...if (pid==0){ // 如果是在子进程中//使用 exec 系列函数加载并运行可执行文件} else {....
Linux kprobes技术是一种可以跟踪内核函数执行状态的轻量级内核调试技术,利用kprobes技术可以在运行的内核中动态的插入探测点,当内核运行到该探测点后可以执行用户预定义的回调函数,以收集所需的调试状态信息而基本不影响内核原有的执行流程。{return 0;}.symbol_name = "do_fork", // 要追踪的内核函数为 do_fork.pre_handler = hand
内核组成: uname命令内核:uname,mkinitrd,dracut模块: lsmod,modinfo,depmod,modprobe,insmod,rmmod/proc,sysctl,/sys,/dev,udevadm,hotplug命令一、静态视角:Linux内核模块 吸收微内核设计:支持模块化设计: 内核中模块 .ko (kernel...
什么是Initrdinitrd的英文含义是 boot loader initialized RAM disk,就是由boot loader初始化的内存盘。在 linux内核启动前, boot loader 会将存储介质中的 initrd 文件加载到内存,内核启动时会在访问真正的根文件系统前先访问该内存中的 initrd 文件系统。在 boot loader 配置了 init...
在linux内核中,有很多同步机制。比较经典的有原子操作、spin_lock(忙等待的锁)、mutex(互斥锁)、semaphore(信号量)等。并且它们几乎都有对应的rw_XXX(读写锁),以便在能够区分读与写的情况下,让读操作相互不互斥(读写、写写依然互斥)。而seqlock和rcu应该可以不算在经典之列,它们是两种比较有意思的同步机制。atomic(原子操作):所谓原子...
信号量什么是信号量信号量的使用主要是用来保护共享资源,使得资源在一个时刻只有一个进程(线程)所拥有。信号量的值为正的时候,说明它空闲。所测试的线程可以锁定而使用它。若为0,说明它被占用,测试的线程要进入睡眠队列中,等待被唤醒。为了防止出现因多个程序同时访问一个共享资源而引发的一系列问题,我们需要一种方法,它可以通过生成并使用令牌来授权...
本节书摘来自异步社区《Linux内核修炼之道》一书中的第2章,第2.3节,作者:华清远见嵌入式培训中心 任桥伟著,更多章节内容可以访问云栖社区“异步社区”公众号查看2.3 自由软件的编译与安装Linux内核修炼之道在我们使用Linux的过程中,经常会遇到需要自己编译软件的情况,可以说自由软件的百家争鸣本身就是Linux世界不可分割的一部分。因此,本节...
本文介绍在昇腾平台使用MindSpore-Transformers进行大模型训练时,通过YAML配置实现参数解耦的实践方法。将模型、数据、训练、并行策略等参数集中管理于YAML文件,结合Config工具实现加载、合并与命令行覆盖,支持多实验对比、版本复现与工程化落地。重点涵盖配置结构设计、代码加载、继承机制、校验规范及常见问题排查,推荐采用分层配置、禁止硬编码、启动前校验等最佳实践,显著提升大模型
河南省某监狱安防项目的招标文件中明确要求,服务器操作系统需采用银河麒麟V10、统信UOS或鸿蒙等国产方案,数据库需选用达梦、人大金仓等国产产品,CPU需支持龙芯、飞腾、申威、鲲鹏、海光等国产平台。一台放在监室门口或民警值班室的终端,要扛得住24小时不间断运行,要能刷指纹、刷脸、刷卡,还要能联动门禁、对讲、报警。在操作系统层面,银河麒麟自助终端操作系统早在多年前就已用于广东省惠州监狱、女子监狱的回归
MindSpore-Transformers实现HuggingFace模型配置文件的原生加载,支持config.json、tokenizer及权重一键迁移至昇腾NPU,无需重写网络代码。通过AutoConfig、AutoTokenizer与AutoModelForCausalLM无缝对接,自动完成参数映射与类型转换,兼容FP16/BF16与safetensors格式,支持预训练、微调与自回归推理,
硬件架构
——硬件架构
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 openEuler 社区
 DAMO开发者矩阵

 人工智能6S服务平台


