登录社区云,与社区用户共同成长
邀请您加入社区
MindSpore大模型训练后导出MindIR实现“一次训练,多端部署”。MindIR封装计算图与权重,支持跨硬件推理,区别于仅存参数的ckpt。分布式场景需加载strategy_ckpt与分片ckpt,通过infer_predict_layout生成推理布局,再调用export生成mindir。可直接推理或经ATC编译为om模型部署昇腾NPU。注意:不可用MindIR恢复训练,需关闭dropou
MindSpore-Transformers(MindFormers)实现对Megatron-LM核心API语义对齐,支持张量、流水线、序列并行,兼容Megatron数据集与权重格式。通过四层架构设计,实现接口、参数、分布式逻辑高度一致,开发者仅需少量适配即可将大模型训练脚本迁移至昇腾NPU,复用图编译、算子融合、混合精度等加速能力,显著降低国产化迁移成本。配套提供数据集加载、权重双向转换、精度比
本文介绍昇思MindSpore生态通过MindSpore-Lite转换工具,实现Caffe模型向昇腾NPU的迁移。针对存量CV模型(如LeNet、VGG),支持将prototxt与caffemodel文件解析为MindSpore原生MINDIR格式,经优化后可编译为om模型部署推理。流程涵盖转换架构、代码实操、约束限制及问题排查,强调需验证输入对齐、算子兼容性与精度一致性,确保迁移可靠性。
caffe模型的后处理流程
一、搭建miniconda环境,参考前面文章二、配置CUDA(当前使用ssh终端连接)sudo vi ~/.bashrc添加:保存,退出三、修改开发板显存执行:修改nvzramconfig.sh文件修改文件中重起nano。sudoreboot free -h 四、配置torch环境 conda create -n yolov5 python=3.6 -yconda activate yolov5p
前言:原本这个项目是在jetson nano上进行的,但发现jetson nano的性能太低,因此更换了更高性能的板子。前几天小伙伴找我说,无法正常绘制字体,此时才注意到他们竟然没使用显卡硬件加速。因此接下来的几篇文档是编译硬件加速相关的库,可供大家参考本次编译的,是带CUDA加速的opencv4.5.4假设Qt已正常安装,笔者使用的版本是Qt5.15.2 gcc版一、安装需要的软件1.安装git
是不是在换gpu的pytorch后显示的错误?原因(个人理解):cup的pytorch和gpu的pytorch文件里面的caffe2_detectron_ops.dll文件名重复了,然后你更换为gpu版本的时候由于这个文件存在了,就没有下载,保留了原本cpu版本的。解决方法:把这个文件删除,然后重装gpu版本的pytorch转载自:https://github.com/pytorch/pytorc
一、前言最近在项目中发现了用到caffeine+redis的地方,感觉写的很好,因此记一波笔记。caffeine是spring的cache,保存在项目本地。redis是分布式缓存,保存在redis服务器。查询数据时,先到caffeine中查,如果没有则查redis,如果还没有再查数据库。二、主要流程代码样例1.查询数据库的Java类ExamServiceImpl.java@Servicepubli
DNN 深度神经网络这个是读模型的,像我现在用的模型是caffe训练出来的,所以用这个它也有别的框架的接口,比如我们现在看readNetFromCaffe()第一个参数是神经网络配置文件,第二个参数是训练好的模型1代码分析项目由两个py文件组成,一个是bolb_from_images.py这个是主函数,另一个是utils_paths.py这个py文件会在主函数中调用utils_paths只在bol
参考教程:https://github.com/Wulingtian/yolov5_onnx2caffeonnx模型转换caffe模型过程中报错,没有{}节点,就直接把converCaffe.py里的err.unsupported_op(node)注释掉了转化成功以后测试时候,打算修改caffe_yolov5s.cpp,但是修改完重新编译报各种错。和这个错一样:https://github.com
两天没日没夜终于在ubuntu系统上装上了openpose,我饱受折磨后决定把安装步骤记录下来,以及一些参考博客。安装环境:inter i7,rtx 2060,cuda10,cudnn7.4,opencv 3.2。第1步 安装依赖包安装后续步骤或环境必需的依赖包,依次输入以下命令:sudo apt-get install libprotobuf-dev libleveldb-dev libsnap
Makefile安装环境Ubuntu18cuda11.1cudnn8.0opencv3anaconda python3.6以下过程可能需要访问国外网站的能力,或配置镜像源安装Caffe-ssd创建虚拟环境conda create -n cafee python=3.6conda activate caffepip install numpy安装各项依赖sudo apt-get install li
caffe使用cmake编译完成后默认连接在系统python路径/usr/bin/python,conda环境中运行python导入caffe失败。解决方法:将${caffe_root}/build/install/python目录下的caffe文件夹复制到{conda_env}/lib/python{python_version}/site-packages目录下cp -r build/inst
conda config --add channels https://mirror.bjtu.edu.cn/anaconda/pkgs/free/conda config --add channels https://mirror.bjtu.edu.cn/anaconda/pkgs/main/conda config --add channels https://mirror.bjtu.edu.
前言本文记录ubuntu18.04下openpose的安装过程。参考官方文档配置如下:CPU:i3-10100内存:DDR4 16GChipset:Q470GPU:RTX 2060 super 8GB一、安装前设置安装ubuntu18.04.5操作系统,为了加快安装依赖时的速度,可以将apt源更换为阿里源。root@AI-S2000:/home/ubuntu# mv /etc/apt/source
Anconada下编译安装安装过程遇到很多坑,一下步骤同样适合opencv-4.3Anconada安装此处不在介绍,自行百度,相信大部分人已经安装了。#需要创建一个Python环境,并激活环境。conda create -n py36 python=3.6source activate py36opencv安装environment安装依赖等,此处安装的有点多,有备无患。su...
一、基于海思芯片:从算法到移植darknet框架下训练yolov3二、基于海思芯片:从算法到移植 darknet框架下yolov3转为caffe框架下三、基于海思芯片:从算法到移植 caffe-yolov3测试训练效果四、基于海思芯片:从算法到移植 生成海思wk文件并进行成果展示在本系列教程第一篇文章:一、基于海思芯片:从算法到移植 darknet框架下训练yo...
一、基于海思芯片:从算法到移植 darknet框架下训练yolov3二、基于海思芯片:从算法到移植 darknet框架下yolov3转为caffe框架下三、基于海思芯片:从算法到移植 caffe-yolov3测试训练效果四、基于海思芯片:从算法到移植 生成海思wk文件并进行成果展示OK,继续开始我们的讨论,根据上一篇章所述,我们获取了caffe下的两个重要文件anqu...
一、写在前面caffe前前后后配了几天总算是弄好了,各种东西间的依赖真的多,也可能是我太笨了|||,总之我的第一篇博客就用来记录caffe环境搭建吧。二、我用到的原料操作系统:windows10显卡:NVIDIA GeForce RTX 2060anacondapython3.5vs2015CUDA10.0cudnn7.4.1cmake3.15.4Gi...
anaconda的安装和基本使用配置caffe或者tensorflow都需要安装python和一些依赖库,anacanda可以帮我们省去安装依赖库的麻烦,但个人推荐在使用tensorflow时候使用anconda,如果只使用caffe则不建议使用anaconda,因为anaconda配置了环境变量后,代替系统默认的python后,导致了apt-get install lib 安装的一些pyth..
编译caffe时用到了opencv,其实caffe只用到OpenCV很小一部功能 ,具体就是opencv_core,opencv_imgproc,opencv_highgui三个库,用于图像读写,如果能将这个三个库全静态编译,就能让caffe在运行时不再依赖opencv。但量opencv_highgui库在读写jpeg,png,tiff,jpeg2000图像格式时用到了第三方编解码库,默认编译o
在利用开源深度学习框架caffe进行数据集进行训练与测试的过程中,难免会想要可视化自己训练过程中的一些训练数据,本篇主要介绍如何利用caffe中自带的工具来可视化cifar10训练与测试过程中的误差曲线和精度曲线。
最近在配置caffe,出了许多的问题,今天终于解决了,感谢各位大神的博客,在文中会一一点出来。一.安装ubuntu 14.04这里采用的是windows+ubuntu双系统。可能要注意的几个问题:1.先装windows再装linux,因为在windows下进行磁盘操作相对会熟悉一些。2.可能会用到的一些软件:UltraISO用于刻录U盘启动盘,EasyBCD用于启动时找得到windows
老规矩,先看整体架构图(此处假装有仿真模型截图)——直流电源怼进三相逆变桥,后边接着PMSM本体,中间穿插着各种变换和控制器,这结构一看就是老江湖的标配。(6)仿真模型涉及DC直流源、三相逆变桥、PMSM永磁同步电机、ADRC自抗扰控制器、PI比例积分控制器、Park变换、Park反变换、Clark变换、测量模块、显示模块等构成。(6)仿真模型涉及DC直流源、三相逆变桥、PMSM永磁同步电机、AD
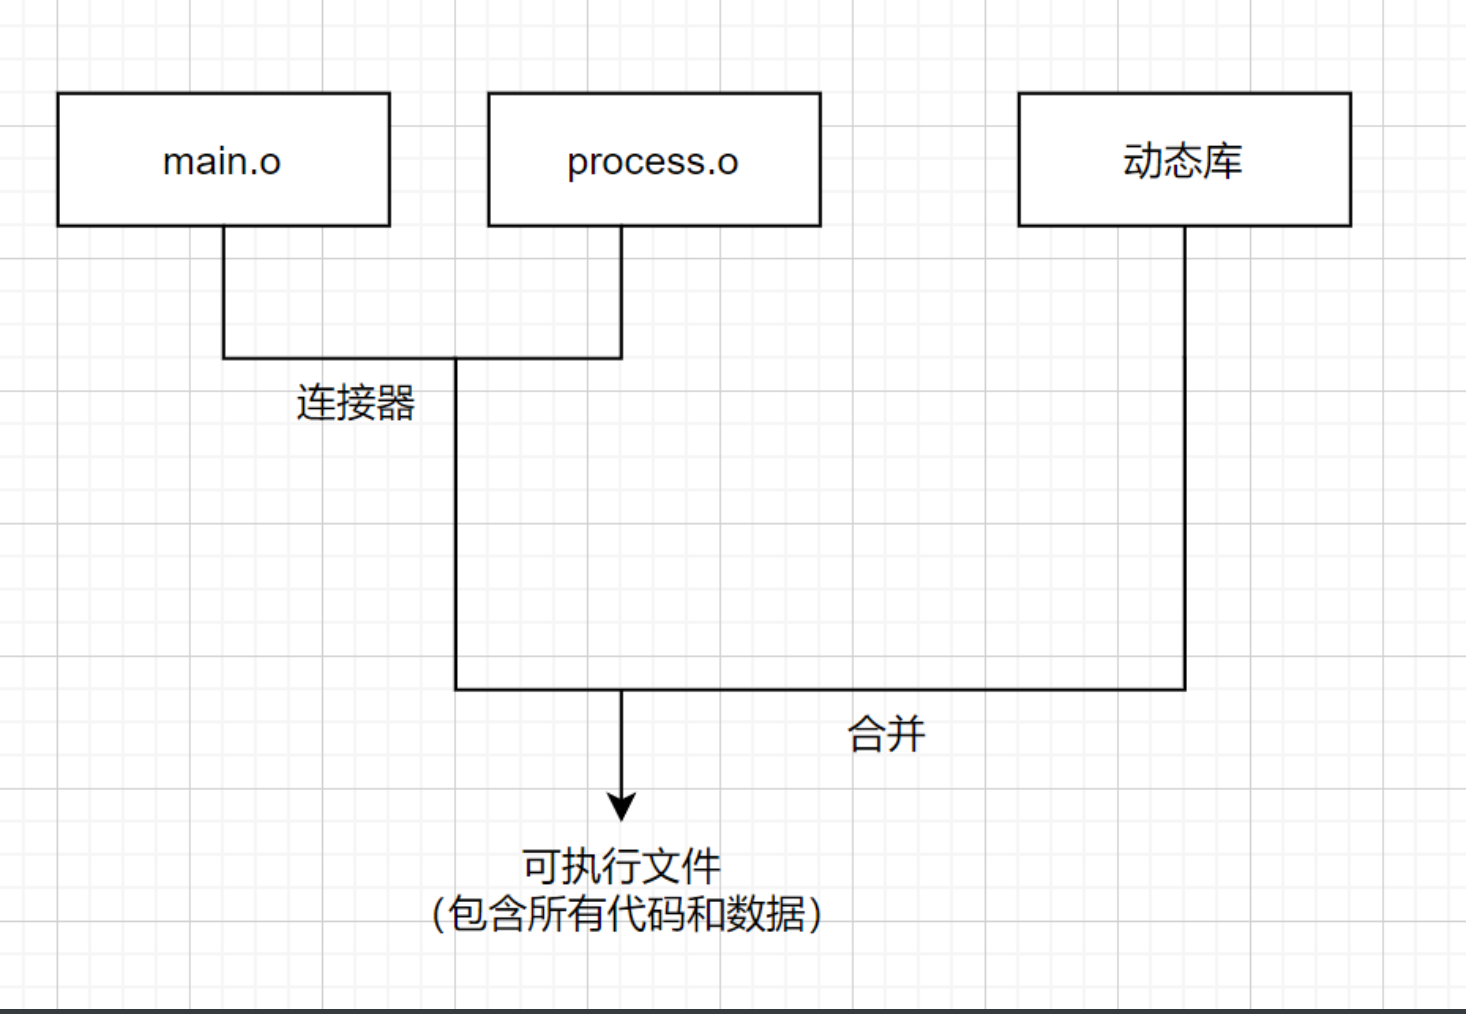
首先,程序从高级语言到可执行文件经历了预处理、编译、汇编和链接四个步骤,其中链接阶段涉及动态库和静态库的使用。接着,文章解释了操作系统如何通过fork创建子进程,并通过execve系统调用加载ELF文件,替换进程地址空间并执行程序。最后,程序从_start入口跳转到main函数执行。整个过程通过COW(写时复制)技术优化了内存使用,确保子进程的失败不会影响父进程。
最近整理抽屉发现还有一套闲置的jetson nano,是前年买来和女儿一起做机器人的。不得不说英伟达的显卡真是强大,99美金的小东西可以做很多想法。周末做了一套简单的人脸识别系统,主要是留了几个接口可以根据需要扩展功能。用到了QT, Opencv和数据库。采用深度学习的人脸识别方案,使用的是facenet。充分利用了jetson nano的长处显卡进行运算,这个显卡虽然不算强,但对人脸识别足够了。
以下内容由公众号:AIRX社区(国内领先的AI、AR、VR技术学习与交流平台) 整理TensorFlowTensorFlow是一个端到端的机器学习开源平台。由工具、库和社区资源组成的全面、灵活的生态系统,使开发人员能够轻松地构建和部署基于ML的应用程序。TensorFlow最初是由谷歌机器智能研究组织的谷歌大脑团队的研究人员和工程师开发的,用于进行机器学习和深度神经...
记录一下。软硬环境 : ubuntu 16.04, Nvidia GTX 1080Ti *2查看gpu(需要先安装驱动):nvidia-smi+-----------------------------------------------------------------------------+| NVIDIA-SMI 384.130Driver...
效果如下图:最新的源代码放在github上,https://github.com/huaze555/windows-caffe-faster-rcnn,支持训练和测试,自己下载用VS2013编译即可,编译步骤跟微软版的caffe一模一样。同时版本经过大幅度性能优化,在GeForce GTX TITAN X显卡上,对于VGG16模型的速度是16.6fps左右。*******...
开机B7问题之前闲置了一台计算主机,今天开机发现一直卡在SYSTEM initializing 右下角自检显示卡在B7,开不了机进入BIOS都不行。期初以为是BIOS的问题,于是大费周章地拆开机箱,把显卡旁边的一个纽扣电池扣下来再装上去让bios初始化,结果还是一样。咨询了专业人士,说是内存条的问题,于是把内存条卸下来,用橡皮擦一擦吹一吹,然后换个卡槽上去,问题解决。双十一买了一块内存条给自己电脑
opencv目前已经支持caffe训练模型的读取,以及使用模型进行预测,这个功能是dnn模块实现的,而这个模块位于opencv_contrib中,此前编译的opencv3.2.0并没有将opencv_contrib中的模块加进来。因此,这里重新将opencv_contrib加入到opencv3.2.0进行编译。
-----------------2016/10/27更新-----------------------------参考链接,感谢原作者!http://blog.csdn.net/enjoyyl/article/details/47397505http://blog.sina.com.cn/s/blog_51fad6900102wlmx.html笔者在双系统ubuntu...
1、电脑配置本人电脑的配置,Windows10 64位+MATLAB 2013b +CUDA6.5 +VS 2013这里给大家说个小BUG,MATLAB2013a是不支持gpuarray的,如果你是2013a的话,会一直报这句错误的。所以,不用怀疑,直接更换版本。VS是用来给喜欢自己编译的同学的,不过代码中已经给出了编译好的caffe的代码,可以直接下载使用。CUDA是用来加速计算的
preloadInvalid MEX-file‘*/caffe/matlab/+caffe/private/caffe_.mexa64’:/usr/local/MATLAB/R2012a/bin/glnxa64/libstdc++.so.6:version `GLIBCXX_3.4.15’ not found (required by*/caffe/matlab/+caffe/pri
文章目录一.检查模型二.校准三.build runtime模型四.runtime运行(仿真)五.结语六.参考目前tensorflow,pytorch首先需要将自己的模型转为onnx模型,再使用工具链条转换模型; caffe可直接使用工具链转换,目前Onnx支持的版本为opset10。本文选择yolov2案例,官方已在工具链中提供yolov2的caffe模型,可直接运行测试。一.检查模型进入示例脚本
在十一月初,腾讯就官宣了一则消息,腾讯WeTest明星工具-PerfDog面向全球发布。官宣介绍如下:https://wetest.qq.com/lab/view/475.html。我在看到该新闻时,有种大开眼界的感觉,移动端的性能测试原来可以这么简单。今天闲暇之余,来了一波初探,简单体验了一番。我们先来了解下通过该工具能采集到哪些性能数据:PerfDog支持移动平台所有应用程序(游戏、APP应用
感谢这位博主我参考的是Joeya_ICT这位博主的《(树莓派、linux通用)OpenCV3源码方式安装教程(最新3.4.3)》https://blog.csdn.net/leaves_joe/article/details/67656340还有这位博主https://blog.csdn.net/qiuzitao/article/details/96478070前提:最好是已经换源了换源可以看我之
1. NNIE介绍NNIE 是 Neural Network Inference Engine 的简称,是海思媒体 SoC 中专门针对神经网络特别是深度学习卷积神经网络进行加速处理的硬件单元,支持现有大部分的公开网络,如 Alexnet、VGG16、Googlenet、Resnet18、Resnet50 等分类网络,Faster R- CNN、YOLO、SSD、RFCN 等检测网络,以及 Se..
PerfDog是一款移动平台的性能测试工具,快速定位分析性能问题,提升APP应用及游戏性能和品质。手机无需ROOT/越狱,手机硬件、游戏及应用APP也无需做任何修改,极简化即插即用,是全网唯一支持iOS/Android/小程序/H5等移动全平台性能测试的工具。PerfDog自发布以来就广受移动端测试人员的好评,PerfDogService是PerfDog的服务组件,用户可基于service组件二次
致移动游戏&应用性能测试分析的伙伴们:你是否会因移动游戏&APP性能问题,而备受煎熬?你又是否因寻找性能测试分析工具,而彷徨迷茫?你是否因工具需要,而尝试各种ROOT/越狱?你是否因工具准确性,而被逼各类花式复测验证?你是否因工具局限性,而同时开启N个工具?你又是否因工具空白,而被迫各式XCode源码编译?ROOT/越狱越来越难,你我路在何方?版本编译坑罗密布,你我又将守夜到何时?
尝试失败的https://github.com/soloIife/yolov5_for_rknnrknn toolkit examples里面自带的均可转为rknn,yolov5s无法转换尝试成功的import yamlfrom rknn.api import RKNNimport cv2_model_load_dict = {'caffe': 'load_caffe','tensorflow':
最近重新编译caffe SSD(https://github.com/weiliu89/caffe/tree/ssd),遇到下面错误,:~/work/caffeX/caffe_weiliu89$ make all -j12CXX/LD -o .build_release/tools/convert_annoset.binCXX/LD -o .build_release/tools/create_l
caffe 编译中出现的错误——fatal error: hdf5.h: 没有那个文件或目录 && /usr/bin/ld: cannot find -lhdf5“fatal error: hdf5.h: 没有那个文件或目录”解决方法参考自http://blog.csdn.net/hongye000000/article/details/51043913Step 1在Mak...
caffe编译成功后,在导入测试的时候,出现以下错误.在命令行输入:import caffe回车。出现以下错误.Traceback (most recent call last):File "<stdin>", line 1, in <module>File "/home/li.guangyao/Programm
在编译用于训练openpose的caffe时,make之后产生如下错误:LD -o .build_release/lib/libcaffe.so.1.0.0-rc3/usr/bin/ld: cannot find -lopenblascollect2: error: ld returned 1 exit statusMakefile:570: recipe for target '.bu...
caffe
——caffe
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 人工智能6S服务平台

 乐奇 Rokid 开放社区




 海思HiSpark开发者社区


