登录社区云,与社区用户共同成长
邀请您加入社区
这个方法可以让你在构建自己的Docker镜像时,直接指定Python版本。只需要创建一个包含指定python版本信息的Dockerfile文件,并通过构建和运行docker命令即可实现。)下找到名字叫做"Dockerfile" 的文件进行构建,并且给新生成出来得到 Docker 镜像打上 "my-python-app" 的标签。然后,在同一目录下创建一个requirements.txt文件,并列出
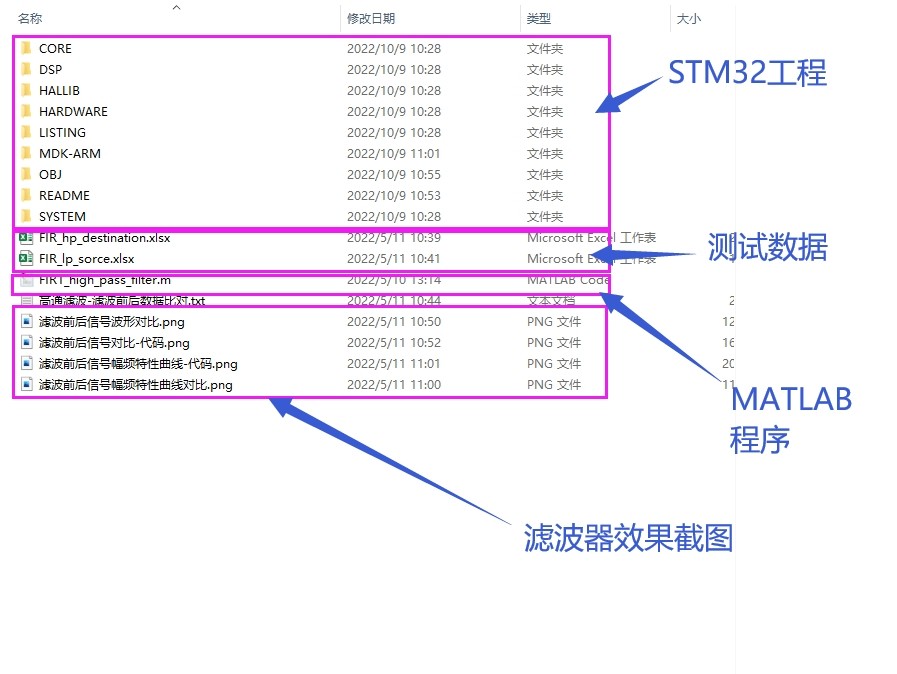
记住滤波器阶数不是越高越好,够用就行,STM32F4跑100阶滤波器照样轻松。这个环形缓冲区的骚操作在于,每次新数据覆盖最老的数据,省去了数组整体移动的开销。这里倒着取缓冲区数据的操作是关键,因为新数据总在buf_index位置,老数据顺时针排列。用DSP库的批处理模式,一次处理一个数据块,比单点处理快3倍不止。STM32实现FIR有限冲击响应高通滤波器,自编代码,汉明窗,送MATLAB程序,代码
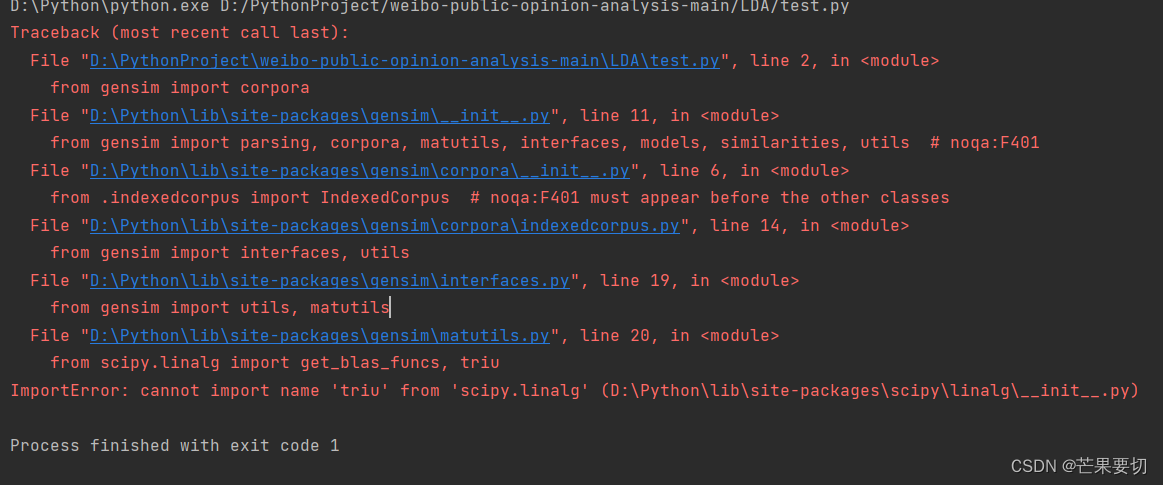
我安装的gensim包是4.3.2,安装的scipy改为1.7.2之后解决了问题,而1.10.1和1.5.4都是不行的。上网搜索一下发现可能是版本不匹配,即gensim对于scipy的版本有要求,这边建议上官网查看相关文档。
1.从“http://www.lfd.uci.edu/~gohlke/pythonlibs/”上下载“numpy”和“scipy”的安装“.whl”文件。2.用下面命令分别进行“numpy”和“scipy”的安装“。pip install numpy-xxx.whlpip install scipy-xxx.whl
图中,蓝色框里就是芯片型号,如果不是你想要的芯片型号 ,需要更改。这是由于仿真器选择的芯片型号错误,选择正确的芯片型号就可以了,亲测有效。重新点击KEIL中的魔术棒,查看是否检测出来驱动信息,本人问题已经解决。第三步,在指令中输入connect,再按回车键,出现下图所示内容。第八步,出现第七步内容 ,再点击回车键,出现下图所示内容。第七步,出现上图所示内容,直接点击回车键,如下图所示。第二步,打开
from scipy.misc import imread报错:ImportError: cannot import name imread在网上找了解决方法,大致如下:1.安装Pillow(imread依赖于pillow)2.检查Pillow和scipy是不是安装在同一路径3.其他但是,这些并不能解决我的问题,最后在某处评论看到如下方法:将scipy降级到1.2.1版本(pip i...
讲解用于物品推荐系统的协同过滤算法:余弦相似度、皮尔逊相关系数、矩阵分解(SVD),并比较其优缺点。
已解决ImportError: cannot import name ‘triu’ from ‘scipy.linalg’尝试将scipy更换为1.15.3后错误依旧,然后换到1.10.1版本就可以额。scipy版本为1.15.2应该是版本不匹配。
BUG解决:ImportError: cannot import name 'scalar_search_wolfe2' from 'scipy.optimize.linesearch'
安装 pip install scipy==1.11.4。卸载 pip uninstall scipy。应该是只要降到1.12.0以下就可以了。
对于-user-data-dir标记,指定创建新Chrome配置文件的目录。它是为了确保在单独的配置文件中启动chrome,不会污染你的默认配置文件。python:browser.find_element_by_xpath("//*[contains(text(),'花呗')]").click()我们需要手动打开浏览器,进入到所需的页面,执行一些手动任务,如输入表单、输入验证码,登陆成功后,然后再
在subline text3导入时报如下错误 ModuleNotFoundError: No module named 'matplotlib'直接进入python环境,输入python -m pip install numpy就不会报错。1,numpy(基础数值算法)安装,要是在cmd直接安装到最后会报错,5,sklearn( 深度学习) 安装(scipy)也从这里安装进来了。3, matplo
在使用Elasticsearch进行数据分页时,你可能会遇到一个常见的错误,那就是"max_result_window is too large"。如果你需要深度分页(即获取很多页面),推荐使用'search_after'参数而非'from'/'size'方式进行分页操作。在每次请求后,你需要将上一次查询结果的sort值传给下一次查询的'search_after'参数。首先要明白一点:尽管我们可以
发现是调用plot的时候选择绘图模式kind='density'的时候出了错,看到错误类型是缺scipy这个库,但是之前已经下载了。最后发现得先关掉jupyter再卸载掉scipy重新安装一遍就解决了。
scipy库是Python中用于科学计算的开源库之一,主要包含许多数学、科学和工程计算中常用的函数和工具。以下是scipy库的一些主要特点和常见用法。数据结构scipy库中常见的数据结构包括数组(numpy.ndarray)、稀疏矩阵(scipy.sparse)、图像(scipy.misc)、最优化问题(scipy.optimize)等。这些数据结构可以方便地进行处理和操作,适用于不同的科...
树莓派(linux)安装scipy
点击上方前端Q,关注公众号回复加群,加入前端Q技术交流群本文为读者投稿的系列文章(三),内容超肝,慎入!历时8个月,10w字!前端知识体系+大厂面试总结(基础知识篇)作者主页:https://juejin.cn/user/2594503172831208正文工程化目的是为了提升团队的开发效率、提高项目的质量例如大家所熟悉的构建工具、性能分析与优化、组件库等知识,都属于工程化的内容这篇文章的内容,.
numpy,scipy,pandas这3个库的区别是什么?打个比方,pandas类似Excel软件,scipy就像Excel里的函数算法包,numpy则好比构建Excel逻辑的底层语句。所以说pandas擅长数据处理,scipy精通数学计算,numpy是构建pandas、scipy的基础库。我们知道numpy通过N维数组来实现快速的数据计算和处理,它也是Python众多数据科学库的依赖,其中就包括
在本次练习中,我们将分析BRFSS的重量与身高数据。从课程网站下载数据和代码骨架。代码骨架包含加载数据并生成数字数组件的代码。数字阵列中的五个列表示:年龄、current_weight(公斤)、weight_a_year_ago(公斤)、身高(厘米)和性别,其中性别 =1 代表男性,2 代表女性。1. 使用HW1 的代码生成关于current_weight、weight_a_year_ago和高度
常用参数解析points: 包含x,y坐标的点,用于生成Delaunay三角网。格式:[[x1, y1], [x2, y2], [x3, y3], …]incremental: 是否允许继续加点,默认False常用属性解析points:即你输入的那些点simplices:Delaunay函数生成的那些三角形,每个三角形用其三个顶点的顶点号表示,每个三角形的顶点号按照逆时针排列neighbors:每
环境:win8+64位,python3.5可以在cmd下输入python -V查看自己的python版本。使用pip来install一种是直接在cmd任意目录下输入:pip install 库名另一种是先在下面这网址下载一些库的*.whl文件,记着文件下载的路径,然后输:pip install 路径。注意:别下载错了版本。怎么选呢:我python3.5的就选了cp3,64位系统就选了ad
最后,将开发完成的代码打包成可执行文件或Docker镜像,部署到目标设备(如工控机或树莓派)上,并设置开机自启动,即可完成整个门禁系统的搭建。当识别出授权用户后,系统需要触发实际的开门动作。另一种更先进的选择是使用基于深度学习的人脸检测模型,例如SSD(Single Shot MultiBox Detector)结合OpenCV的DNN模块,这通常能获得更高的准确率,但需要更多的计算资源。最后,将
scipy的使用
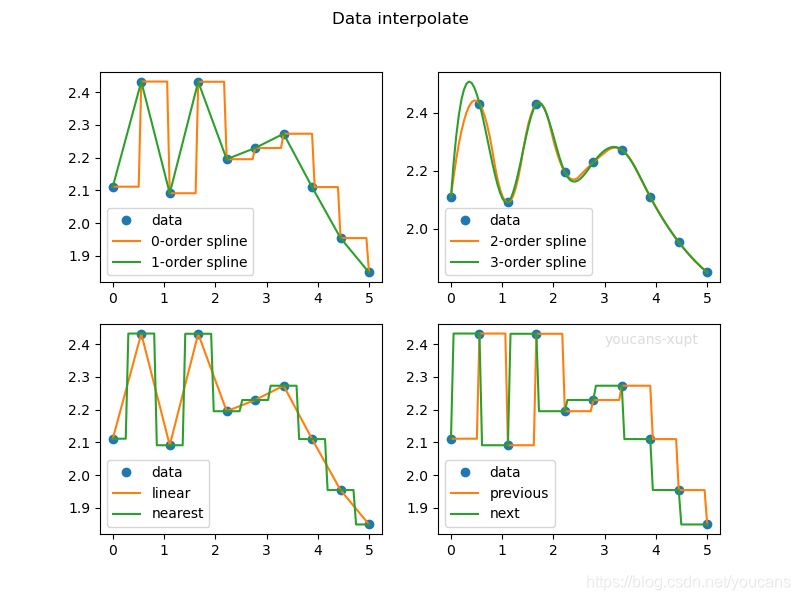
插值、拟合、回归和预测,都是数学建模中经常提到的概念,也经常被混淆。插值是在离散数据的基础上补插连续函数,使得插值函数通过全部给定的离散数据点,多用于图像处理和缺失数据处理。本文使用 Scipy 工具包的 interpolate 插值模块,通过例程讲解一维插值、二维插值的实现方法。
文章目录美国人口预测模型栗题:建模与求解参数估计scipy.optimize curve_fit函数这里我们用经典的人口预测模型来进行函数的使用说明美国人口预测模型栗题:利用下表给出的近两个世纪的美国人口统计数据(以百万为单位),建立人口预测模型,最后用它估计2010年美国的人口.年份17901800181018201830184018501860人口3.95.37.29.612.917.123.
文章目录1基本配置1.1基本模块1.2绘图设置2基本统计量3基本分布3.1离散型分布3.2离散型分布示例3.2.1伯努利分布3.2.2二项分布3.2.3泊松分布3.3连续型分布3.4连续型分布示例3.4.1正态分布3.4.2均匀分布3.4.3指数分布3.4.4t分布3.4.5卡方分布3.4.6F分布3.4.7对数正态分布3.4.8韦伯分布1基本配置1.1基本模块import numpy as np
戳我 ->卧槽!当当网图书全场4折了!作者:AI悦创来源:AI悦创我来分享一下数据分析中 Numpy 库的使用,本文内容较多,不可能每段代码的输出过程、输出结果分析这显然工作量不...
Scipy科学计算法、数据处理
pycharm 安装 scipy
求助pycharm警告::228: RuntimeWarning: scipy._lib.messagestream.MessageStream size changed, may indicate binary incompatibility. Expected 56 from C header, got 64 from PyObject
差分进化算法是广义的遗传算法的一种,核心思想是变异,本文将要介绍的则是著名的scipy库中对差分进化算法的实现。
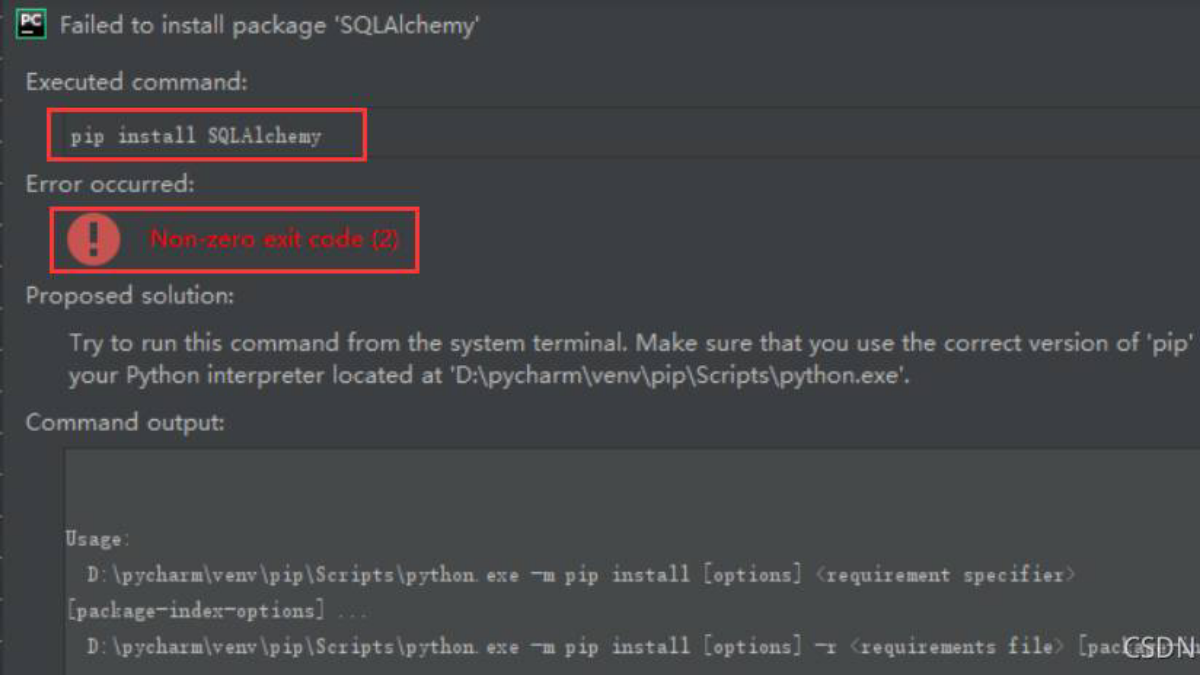
傍晚的时候安装numpy和scipy,结果pip没更新,numpy就很顺利地安装了,然后安装scipy一直报错。我先是更新pip,终端显示更新成功了,但pycharm自带的install搜索下载报错,这不重要,然后我重启pycharm,用pip下载没用,在cmd用pip下载和在pycharm下载没有区别,我也没用网上的方法,还要下载文件啥的,感觉好麻烦,最后我想,国内下载是不是不行,然后用镜像网站
新手安装argoverse时碰到问题
windows下安装scipy方法
备份过程与之相同,事实上,为了节省空间,iMazing 使用与 iTunes 相同的备份位置,但是,在 iTunes 维护设备的单个快照的位置,iMazing 会生成多个类似快照的 '时间机器',让您能够更加细致地进行浏览和恢复,另外,iMazing 与 iTunes 的不同之处还在于它支持您对备份进行处理:查看其内容、在恢复之前为其添加或删除应用等。值得肯定的是iMazing软件特色:浏览、 保
值得肯定的是EasyRecovery软件特色:电子邮件恢复允许使用者查看选定的电子邮件数据库,将现有的和已删除的电子邮件都显示出来,能够用于打印或保存到硬盘。我们都知道打开软件,在首页界面我们能够看到点到的多个储存分区,根据自己的数据丢失情况,找出数据的原始位置,选择之后,点击右下角的“扫描”。习惯上来说等待扫描完成,我们能够在众多文件中选择需要恢复的文件,文件能够打开进行预览,勾选完成,最后点
基本上来说完全读写访问NTFS,Mac OS X对NTFS(Win 个人电脑的主文件系统)提供有限支持,通过* Paragon的Mac OS X专用NTFS,您能够在Mac OS X中完全读写访问NFTS 苹果电脑硬盘读写软件叫什么:苹果电脑硬盘读写软件是使苹果电脑获得对ntfs格式硬盘的工具,这种软件有很多,常见的有的(1)Paragon NTFS for Mac 15;NTFS For Mac
Ubuntu 22.04环境中,当使用clang++进行编译的时候,可能会遇到/usr/bin/ld找不到-lstdc++文件或目录的问题。在这种情况下,问题的根本原因是缺少了对应的C++标准库。在不同的系统中,可能会使用不同的C++库,所以在解决问题之前需要确保使用了正确的库。请将/path/to/libstdc++/directory替换为实际的路径,通常在/usr/lib/x86_64-li
如题,如何在windows上快速安装上面三个库,用于学习或工作呢?---不要浪费时间,直接上https://www.scipy.org/install.html,上面已经讲了,以下开发环境自带上述库:AnacondaEnthought CanopyPython(x,y)WinPythonPyzo推荐用Anaconda,有422MB左右,下载和安装用的时间
1P算力代表了当前计算能力的巅峰水平,它不仅是硬件的堆叠,更是技术复杂度的质变。不要只停留在“会用”:掌握Linux、网络基础是门槛,但必须向**云原生(K8s/Docker)和编程自动化(Python/Go)**进阶。关注“国产化”与“AI”:了解国产芯片(如昇腾、鲲鹏)的适配,或者深入学习AI训练框架和GPU管理,是未来5年最具竞争力的“护城河”。利用地域优势:关注新疆本地的智算中心建设和能源
自动化程序模拟浏览器行为通过HTTP协议获取网页数据解析提取有价值信息的工具。
[目录]
随着网络空间舆论的日益活跃,其对社会事件的影响愈发显著。企业和组织需要及时掌握网络上的正面或负面信息,以便做出快速反应,维护形象或改进产品。政府部门也需关注网络舆情,以更好地理解民意,指导政策制定和社会管理。基于爬虫与文本挖掘技术的舆情监控系统能够自动地从广泛的网络资源中收集数据,并通过文本分析揭示关键趋势和洞察,为决策者提供科学依据。系统的应用有助于预警潜在的危机,防患于未然,同时为市场营销、公
在进行假设检验时,需要根据具体问题选择合适的检验方法,并根据 p 值来判断是否拒绝原假设。通常情况下,如果 p 值小于预先设定的显著性水平(如 0.05),则拒绝原假设,认为存在显著差异;模块可以进行各种统计分析和概率计算,具体的使用方法会根据你的具体需求而有所不同。在使用时,可以参考官方文档以获取更详细的信息和更多的功能。独立样本 t 检验用于比较两个独立样本的均值是否有显著差异。配对样本 t
在网上我查了好多怎么用pip下载numpy和scipy,遇到好多头大的问题,也无从下手解决,多次尝试也失败过好多次,希望这篇可以帮助大家,别走我之前的老路。2.先把pip升级,利用快捷键Windows+r弹出的页面,再输入cmd,进入命令提示符里,输入。1.首先大家先把vpn关掉。
scipy下载地址:https://www.lfd.uci.edu/~gohlke/pythonlibs/成功安装后,导入scipy检验是否成功。
python模块SciPy和pymol的whl文件下载地址汇总
scipy
——scipy
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net

 乐奇 Rokid 开放社区




 天工造物局










 DAMO开发者矩阵