- @qq_29462849


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
最近一段时间的信息量不是很足,很多同学来问我们物理AI领域的现状是怎么样的?好久没有做过盘点类的内容了,因为各类公司从之前的百家增加到数百家,很难完整的罗列下来。还有一个因素是,前两个月waic、wrc和外滩大会一直在忙碌,没有抽出时间。这次,我们准备盘点下物理AI领域的公司图谱,核心是为了呈现当下国内比较完整的分布情况。既有本体公司,也有大脑、运控、数据、核心零部件相关的。由于我们内部调研的文档

上层大脑会不断变强,也会不断被替换,而“小脑”可以与下一代大脑继续协作。这一愿景以GPT、Claude等通用模型作为上层智能的参照,指向任务理解与底层执行之间的分工。FACT 这篇工作中具体验证的,是人类力监督与接触预测如何帮助机器人执行;与不同上层模型协作,是作者进一步希望推动的方向。这也是我们理解“首个机器人小脑”这一定位的方式:它强调一种从规模化人类经验中学习、同时预测和响应接触的执行能力。

介绍我的第一篇关于mask rcnn训练自己数据的博文,基于python代码,虽然可以跑,但是不能真正用到工程领域中,工程领域更多的是基于C++和C,如果编译tensorflow C++ API也是可以,然后利用api调用模型,但是会比较麻烦,自己也尝试过,不是那么友好。opencv4.0,终于等到你~~~,opencv4.0已经支持mask rcnn的调用,只需要.pb文件和.pbtxt文件..
介绍opencv除了支持常用的物体检测模型和分类模型之外,还支持openpose模型,同样是线下训练和线上调用。这里不做特别多的介绍,先把源代码和数据放出来~实验数据模型文件:pose_iter_440000.caffemodel.protxt文件:https://github.com/opencv/opencv_extra,下载后,找到dnn文件夹,在内部有很多.protxt文件,都是o...
一、前言基于上一篇的SSD对工件裂纹检测之后,又推出的准确率更高的模型yolov3。SSD虽然速度快,但是准确率实在不高,对非裂纹的区域容易错检。后面提出的RetinaNet和yolov3无论是在速度上还是准确率上都非常棒,准确率已经超过了Faster RCNN。在这里就以yolov3为准,进行裂纹的检测定位。二、yolov3算法yolov3是在yolov2和yolov1的基础上进行改进的,...
最近,RoboTwin 2.0 Leaderboard 更新了,有一组结果值得关注。这次浮到榜前的是一个名叫欧拉万象OLA Dimensions的团队。同时,OLA-Sem 在更强调环境变化与泛化能力的 clean2random 设置下取得 67.6%,排第二。但如果往模型设计里面多看一步,更有意思的问题其实是:同一个团队,为什么要同时做 OLA-Sem 和 OLA-Geo 两条路线?一个偏语义,
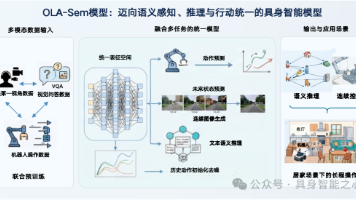
最近,RoboTwin 2.0 Leaderboard 更新了,有一组结果值得关注。这次浮到榜前的是一个名叫欧拉万象OLA Dimensions的团队。同时,OLA-Sem 在更强调环境变化与泛化能力的 clean2random 设置下取得 67.6%,排第二。但如果往模型设计里面多看一步,更有意思的问题其实是:同一个团队,为什么要同时做 OLA-Sem 和 OLA-Geo 两条路线?一个偏语义,
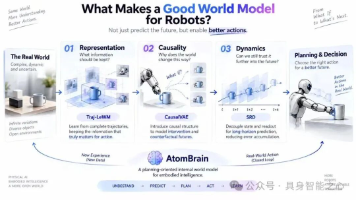
就在近期,原力无限联合香港大学、清华大学、中国科学院自动化研究所、上海交通大学等科研团队,连续推进Traj-LeWM、CausalVAE、State–Readout Decoupling(SRD)三项研究,分别提升隐式世界模型的Encoder(动态表征提取)、表征结构(因果注入)与Predictor(长程预测)。比如拿起桌上的杯子:杯子表面的纹理下一秒如何变化并不重要;让机器人预测未来,最直观的方
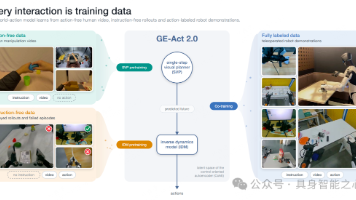
使用 300 小时数据进行联合训练时,相比直接端到端联合训练基线,KASO 让机器人选对指令目标的比例提高了 7.5 个百分点,完成抓取的成功率提高了 10 个百分点。**G1-OP 贡献了超过 50% 的训练数据,G2-90D 的占比不足 2%,后者的总体成功率仍随共享数据扩大提升了 17.7 个百分点。GE-Act 2.0 给出的结果是,能做成的任务变多了,整体成功率提高了,数据占比少的本体也
LingBot-Map走出了一条很有意思的路径。先在海外KOL中引发关注。随后,开源代码进入开发者社区,GitHub获得超过1.69万Stars。如今,论文又入选ECCV 2026 Oral。先被看见,再被用起来,最后走上顶会。但这些之外,更值得关注的是背后还有一条正在形成的空间感知链路,以及空间感知必须为行动负责的研发逻辑。只有当视觉信息被转换为可度量、可持续更新、可被规划和控制模块调⽤的世界表