


- @weixin_43597208


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本节课程思维导图:MapReduce 是 Google 大数据处理的三驾马车之一,另外两个是 GFS(hdfs) 和 Bigtable(hbase)。它在倒排索引、PageRank 计算、网页分析等搜索引擎相关的技术中都有大量的应用。MapReduce 的本质就是我们今天要学的这种算法思想,分治算法。
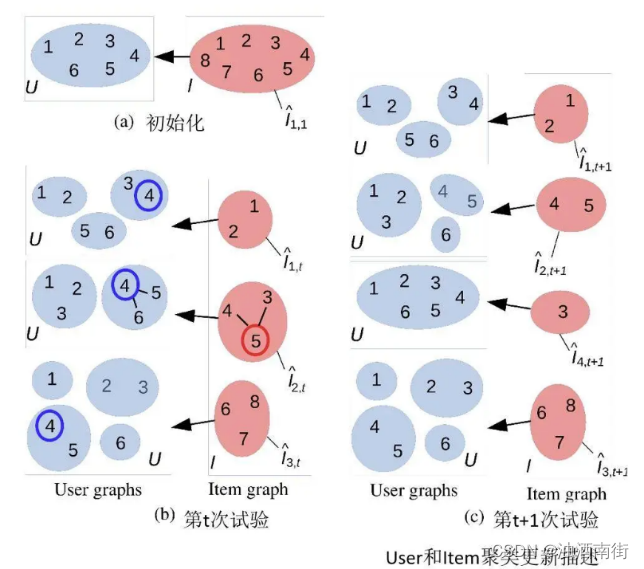
基于模型的协同过滤推荐,就是基于样本的用户偏好信息,训练一个推荐模型
在 Apache Hive 中,map_concat() 函数用于将两个 Map 类型的列合并成一个新的 Map 类型的列。其中,map1 和 map2 是两个 Map 类型的列,K 是键的数据类型,V 是值的数据类型。该函数会将两个 Map 类型的列合并为一个新的 Map 类型的列,如果有重复的键,则保留 map1 中的值。

pd.concat 是 Pandas 库中用于连接(concatenate)多个 Pandas 对象(例如 Series 和 DataFrame)的函数。它可以沿着指定的轴(行或列)将多个对象连接在一起。pd.merge() 是 Pandas 中用于合并数据的函数,类似于 SQL 中的 JOIN 操作。它允许您根据一个或多个键(key)将两个 DataFrame 连接在一起,从而进行数据整合和分析

在 Apache Hive 中,datediff 函数用于计算两个日期之间的天数差异。它接受两个日期作为参数,并返回这两个日期之间的天数差。其中 enddate 是结束日期,startdate 是起始日期。函数将返回 enddate 减去 startdate 后的天数差。这将返回 9,表示这两个日期之间相隔 9 天。总之,datediff 函数在 Hive 中是用于计算日期之间天数差异的非常有用的
信息流是推荐系统在商业上最成功的应用;完全依赖数据驱动的信息流会面临黑天鹅事件,所以人和算法协同进化的信息流会是最有生命力的;数量上,注意力已被大厂囤在自己了手中,那么下一步要关注的是注意力的质量,这是信息流平台方的商品,毕竟广告主购买了注意力后,发现是地摊货,生意也不会长久的。
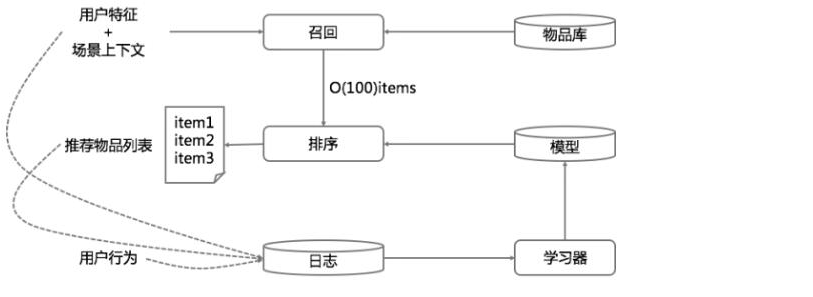
今天我以Netflix架构为原型,向你介绍了一个经典的推荐系统架构长什么样子。关于这个架构你只需要记住一点:它有三层,三层分别是离线,近线 ,在线。

今天我和你分享了一种上下文有关的Bandit算法,叫做LinUCB,它有这么几个优点:1.由于加入特征,所以收敛比UCB更快,也比UCB更快见效;2.各个候选臂之间参数是独立的,可以互相不影响地更新参数;3.由于参与计算的是特征,所以可以处理动态的推荐候选池,编辑可以增删文章;当然,LinUCB以及所有的Bandit算法都有个缺点:同时处理的候选臂数量不能太多,不超过几百个最佳。因为每一次要计算每
将传统的宽模型和新的深模型结合,虽然更多的是一种工程上的创新,但是非常有实用性,模型也容易理解。简单总结一下全文重点:1.深度模型是一个结合了传统线性模型和深度模型的工程创新。2.这个模型适合高维稀疏特征的推荐场景,稀疏特征的可解释性加上深度模型的泛化性能,双剑合璧。3.这个模型已经开源在TensorFlow中,大大减少了落地成本,感兴趣可自行取用。4.为了提高模型的训练效率,每一次并不从头开始训
用户画像对应的英文是User Profile ,它原本用于营销领域。营销人员需要对营销的客户有更精准的认识,从而能够更有针对性地对客户和市场制定营销方案。传统营销领域,是以市场销售人员为第一人称视角去看待客户的,也就是用户画像为营销人员服务。在这种用途下谈论的用户画像,和我们即将在推荐系统领域谈论的相差有点大,不过遗憾,今天在媒体上看到的多数“用户画像”案例分享,都停留在这个意思上。比如最常见的用