登录社区云,与社区用户共同成长
邀请您加入社区
本文以 GaussRoom 项目为例,拆解 HarmonyOS 7 空间重建工程链路:通过任务 ID 与状态机(ReconTaskStore)实现任务可追踪、可恢复;将进度与关键帧数结合,使 68% 进度具备业务含义;引入 TiledGSNode 实现视口驱动的分块渲染,结合相机绑定与瓦片请求监控,构建可诊断的大场景重建流程。核心价值在于:将原本“感觉卡顿”的问题转化为可复现、可分析的结构化数据链
HarmonyOS 的 ArkTS 并发能力提供 TaskPool、Worker 等选择,但究竟使用哪一种,应根据数据是否可传递、任务时长与生命周期决定。精准碰一碰解决的是空间上的准确触发,业务系统仍然要解决时间上的重复、乱序与重放。第二,示例中的签名函数只是文章里的边界占位,实际项目要使用平台安全能力和正式密钥方案,不能用字符串长度当验签逻辑。近场交互缩短的是入口,不应缩短安全判断。它把系统入口
本文介绍在ArkTS与Rust跨语言集成中构建稳定、安全的图像去重工具HashVault的实践。通过三层架构(ArkTS适配器、C++胶水层、Rust算法层),实现接口契约明确、错误处理结构化、内存安全可控。关键设计包括:前置校验防止无效调用,C++层仅做参数翻译与边界检查,Rust侧使用catch_unwind捕获panic并返回统一错误码。最终达成高可靠性与可维护性,确保跨平台、跨语言调用的稳
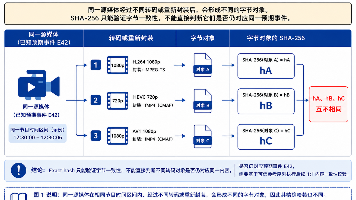
转码、缩放和重新封装会改变媒体对象的 SHA-256,但解码后的音视频仍可能对应同一直播事件。本文从 1:1 校验、音视频指纹、时间对齐、参考位置轨迹、可信参考、阈值校准和交付观测范围出发,设计面向 Multi-CDN 的生产级内容一致性子系统,并明确 MISMATCH、诊断、归因与受限响应之间的边界。
本文探讨了高效查找字符串中第一个不重复字符的两种解法:数组映射法和HashMap计数法。两种方法都采用"空间换时间"策略,先统计字符频率再查找第一个唯一字符。数组法利用ASCII码作为索引,访问速度快但仅适用于有限字符集;HashMap法通用性强,可处理任意字符但效率稍低。文章对比了两者的时间复杂度、空间复杂度和适用场景,指出数组法在小写字母场景下性能最优,而HashMap更适
本文深入解析了LeetCode 560题"和为K的子数组"的解题思路。通过前缀和技巧,将子数组求和问题转化为前缀和差值的统计问题。核心思想是:对于每个右端点r,统计其左侧满足pre[l-1]=pre[r]-k的位置数量,这些位置即构成和为k的子数组。文章详细解释了为什么需要初始化hash.put(0,1),以及为何要先更新答案再更新哈希表这两个关键细节。最终给出时间复杂度O(n
本文讨论了在非空整数数组中找出唯一出现一次数字的两种解法。异或解法(XOR)通过位运算特性,利用a^a=0和a^0=a的性质,将所有数字异或后得到唯一数,满足O(n)时间和O(1)空间的严格条件,是最优解。HashMap解法通过统计数字出现次数也能得到结果,但需要O(n)额外空间,不满足题目要求。两种方法对比显示:异或解法更高效简洁,专为"成对抵消"场景设计;HashMap解法
本文介绍了使用HashMap实现随机链表深拷贝的标准解法。关键在于建立原节点到新节点的映射关系,通过两趟遍历:第一趟创建所有新节点并存入HashMap,第二趟根据原链表结构设置新节点的next和random指针。这种方法保证了新链表完全独立于原链表,满足深拷贝要求。时间复杂度O(n),空间复杂度O(n)。文章还指出了常见错误,并提到存在更节省空间的解法,但HashMap方案更直观可靠。该解法适用于
文章摘要 LeetCode 49题要求将字母异位词分组,关键在于为异位词构造统一标识。通过排序字符串,互为异位词的字符串会得到相同的排序结果,从而可作为哈希表的key。使用HashMap<String, List<String>>存储,key为排序后的字符串,value为对应的原字符串列表。该方法时间复杂度为O(N*KlogK),其中N是字符串数量,K是字符串平均长度。核心
摘要 本文介绍了解决旧键盘坏键识别问题的算法思路。题目要求通过比较期望输入串和实际输入串,找出所有坏键并按特定规则输出。核心解决策略包括:1) 统一转为大写字母处理;2) 使用HashSet快速判断字符是否存在;3) 通过遍历期望串顺序输出首次出现的坏键。算法时间复杂度为O(n+m),空间复杂度为O(1)。文中还分析了代码优化点,如避免重复创建Scanner对象等。该方案通过合理使用集合和遍历顺序
摘要: 本文对比了两种解决「宝石与石头」问题的方法。题目要求统计 stones 中属于 jewels 的字符数量。 HashSet 解法(推荐): 时间复杂度:O(|jewels| + |stones|) 利用 HashSet.contains() 的 O(1) 成员判断特性,高效计数。 List 解法(不推荐): 时间复杂度:O(|stones| * |jewels|) ArrayList.co
本文介绍了LeetCode经典题目“两数之和”的两种解法:双指针法和哈希表法。双指针法通过排序后调整指针位置寻找解,需注意保存原始索引,时间复杂度为O(n log n)。哈希表法则利用空间换时间,通过Map快速查找互补数,时间复杂度优化至O(n),是最优解法。文章详细解析了两种方法的实现细节、避坑点和适用场景,并提供了TypeScript代码示例。总结指出哈希表法是推荐首选,同时强调理解题目约束条
(如“某用户是否访问过该页面”)、(如“某关键词出现次数”)、(如“独立访客数统计”)。此类场景的核心约束是且,传统精确数据结构面临显著瓶颈。
本文主要介绍了博主的学习哈希的理解。介绍了哈希的基本概念,如哈希函数,哈希冲突,哈希冲突的解决方法。同时实现了开放定址法和拉链法的代码。
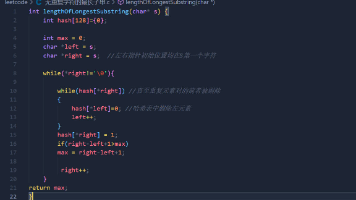
本文介绍了一种使用滑动窗口算法结合哈希表高效求解"最长无重复字符子串"问题的方法。通过维护左右指针动态调整窗口范围,利用哈希表快速判断字符重复性,确保时间复杂度为O(n)。详细步骤包括算法原理、示例演示、代码实现及边界处理,适用于各类字符串场景。该方案空间复杂度为O(1),能正确处理空串、全重复字符等特殊情况。
原理:固定速率生成令牌放入桶中,请求需获取令牌才能通过,桶满时令牌溢出。特点:允许突发流量(桶内令牌可累积),长期速率可控。优点:灵活性高,适应突发需求。缺点:实现稍复杂,参数(桶容量、令牌生成速率)需合理配置。应用场景:API网关、接口限流(如允许短时间峰值流量)。实现:用队列缓存令牌,原子类控制令牌生成与获取。
本文介绍了Linux内核中哈希表与哈希函数的核心实现及其应用。哈希表作为高效的数据查找基础设施,通过拉链法解决冲突,平均时间复杂度接近O(1),广泛应用于进程管理、文件系统、网络等领域。文章详细分析了哈希表的历史演进、核心原理、优势与局限性,并与链表、红黑树等数据结构进行了对比。内核通过通用哈希框架(lib/hashtable.h)和多种哈希函数(include/linux/hash.h)优化性能
就是哈希表
哈希表是一种通过哈希函数将键(key)映射到表中特定位置来访问记录的数据结构,这种映射关系可以加快查找速度。### 基本概念- **键(Key)**:用于查找的唯一标识- **值(Value)**:与键关联的数据- **哈希函数(Hash Function)**:将键转换为数组索引的函数- **哈希冲突(Hash Collision)**:不同键映射到相同索引的情况哈希表是Java中最高效的数据结
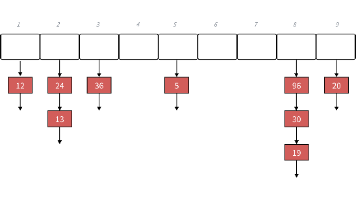
redis中的hashtable(哈希表)是一种高效的键值对存储结构,主要用于实现redis的字典类型,接下来就来讲解一下hashtable(redis版本6.2.18)的底层实现。在redis的hashtable实现中,哈希冲突发生在两个或多个不同的键(key)被哈希函数映射到同一个哈希桶(bucket)的情况。1、扩容条件:当负载因子(哈希表已使用的节点数量/哈希表大小)> 1时,且服务器没有
函数参数为序列长度n、先序序列preOrder、中序序列inOrder和输出序列outOrder。1<=n<=1000000,树的深度<=2000。提交格式:实现void solve(int n, int *preOrder, int *inOrder, int *outOrder)函数。用先序序列和中序序列构建二叉树,采用二叉链表存储。编写递归算法,交换二叉树的左右子树,输出新二叉树按先序遍历得
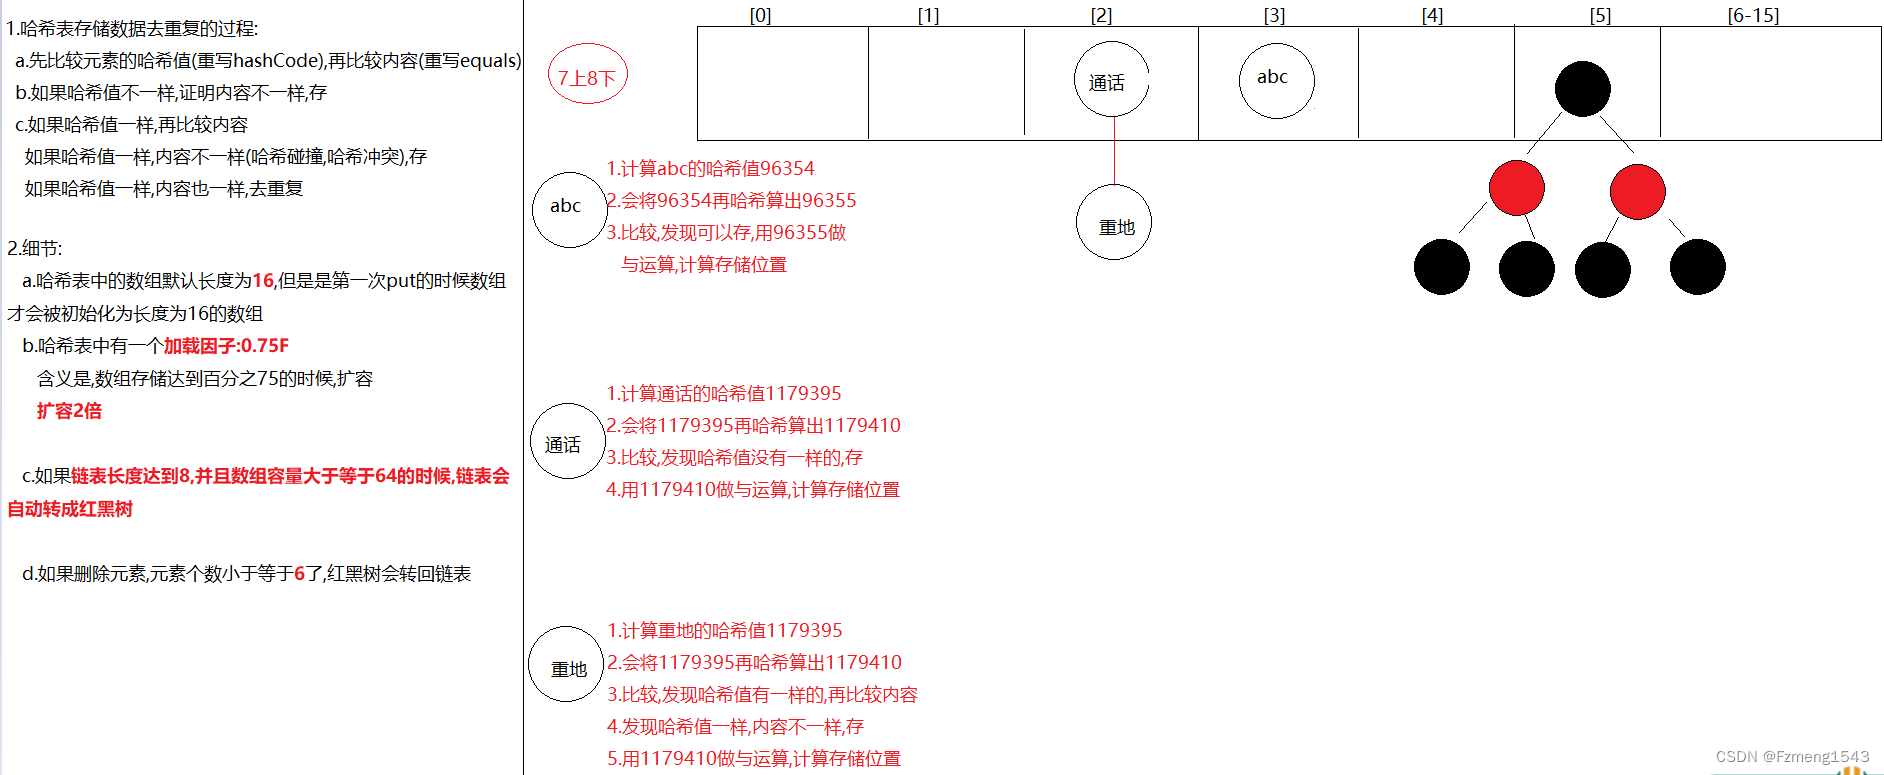
哈希冲突发生在两个不同的键被哈希到同一个桶的位置。由于数组的大小有限,而键的哈希值的范围可能非常大,因此多个键值对可能会被哈希到相同的位置,这时就产生了哈希冲突。HashMap是一种高效的哈希表实现,它通过数组和链表(或红黑树)结合的方式来存储数据,并通过哈希函数将键映射到数组中的桶。在处理哈希冲突时,HashMap使用链地址法和红黑树优化链表的方式来保证较高的性能。了解HashMap的底层实现和
滑动窗口的核心思想是通过两个指针动态维护一个窗口,确保窗口内的字符没有重复,并记录最大长度。下面是模板// 哈希表,记录字符的状态// 窗口的起始位置// 记录最大长度s[end];end++) // 遍历字符串// 更新窗口的状态(例如:记录字符的出现次数或位置)// 如果窗口不满足条件,则收缩窗口while (/* 窗口不满足条件 */)// 更新窗口的状态start++;// 收缩窗口//
另外尽管题目中说明了对密码格式的要求,但实际上题目并没有给出相应的正确输出格式示例,测试用例中也没有测试点。所以也就没写这部分函数。下面是题解,哈希函数依旧使用了针对性能优秀的DJB2算法。和上一篇的题没有什么区别,只是多了一些过程控制。
既然不用关系型数据库,但就从非关系型数据库里面做选择了,很多的架构师会选择使用mongodb 存购物车的数据,这也完全可以,mongodb有非常丰富的查询API,性能也比传统关系型数据库要好,使用mongodb确实是个不错的选择。这样的设计在功能完全没问题,但在实际使用中,由于购物车的数据量太大,而且修改频繁,会导致数据库的压力增加,所以在正式项目开发中,一般不会直接使用关系型数据库来存储购物车信
HashMap是一个高效的集合类,适用于大量数据的存储与查找。在实际使用时,了解其底层实现原理能够帮助我们更好地理解其工作机制,避免在哈希冲突和扩容等问题上遇到性能瓶颈。通过本文的分析,希望大家对HashMap的底层数据结构、存储过程以及性能有了更清晰的认识。在实际项目中合理使用HashMap,能够提升代码的性能和可读性。
命令执行效果时间复杂度设置值O(1)获取值O(1)删除fieldO(1)hlen key计算field个数O(1)获取所有的field-valueO(K)批量获取field-valueO(K)判断field是否存在O(1)hkeys key获取所有的fieldO(K)hvals key获取所有的valueO(K)设置值,但必须field不存在时才可以设置成功O(1)对应field的value +
给定一个长度为n的整数数组nums,数组中的数的范围是[1, 100]。请返回nums中出现一次的数的和。
根据设定的哈希函数H(key)和处理冲突的方法将一组关键字映像到一个有限的连续的地址集(区间)上,并以关键字在地址集中的“像”作为记录在表中的存储位置,这种表便称为哈希表。[可理解为哈希表是由哈希函数和记录的存储位置组成]这一映像过程称为哈希造表或散列,所得存储位置称哈希地址或散列地址。
当key是string/Date等类型时,key不能取模,那么我们需要给HashTable增加一个仿函数,这个仿函数支持把key转换成一个可以取模的整形,如果key可以转换为整形并且不容易冲突,那么这个仿函数就用默认参数即可,如果这个Key不能转换为整形,我们就需要自己实现⼀个仿函数传给这个参数,实现这个仿函数的要求就是尽量key的每值都参与到计算中,让不同的key转换出的整形值不同。如果是2^x
开放寻址法在低负载因子时效率较高,而链式哈希在高负载因子下表现更稳定。
是个存储结构:可以让我们一次从表中直接拿到想要的元素,时间复杂度为O(1)为什么能实现O(1):通过哈希(散列)方法,使元素的存储位置和它的关键码之间建立一一映射的关系如果想要存取元素,都是利用哈希(散列)方法 + 关键码,从而计算出index位置,然后进行操作(怎么放的就怎么给它取出来哈希函数示例:此时写着容量是1000,但实际上是2次幂数,容量为1024。
前置知识:设置参数后,下一个循环才会切换对应动画,所以在下一个循环获取真实的动画长度AnimatorStateInfo是结构体!值类型,要不断重复获取才是最新的但是我用的连击动画为了好的手感将动画结束时间提前,这就导致进入这里的currentAm 可能是上一次的攻击动画所以需要判断来特殊处理攻击动画。
数组+哈希+双指针+子串+滑动窗口
哈希表的介绍以及实现、unordered系列关联式容器、哈希概念、哈希函数、直接定址法、除留余数法、哈希冲突、闭散列、线性探测、二次探测、开散列、代码实现
在JDK8中,HashMap的数据结构从数组链表转换为数组红黑树。这一改进使得HashMap在处理哈希冲突、查找、插入、删除等操作时具有更好的性能表现。通过将链表转换为红黑树,HashMap提高了查找、插入、删除等操作的效率,减少了极端情况下的性能下降。然而,红黑树的插入、删除等操作相对复杂,所以只有在链表长度超过一定阈值时才会触发转换操作。希望本篇博文对你理解HashMap的数据结构有所帮助。如
一致性哈希算法也是使用取模的方法,但是取模算法是对服务器的数量进行取模,而一致性哈希算法是对 2^32 取模,具体步骤如下:步骤一:一致性哈希算法将整个哈希值空间按照顺时针方向组织成一个虚拟的圆环,称为 Hash 环;步骤二:接着将各个服务器使用 Hash 函数进行哈希,具体可以选择服务器的IP或主机名作为关键字进行哈希,从而确定每台机器在哈希环上的位置。
头歌上的答案
java做leetcode,因为以前用c++,所以同时也会记录一下用到的java知识
当我们用哈希函数的时候,其中一个就是取这个表的长度len,按照哈希函数:Hash(key) = key% len,将这个位置映射到表中通过上面的除留余数法,会有的问题,可以通过来解决也叫,通过线性探测,依次找后面的位置存储。
Data Structure Visualization
哈希表结构存储过程 原理及实例详解(Java) - 集合
并且可以在查询中提供更快的查找速度,特别是在大型数据集中。字段创建哈希索引,用于快速查找密码哈希值。哈希索引的主要优势在于对于精确匹配查询的。查询方面与普通索引并没有太大的不同。然而,哈希索引也有一些限制,例如。可能会影响索引性能。
嵌入式软件开发第三部分,各类常用的数据结构及扩展,良好的数据结构选择是保证程序稳定运行的关键,(1)部分包括数组,链表,栈,队列。(2)部分包括树,堆。(3)部分包括散列表,图。
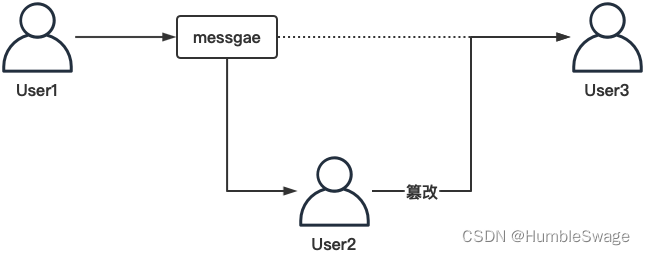
从哈希函数入手,将需要发送的数据进行哈希运算,将哈希值和原始值一并发送,需要在进行哈希运算的时候引入加密的步骤。在user1对数据进行哈希运算的时候引入一个密钥,让其参与哈希运算,生成的散列值一并发送。这一行为一般是有消息的接受者来完成的,但也可以由需要验证消息的第三方来完成。生成签名就是对消息内容计算数字签名的值。相比于上面的RSA加密方式,如果你的message比较大,需要设置一个合适的bit
LeetCode哈希表题目推荐(含题解)
哈希算法
——哈希算法
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 人工智能6S服务平台


 火山引擎视频云技术社区

 AI编程社区

 乐奇 Rokid 开放社区