登录社区云,与社区用户共同成长
邀请您加入社区
毕业设计 深度学习人体姿势姿态识别。
本项目基于大数据技术构建电商可视化分析平台,解决传统分析模式效率低、维度单一等问题。采用Hadoop+Spark实现海量数据的高效处理,结合K-Means、FP-Growth等算法进行用户画像与关联规则挖掘,通过Vue.js与ECharts实现多维度动态可视化展示。系统涵盖销售趋势、支付行为、促销效果、订单履约等核心模块,支持下钻联动与实时监控,助力企业实现数据驱动的精细化运营,提升决策效率与市场
本项目基于电商行业数据爆发背景,构建了一套基于Hadoop与Spark的大数据处理平台,结合K-Means聚类与RFM模型,实现客户行为深度分析。系统采用前后端分离架构,前端基于Vue.js与ECharts实现多维度可视化看板,涵盖流量来源、客户分群、会员消费、地域偏好等核心模块,支持交互式数据洞察,助力企业精准营销与精细化运营。
kmeans算法是如何与yolo模型结合,又是如何实现模型优化的呢?
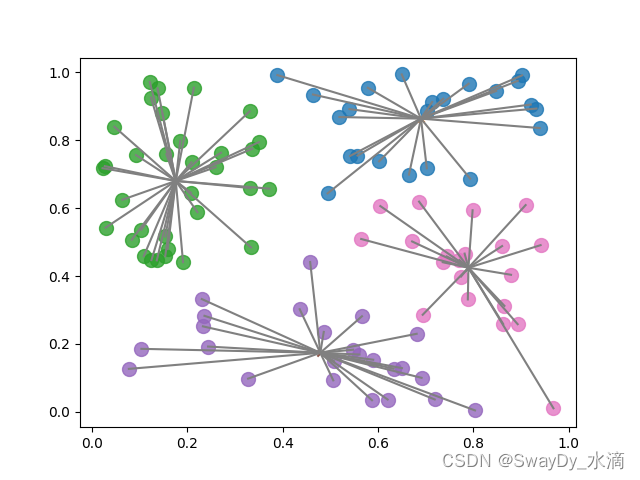
无监督学习算法,主要用于将相似的样本自动归到一个类别中;计算样本和样本之间的相似性,一般使用欧式距离误差平方和SSE (The sum of squares due to error)SSE 越小,表示数据点越接近它们的中心,聚类效果越好# @FileName : 03-顾客数据分析.pyimport osos.environ["OMP_NUM_THREADS"] = '1'# 解决内存泄露警告
一、什么是K-means 聚类算法?、二、聚类效果评价方式——轮廓系数、三、示例:代码实现、四、聚类算法的优缺点
为了克服K-均值算法收敛于局部最小值的问题,还有一种方法是二分K-均值的算法。
随着电力系统规模的不断扩大和负荷的快速增长,电压控制问题日益突出。传统的集中式电压控制方法难以应对大规模电力系统中复杂的电压波动和控制需求。为了提高电压控制的效率和可靠性,近年来,分布式电压控制技术得到了广泛的研究和应用。其中,基于集群划分的电压控制方法是一种有效的策略,它将电力系统划分为多个独立的集群,每个集群内部进行独立的电压控制,从而提高系统的整体控制效率。KMeans聚类算法KMeans算
K均值(K-means)是一种常用的聚类算法,用于将数据集划分为K个不同的组(簇),使得每个数据点属于与其最近的均值点所代表的簇。K均值算法的基本思想是通过迭代优化,将数据点分配到K个簇中,并调整簇的均值(中心)以最小化簇内数据点与对应中心点之间的距离。K均值算法的步骤如下①初始化:随机选择K个初始中心点(可以是数据集中的任意数据点)作为各个簇的中心。②分配数据点:对于每个数据点,计算其与各个中心
1. 有监督学习是说模型在训练的时候,既需要特征矩阵X,也需要真实标签y。无监督学习是说在训练的时候只需要特征矩阵X,不需要标签。2. 聚类算法又叫做“无监督分类”,其目的是将数据划分成有意义或有用的组(或簇)。聚类和分类的直观上比较可参考下图:聚类分类核心将数据分成多个组,探索每个组的数据是否有联系从已经分组的数据中去学习,把新数据放到已经分好的组中去学习类型无监督,无需标签进行训练有监督,需要
吴恩达机器学习python作业之K-means。不定时更新与补充之前的笔记。
机器学习-二分KMeans由于传统的KMeans算法的聚类结果容易受到初始聚类中心点选择的影响,因此在传统的KMeans算法的基础上进行算法改进,对初始中心点选取比较严格,各中心点的距离较远,这就避免了初始聚类中心会选到一个类上,一定程度上克服了算法限入局部最优状态。二分KMeans(Bisecting KMeans)算法的主要思想是:首先将所有点作为一个簇,然后将该簇一分为二。之后选择能最...
实现Kmeans算法实现聚类要求:1、根据算法流程,手动实现Kmeans算法;2、调用sklearn中聚类算法,对给定数据集进行聚类分析;3、对比上述2中Kmeans算法的聚类效果。读取文件def loadFile(path):dataList = []#打开文件:以二进制读模式、utf-8格式的编码方式
sse
基于大数据的智能家居能源系统数据可视化分析,用 Hadoop、Spark 做数据处理,Python 做预处理,K-Means 做负荷聚类分群,FP-Growth 挖设备共现规则,Isolation Forest 识别异常用能。分析维度覆盖季节能耗、时段负荷、周末对比、户型能耗、入住负荷、空调采暖、家电构成、光伏出力、峰时占比、温耗关系、异常率和月度趋势。可视化大屏把月度用电与光伏、分时充电、家庭规
import sys#The sys module contains functions related to the Python interpreter and its environment.from typing import List#The typing library is a library that helps us implement type annotationsimpor
KMeansclass pyspark.ml.clustering.KMeans(featuresCol=‘features’, predictionCol=‘prediction’, k=2, initMode=‘k-means||’, initSteps=2, tol=0.0001, maxIter=20, seed=None, distanceMeasure=‘euclidean’)使用类似
01.导入模块,生成对象from pyspark.sql import SparkSessionfrom pyspark.ml.feature import VectorAssemblerfrom pyspark.ml.clustering import KMeans,KMeansSummaryspark = SparkSession.builder.config("spark.driver.ho
本系统基于Spark与Hadoop构建,结合Django、Vue和Echarts实现全球电商订单交付与退货数据的多维分析。通过文件上传、预处理与Spark分析模块,完成15项核心分析任务,涵盖国家延误率、承运商准时率、退货原因分布、履约聚类等,支持可视化大屏展示。系统具备高扩展性与实用性,助力企业优化物流策略。如需完整源码、定制开发或文档支持,欢迎咨询交流。
本文设计并实现了一套基于大数据的电商销售数据可视化分析系统,融合Hadoop、Spark与Python机器学习技术,构建多维度数据分析平台。系统通过K-Means聚类实现用户分层,结合异常检测与可视化大屏,动态呈现销售趋势、地区分布、支付行为、促销效果等核心指标,助力企业实现数据驱动的精细化运营。前端采用Vue与Echarts实现交互式展示,后端基于MySQL存储,具备高扩展性与实用性。
本项目基于Spark与Hadoop构建多平台电商消费行为分析系统,整合淘宝、京东等六大平台数据,实现数据清洗、多维统计与价值挖掘。通过K-Means、FP-Growth、Isolation Forest等算法,完成用户分群、关联规则与异常检测,支持平台对比、用户画像、商品偏好、地域差异及时间趋势分析,并以Django+Vue+Echarts实现可视化大屏展示。系统具备可扩展性与复用性,助力电商运营
本项目构建基于大数据的生成式AI用户行为与算力消耗分析系统,采用Hadoop+Spark架构实现海量日志分布式处理,结合Python机器学习(K-Means聚类)与Vue+ECharts可视化技术,从用户活跃、算力消耗、反馈质量等维度打造多维数据看板。通过热力图、折线图等动态图表揭示用户分群特征与付费转化路径,助力优化资源调度与运营策略,实现算力高效利用与商业价值提升。
Manus 推出新产品 Cue,定位为永远在线的个人 Agent,为其配备独立邮箱、电话、钱包与云电脑。本文基于 Mac 桌面端进行第一轮实测,介绍其工作台布局:左侧管理多个自主创建的 Agent,中间为对话区,右侧负责设置、支付、自动化与记忆。文章还分享了用邀请码注册的流程和初步体验感受。
Java语言Java语言是目前最流行的语言之一,不仅可以做桌面窗口形式的程序,还可以做浏览器访问的程序,目前最流行的就是用Java语言作为基础,做各种程序的后台处理。Java语言是操作变量的语言,而变量则是Java对于数据存在形式的定义,变量用来操作内存,而内存则牵扯到计算机安全问题,这样Java语言反而有了免疫直接针对用Java语言开发出来的程序的病毒,有效的提高了Java语言开发出来程序的生存
Morris遍历是一种用于二叉树遍历的算法,它以一种递归和非递归的方式进行。这个算法的名字来自于它的发明者J. H. Morris。Morris遍历的主要思想是利用树的结构来遍历,而不是使用栈或递归。它有两种不同的实现方式:递归方式:在递归实现中,我们从树的根节点开始遍历。如果当前节点为空,我们直接返回。如果当前节点有左子树,我们通过递归调用Morris遍历来遍历左子树。
本文基于k-means算法构建校园美食推荐系统,采用Python开发,整合Scrapy爬虫、Hadoop分布式处理等技术。系统通过爬取校园周边多维美食数据,利用优化后的k-means算法进行聚类分析,结合Django框架和MySQL数据库实现个性化推荐。研究表明,该系统能有效提升校园美食推荐的精准度和用户体验,为校园信息化建设提供新思路。关键词:美食推荐、k-means算法、Scrapy爬虫、Ha
本文主要聚焦于Django框架下基于K-means算法的图书推荐系统的设计与实现。该系统旨在优化图书推荐流程,通过K-means聚类算法对用户偏好和书籍特征进行深入分析,从而提供更为精准的个性化推荐服务。系统采用Django作为后端开发框架,充分利用其高效、可扩展的特点,结合MySQL数据库进行数据管理,实现了对图书信息的有效存储与快速检索。在方法层面,我们首先从图书数据中提取关键特征,运用K-m
随着校园美食文化的日益丰富,如何为学生精准推荐美食成为一个重要课题。本项目基于 k-means 算法构建校园美食推荐系统,采用 Python 语言进行开发,借助 Scrapy 爬虫技术高效抓取校园周边美食数据,涵盖美食名称、店铺、价格、评分等多维度信息,为系统提供丰富的原始数据资源。为应对海量数据的存储与处理需求,引入 Hadoop 框架,其强大的分布式存储与计算能力,确保数据的高效处理与分析,使
基于改进K-means聚类与残差网络的白细胞检测与分类算法,运用了深度学习技术中的YOLO目标检测算法结合注意力机制(CBAM)和残差网络(ResNet)解决了白细胞检测定位不准确和分类识别精度低的问题,实现了从外周血图片中自动检测、分割和识别五类白细胞的功能。对于计算机专业、软件工程专业、人工智能专业、大数据专业的毕业生而言,选择一个合适的毕业设计选题至关重要。在这个毕业设计选题合集中,我们精心
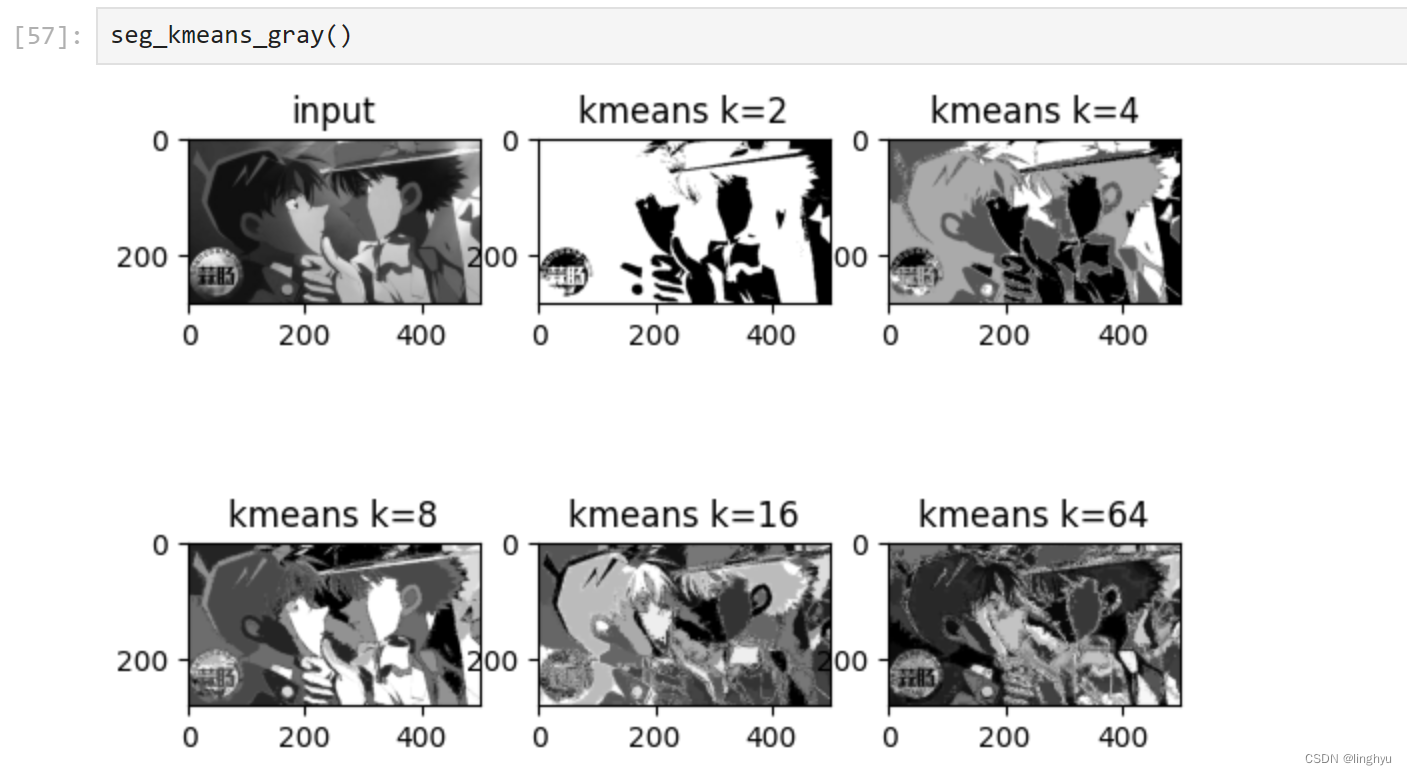
以下是基于 MATLAB 的 K-means 聚类算法实现图像分割的完整代码。K-means 是一种常用的无监督学习算法,用于将图像像素分组到不同的聚类中,从而实现图像分割。通过上述方法,您可以快速实现基于 K-means 聚类算法的图像分割,并结合 GUI 界面实现良好的用户体验!k-means聚类算法的图像分割-matlab实现。
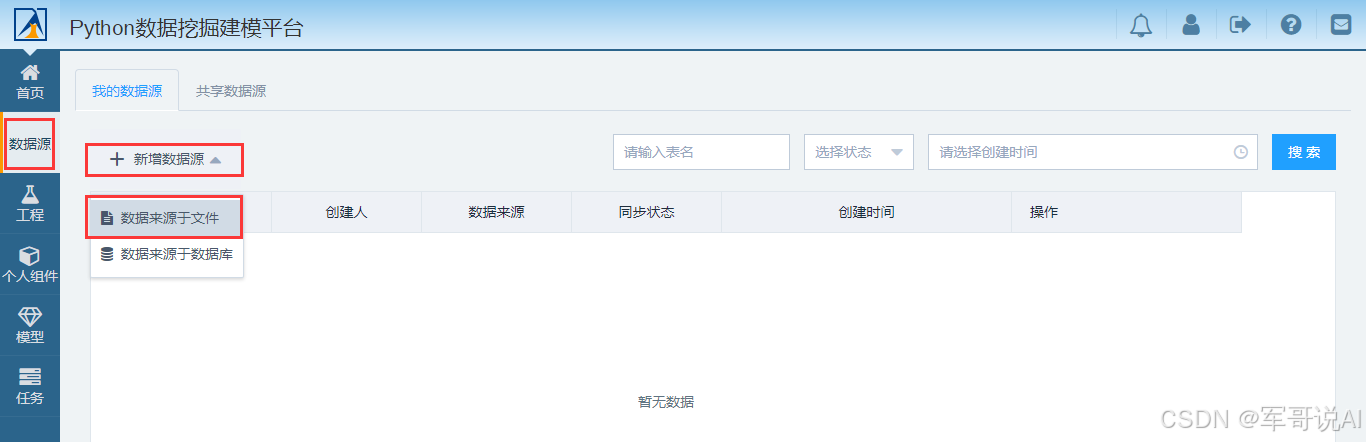
为了推进信用卡业务良性发展,减少坏账风险,该地区各大银行都进行了信用卡客户风。当属性间的量级相差较大时,数据标准化将数据统一映射到特定的区间,消除数据的量。运行完成后,对数据标准化组件右键,选择查看数据,数据标准化的输出表结果如。在本地路径上选择文件,填写在平台新建的目标表名,如图。根据文件的数据,可以修改文件的字段名和类型,如图。选择字段属性,单击更新数据,勾选全部字段。选择字段属性,在脚本处填
本文将深入探讨基于CEEMDAN-Kmeans-VMD-PLO-Transformer的多元时序预测方法,并结合Matlab代码实现进行详细分析。该方法融合了多种先进的信号处理和机器学习技术,旨在提升多元时序预测的精度和鲁棒性。其核心在于利用CEEMDAN进行信号分解,Kmeans聚类进行模式识别,VMD进一步优化分解结果,PLO算法优化Transformer模型参数,最终利用Transforme
基于Python 的kmeans车牌颜色分类实验
K-均值聚类算法就是一种典型的聚类算法,之所以称之为K-均值是因为它可以发现k个不同的簇,且每个簇的中心采用簇中所含值的均值计算而成。
通过对 K-means 聚类分割算法的设计与调用,了解了这些算法的工作原理和应用细节。也应用到图像数据上,进行了面向图像的像素聚类分割。在算法调用中,可以通过多组测试不同参数,如迭代次数、随机采样次数、聚类中心的变化阈值,来寻找对于当前图像类型分割效果最优的参数区间。该算法对于光照变化、噪声敏感,可能需要进行预处理,如直方图均衡化、高斯滤波等。K值(聚类数量)的选择对于结果影响很大,需要根据实际情
1、掌握MLP和BP神经网络流程,并实现分类任务2、掌握K-means算法流程,并实现聚类任务二、实验任务。
Python——Kmeans聚类算法、轮廓系数(算法理论、代码)_python kmeans-CSDN博客。轮廓系数取值范围[-1,1]
机器学习算法基础--K-means应用实战--图像分割
因子分析是主成分分析的扩展和推广,通过对小农户土地流转内卷化影响因素变量的相关系数矩阵内部结构的研究,导出能控制所有影响因素变量的少数几个不可观测的综合变量A,B,C,通过这少数几个综合变量去描述的多个农户土地流转内卷化影响因素变量之间的相关关系。通过因子分析法分析研究,从小农户土地流转“内卷化”的影响因素群中提取共性因子(这里的共性因子指的是不同影响因素之间内在的隐藏因子),把影响因素之间的错综
一 实验目的:利用matlab软件,通过K-means算法的方法处理给定的7幅遥感图像,将其分成水域、居民区和其他三类区域。二 实验方法:1 遥感图像的分类[1]遥感图像是通过反映地物光谱信息的像元亮度值及反映地物空间信息的像元空间变化来表征不同地物的。对遥感图像中各类地物的光谱信息和空间信息进行分析,选择特征(能够反映地物光谱信息和空间信息并可用于遥感图像分类处理的变量),并用一定的方式将特征空
kmeans学习笔记
K-means是机器学习中常见的一种非监督学习分类算法,主要是对一个不带标签的数据集进行相似性分析,进而将其分成若干类。
在本练习中,我们将实现K-means聚类,并使用它来压缩图像。 我们将从一个简单的2D数据集开始,以了解K-means是如何工作的,然后我们将其应用于图像压缩。 我们还将对主成分分析进行实验,并了解如何使用它来找到面部图像的低维表示。我们将实施和应用K-means到一个简单的二维数据集,以获得一些直观的工作原理。 K-means是一个迭代的,无监督的聚类算法,将类似的实例组合成簇。 该算法通过猜测
K-means算法是很典型的基于距离的聚类算法,采用距离作为相似性的评价指标,即认为两个对象的距离越近,其相似度就越大。
编程作业 7 - K-means 和 PCA(主成分分析)在本练习中,我们将实现K-means聚类,并使用它来压缩图像。我们将从一个简单的2D数据集开始,以了解K-means是如何工作的,然后我们将其应用于图像压缩。我们还将对主成分分析进行实验,并了解如何使用它来找到面部图像的低维表示。K-means 聚类我们将实施和应用K-means到一个简单的二维数据集,以获得一些直观的工作原理。K-mean
日拱一卒,功不唐捐。
文章目录前言一、层次分析法二、K-means聚类三、支持向量机(SVM)四、熵权法前言本文用于记录准备数学建模比赛时的算法学习,由于时间有限,算法原理及数学推导不再赘述,仅记录实现代码以及细节。一、层次分析法建模比赛中最基础的模型之一,其主要用于解决评价类问题(例如:选择哪种方案最好、哪位运动员或者员工表现的更%评价矩阵 由专家评估给出%一致矩阵data_std =[1 2 5;1/2 1 2;1
kmeans
——kmeans
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 地瓜机器人开发者社区


 快递鸟社区


 乐奇 Rokid 开放社区


 AtomGit AI 社区


 天工造物局





 DAMO开发者矩阵