登录社区云,与社区用户共同成长
邀请您加入社区
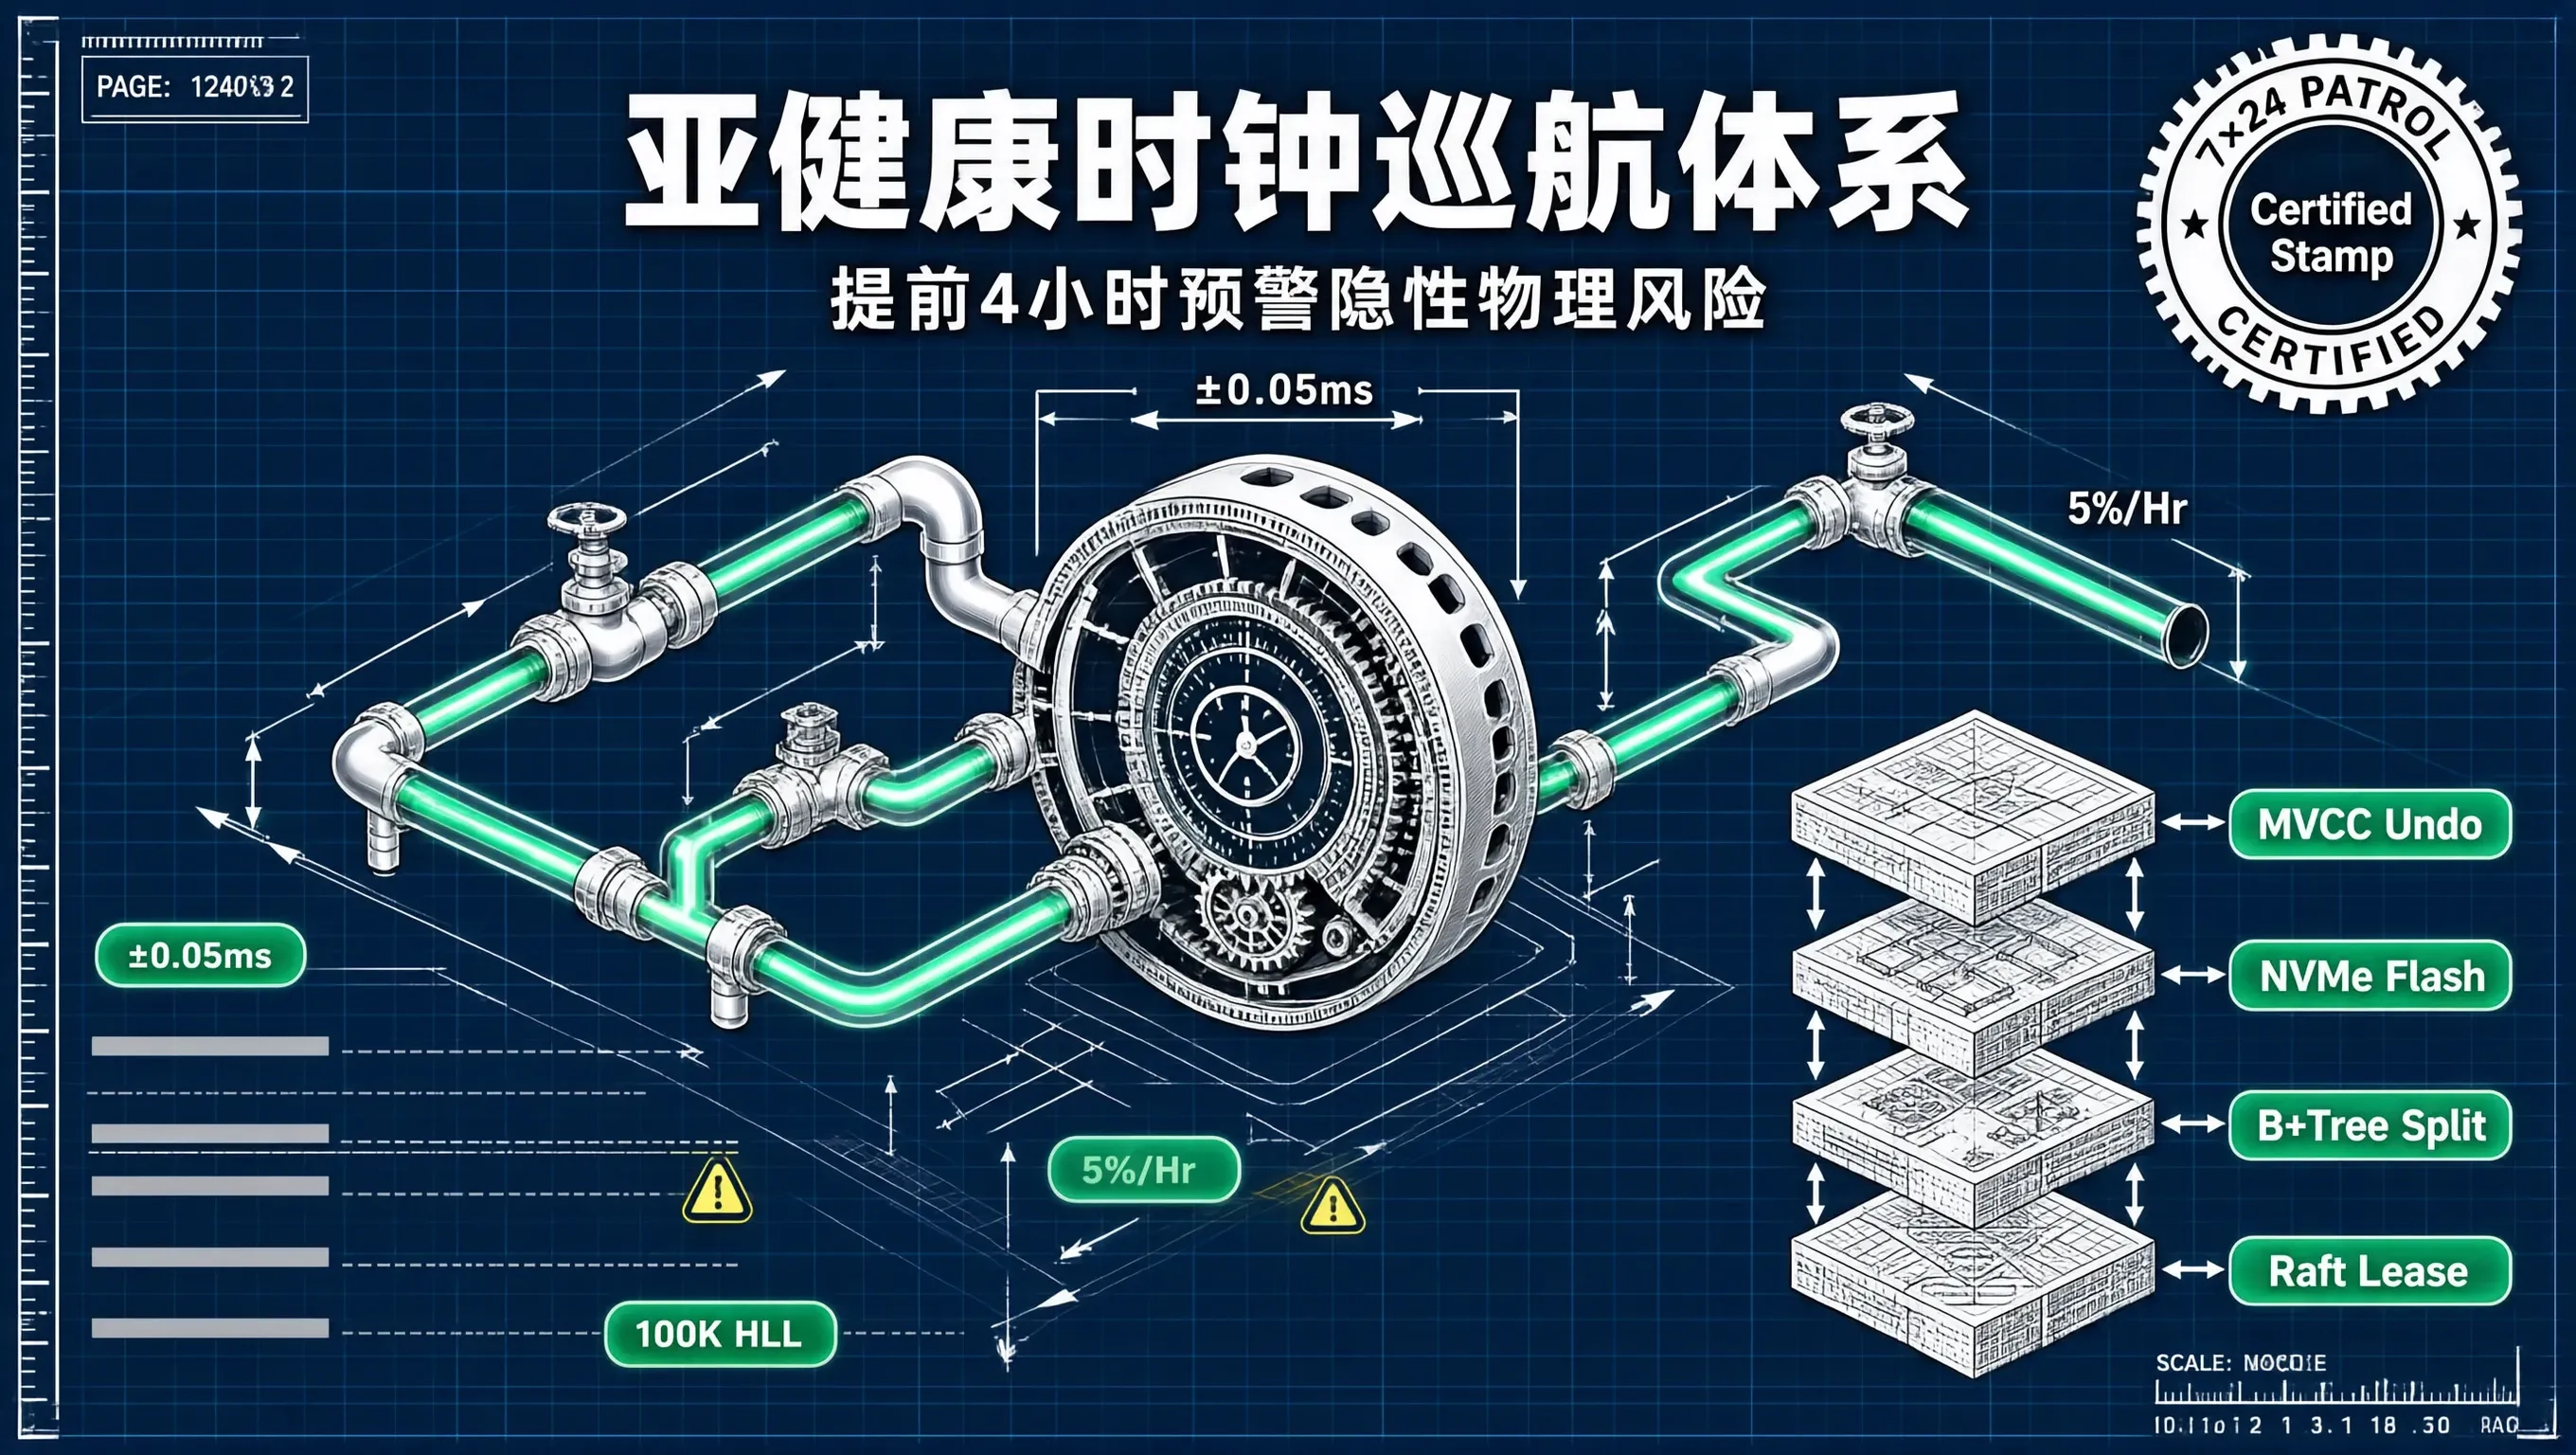
在大促开售后的连续数天长跑保驾期里,技术团队面临的最大隐患,往往不是那些“轰轰烈烈、瞬间打满 CPU”的明面故障;如果仅仅依赖传统的被动阈值告警,当监控大盘真正变红时,系统往往已经病入膏肓、濒临崩溃。为了在大促长跑期实现绝对的“防患于未然”,我们构建了一套。
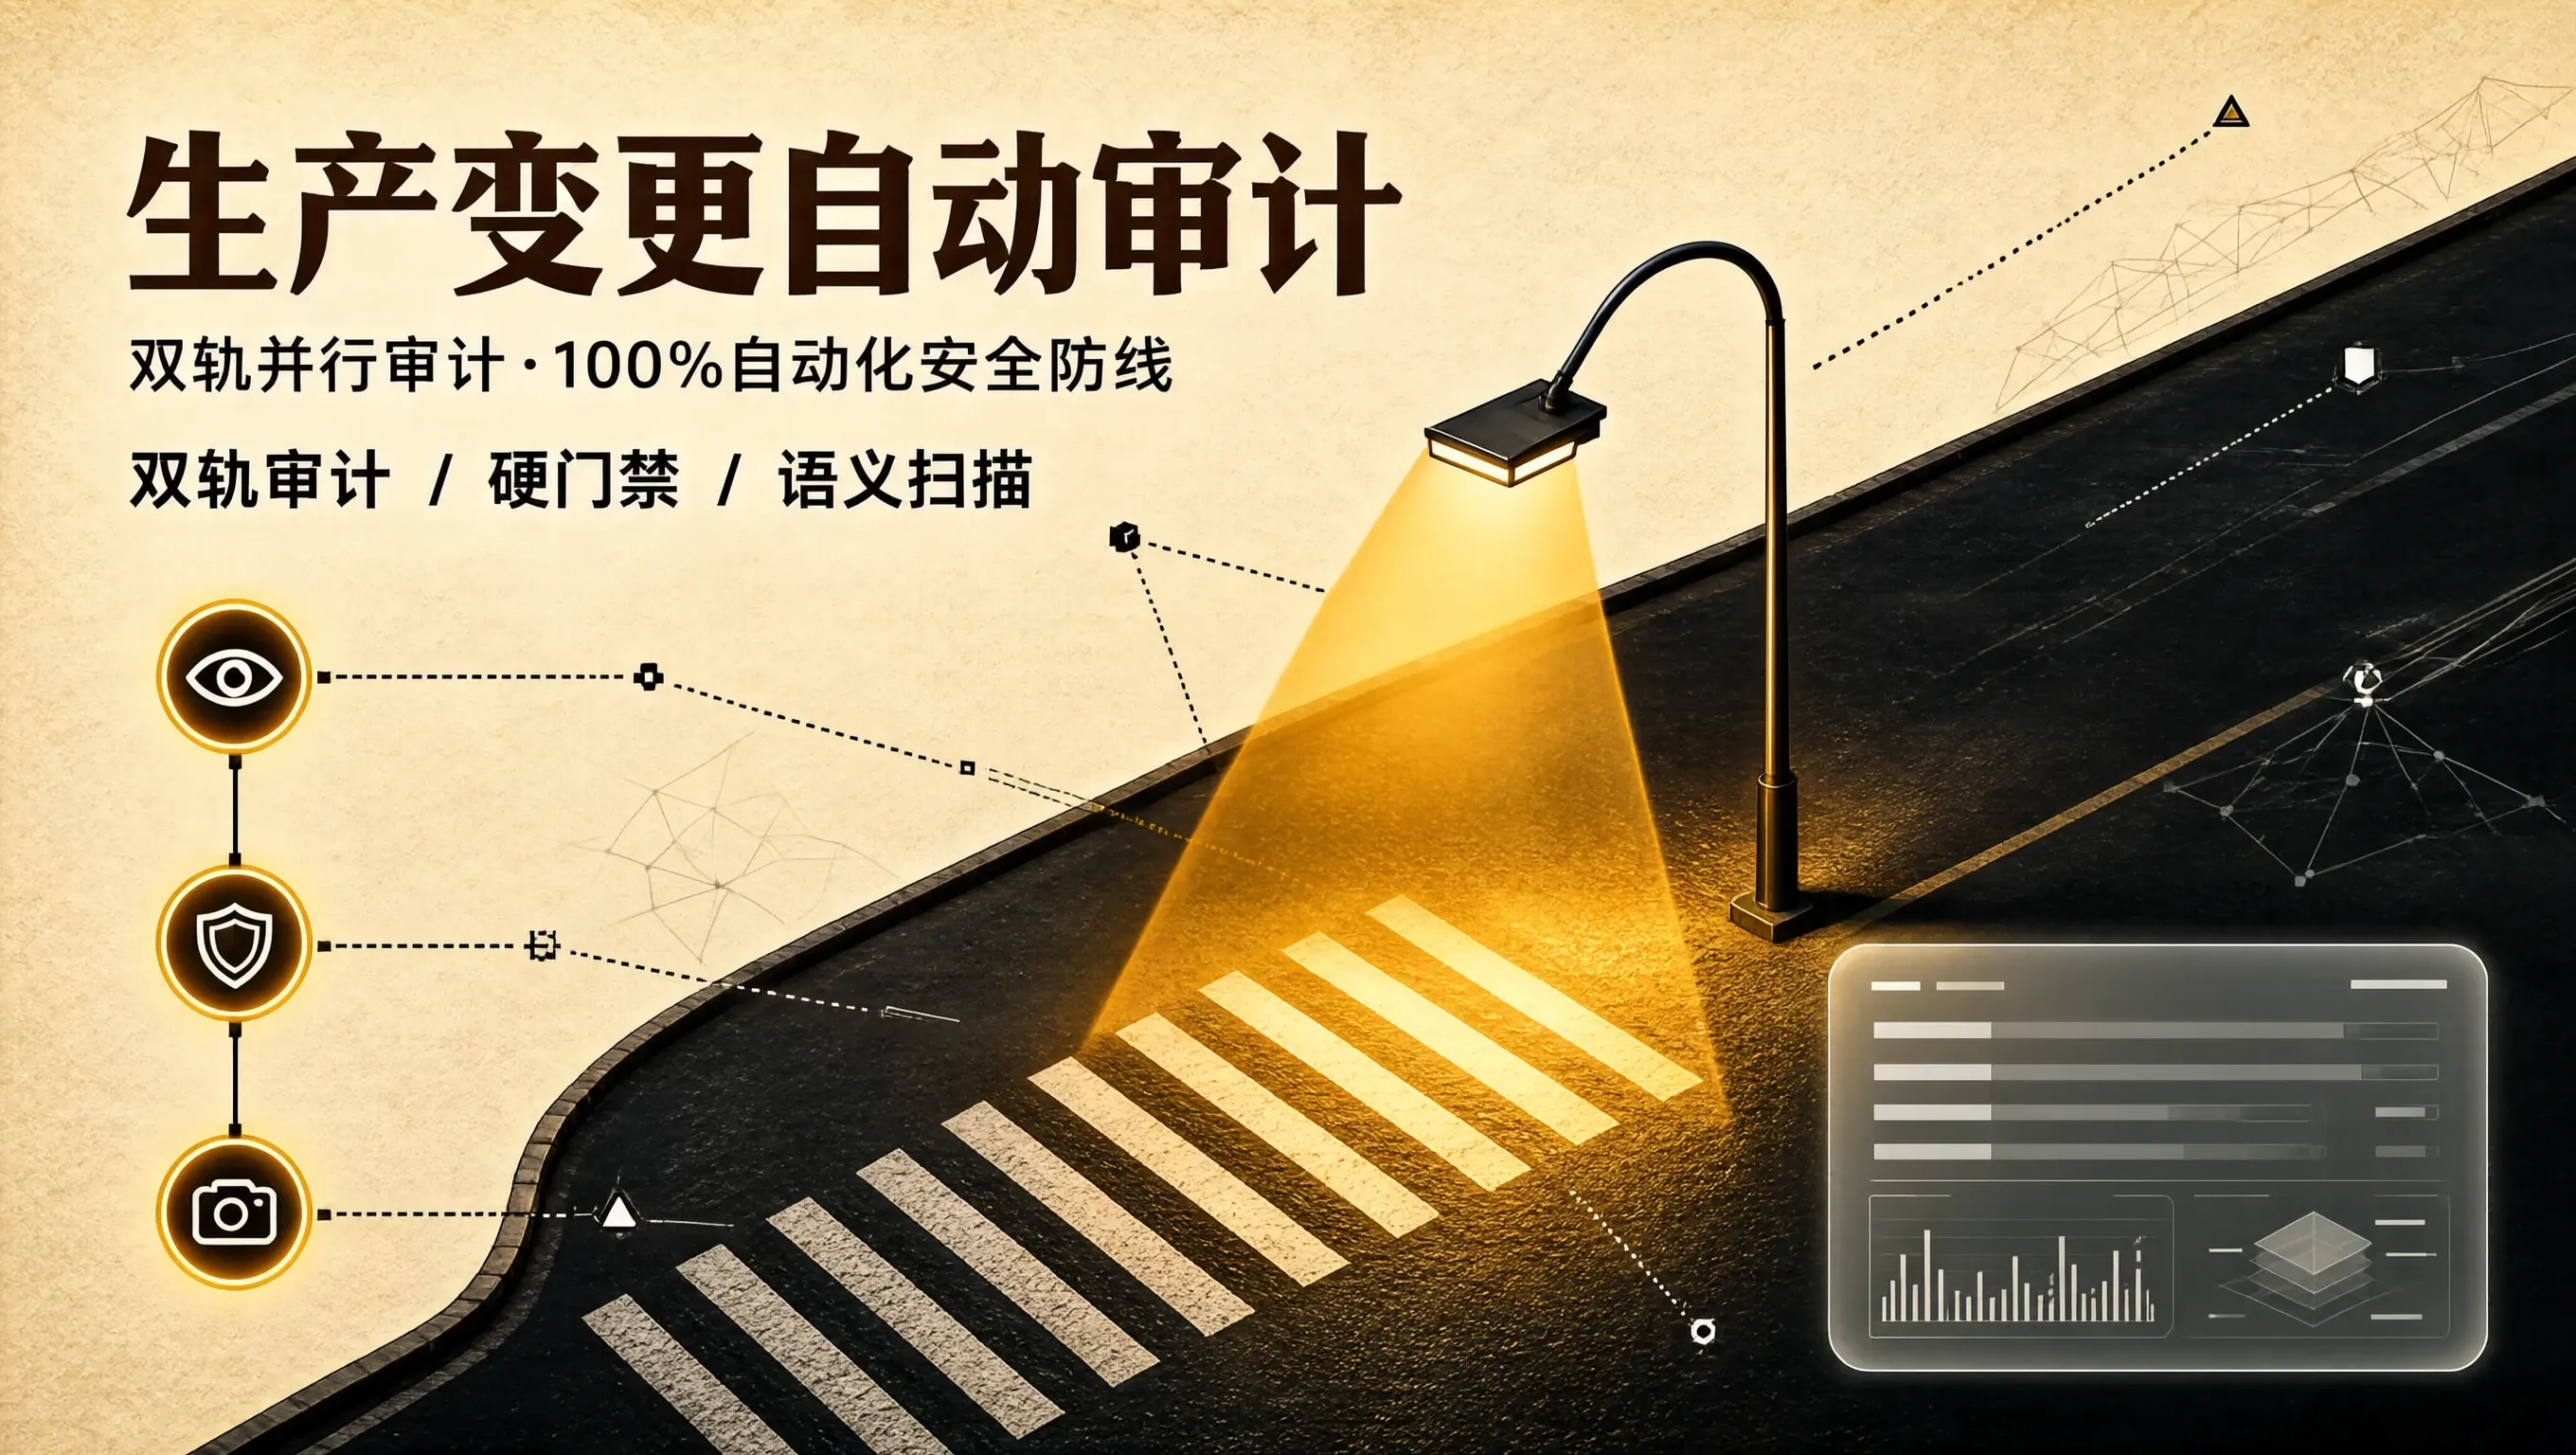
安全风控的终极境界,是“润物细无声的精准守护”。通过将大模型深度语义理解与堡垒机底层 PTY 代理深度融合,我们彻底终结了“手滑敲错一个字符摧毁整座机房”的人性梦魇,为大促期间的全站生产环境构筑了最安心的数字防线!
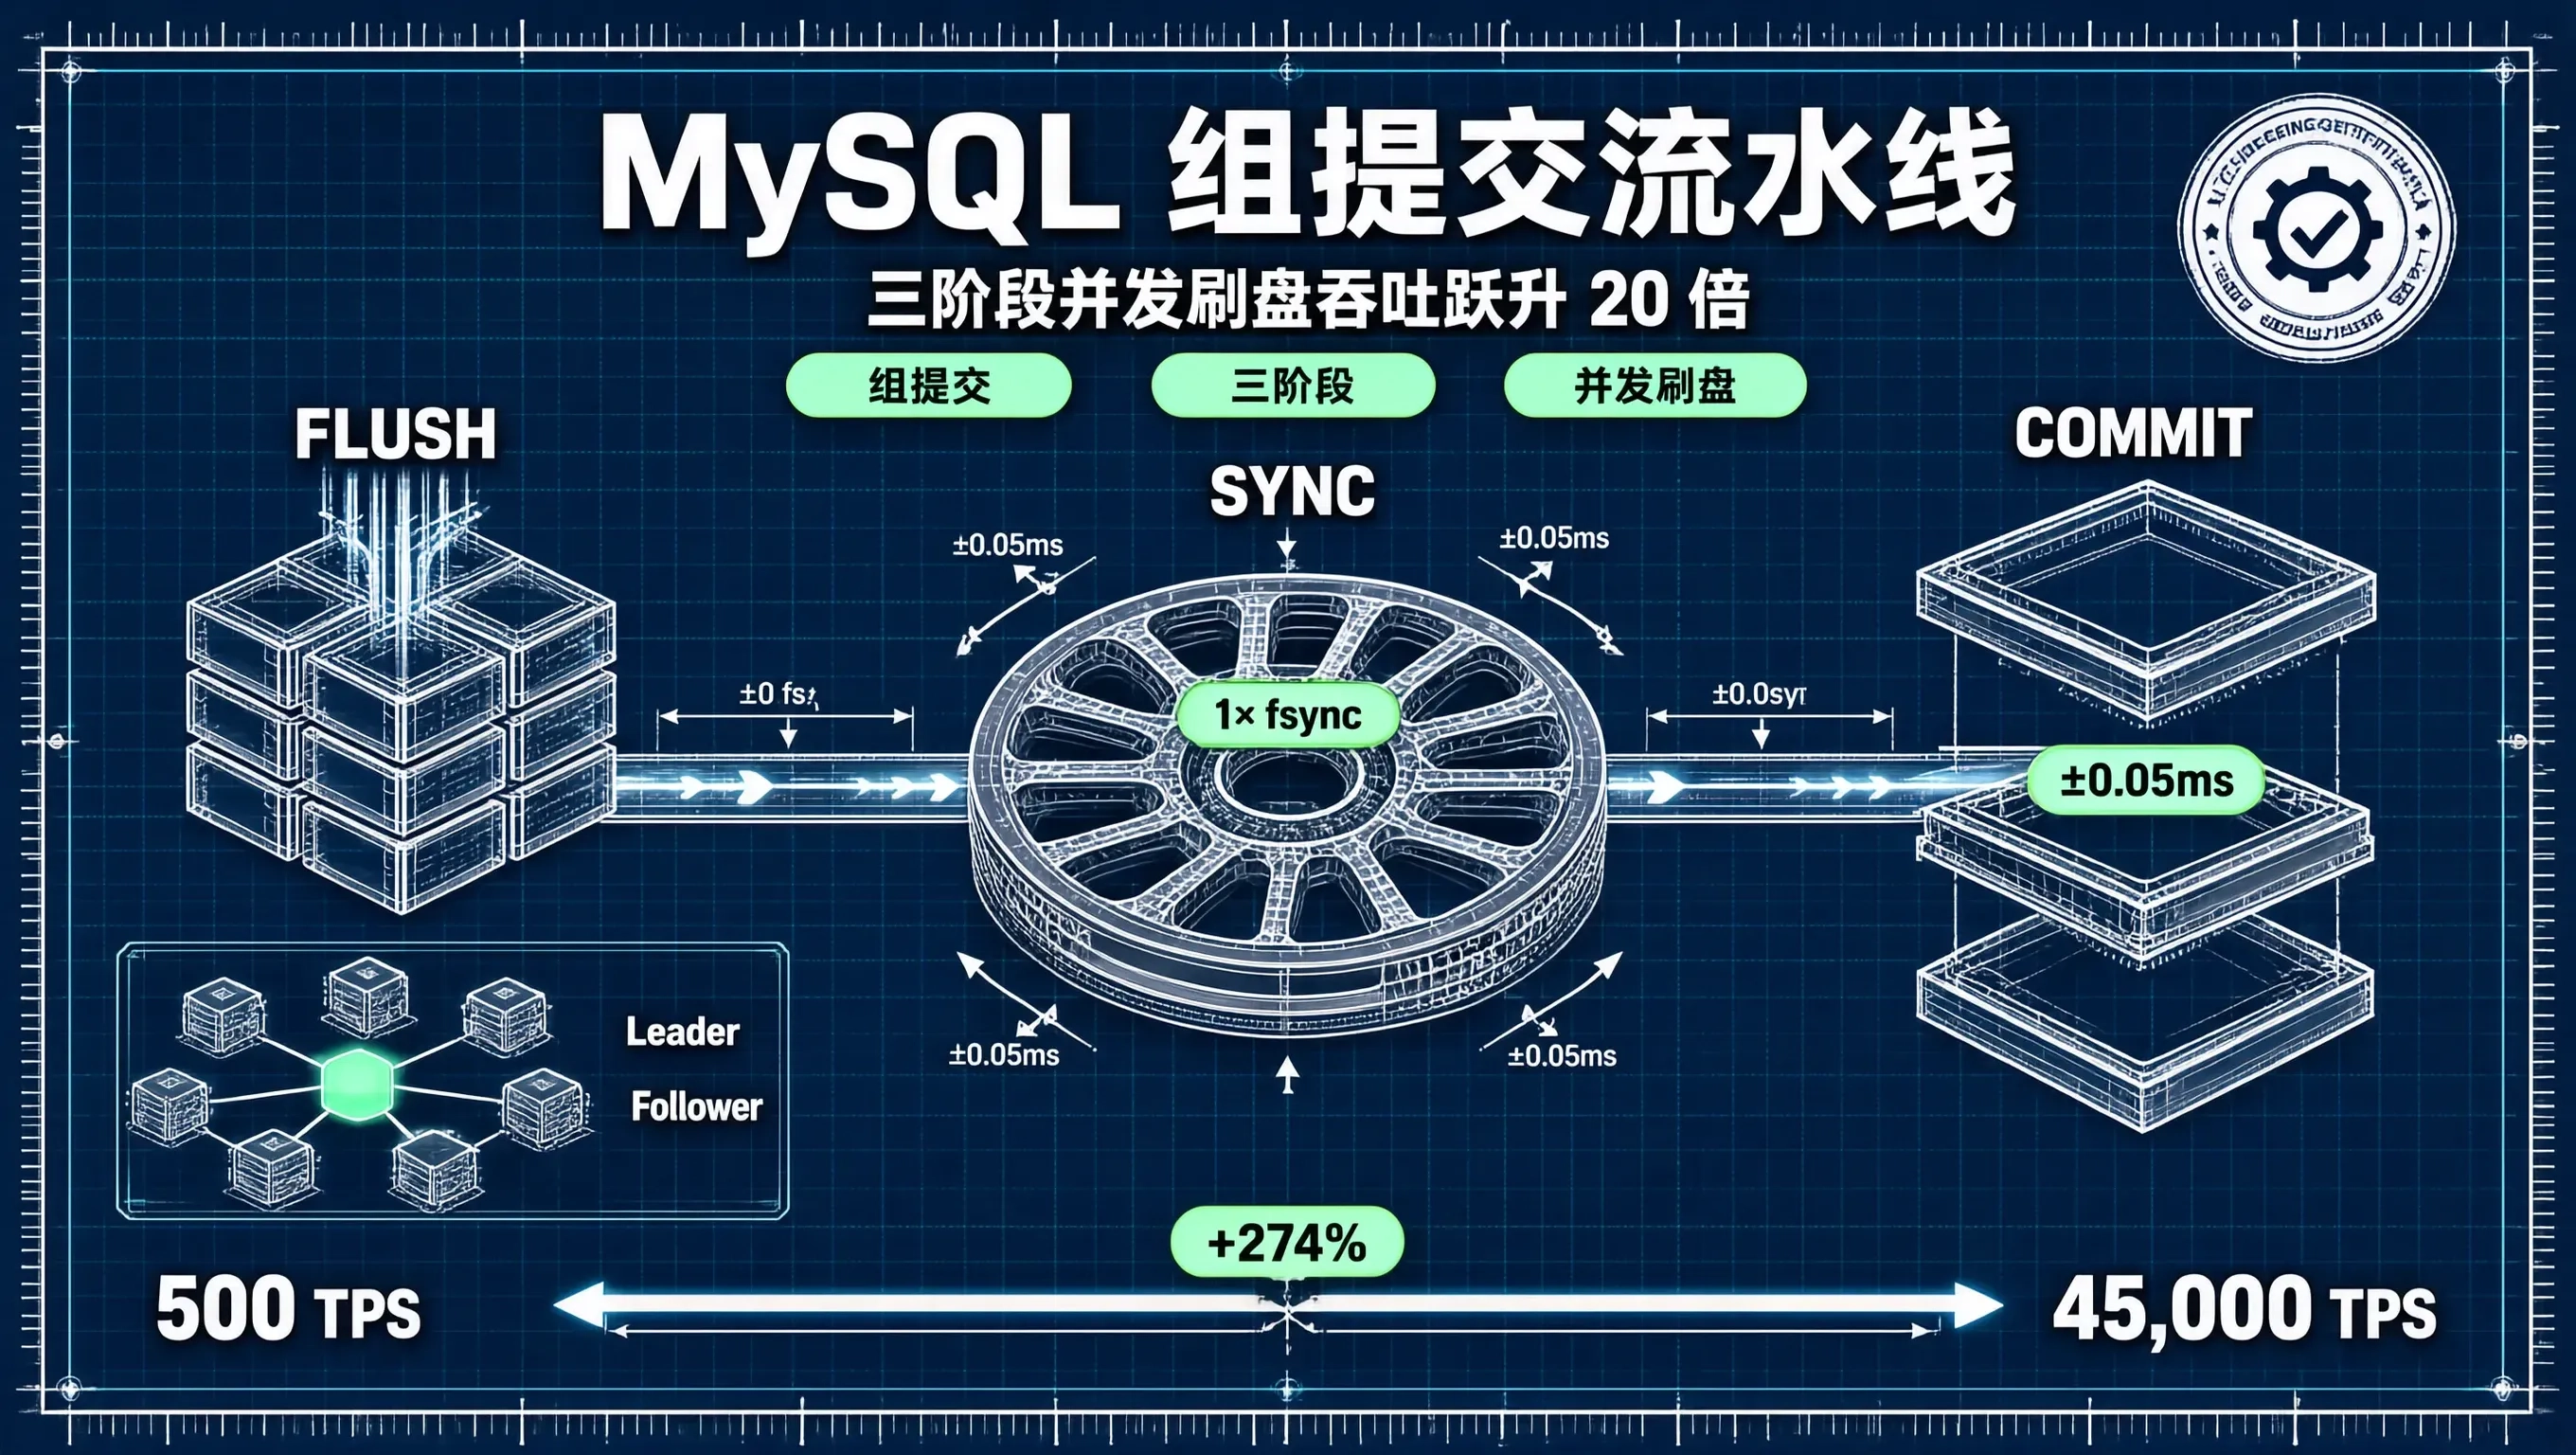
深入理解的三阶段流水线;科学配置,是彻底打通操作系统磁盘 IO 瓶颈、释放现代 NVMe 硬件极致并发性能的最强利刃。
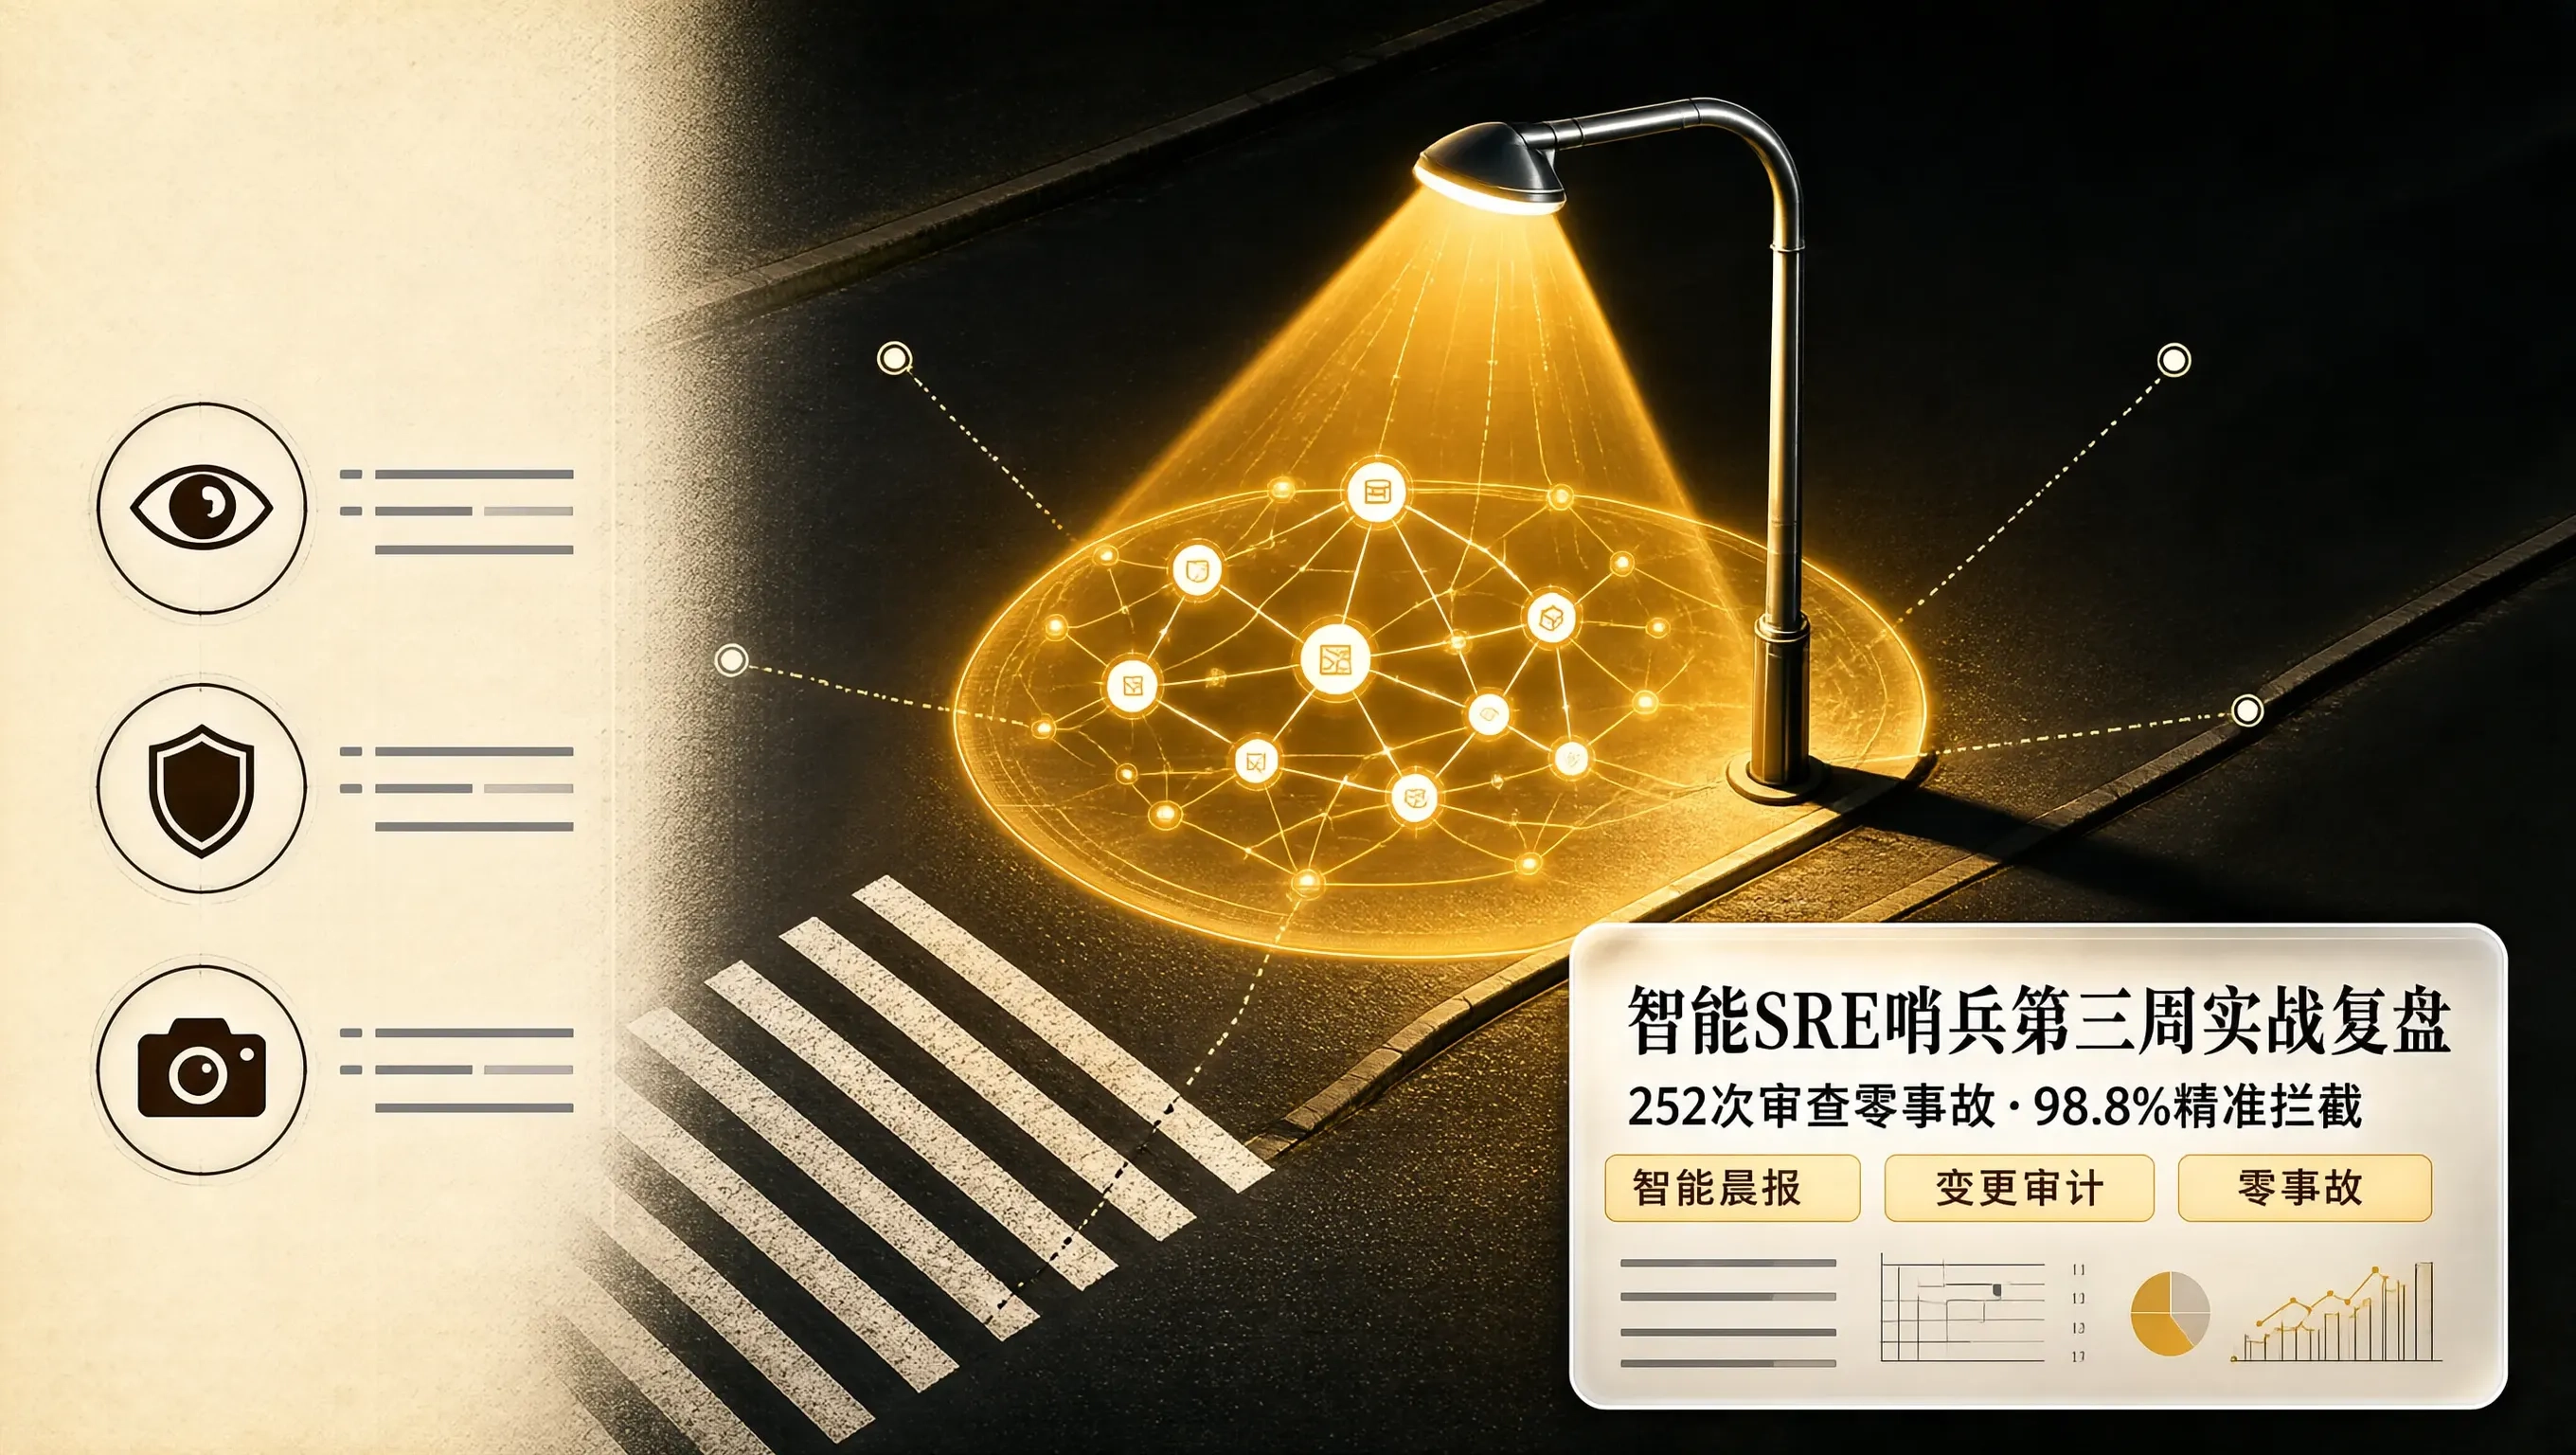
第三周的实战洗礼,让 LLM 运维助手彻底从一个“玩具型的聊天机器人”蜕变为了一个**“守纪律、懂业务、具备刚性风控与温情答疑能力的智能 SRE 哨兵”。进入第四周(W4)后,我们将正式启动“国庆大促封网值班助手最高战备模式”**:全面开启 24 小时代码冻结硬拦截、紧急 Hotfix 双人审批卡片流以及大促夜班秒级体检,以最坚固的数字防线护航全站大促平稳运行!
生产排障绝不是表面的“重启与碰运气”。深入掌握 Linux 操作系统内核协议栈、进程生命周期与 Kubernetes 控制面状态机的底层协同机理,我们彻底清除了全集群底层的四大暗礁,为大促洪峰构建了一条畅通无阻、坚不可摧的云原生高速公路!
在 9 月第三周的“分布式存储架构(T2)”专栏中,我们将研究重点全面跃升到了。ConfChangesplice()复盘这一周的架构演进,现代高可用分布式存储底座的设计基石可以凝练为。
在大促技术保障作战指挥室(War Room)里,每当监控大盘亮起刺眼的红灯时,时间就是以秒来计费的。假设 1:可能是跨机房专线发生了毫秒级丢包;假设 2:可能是某张大表正在执行未建索引的全表扫描;假设 3:可能是垃圾回收(GC)引发了长达 1 秒的 STW 停顿;假设 4:可能是连接池最大连接数打满导致排队;假设 5:可能是底层物理 SSD 控制器触发了垃圾回收(GC Stall)。如果值班工程师
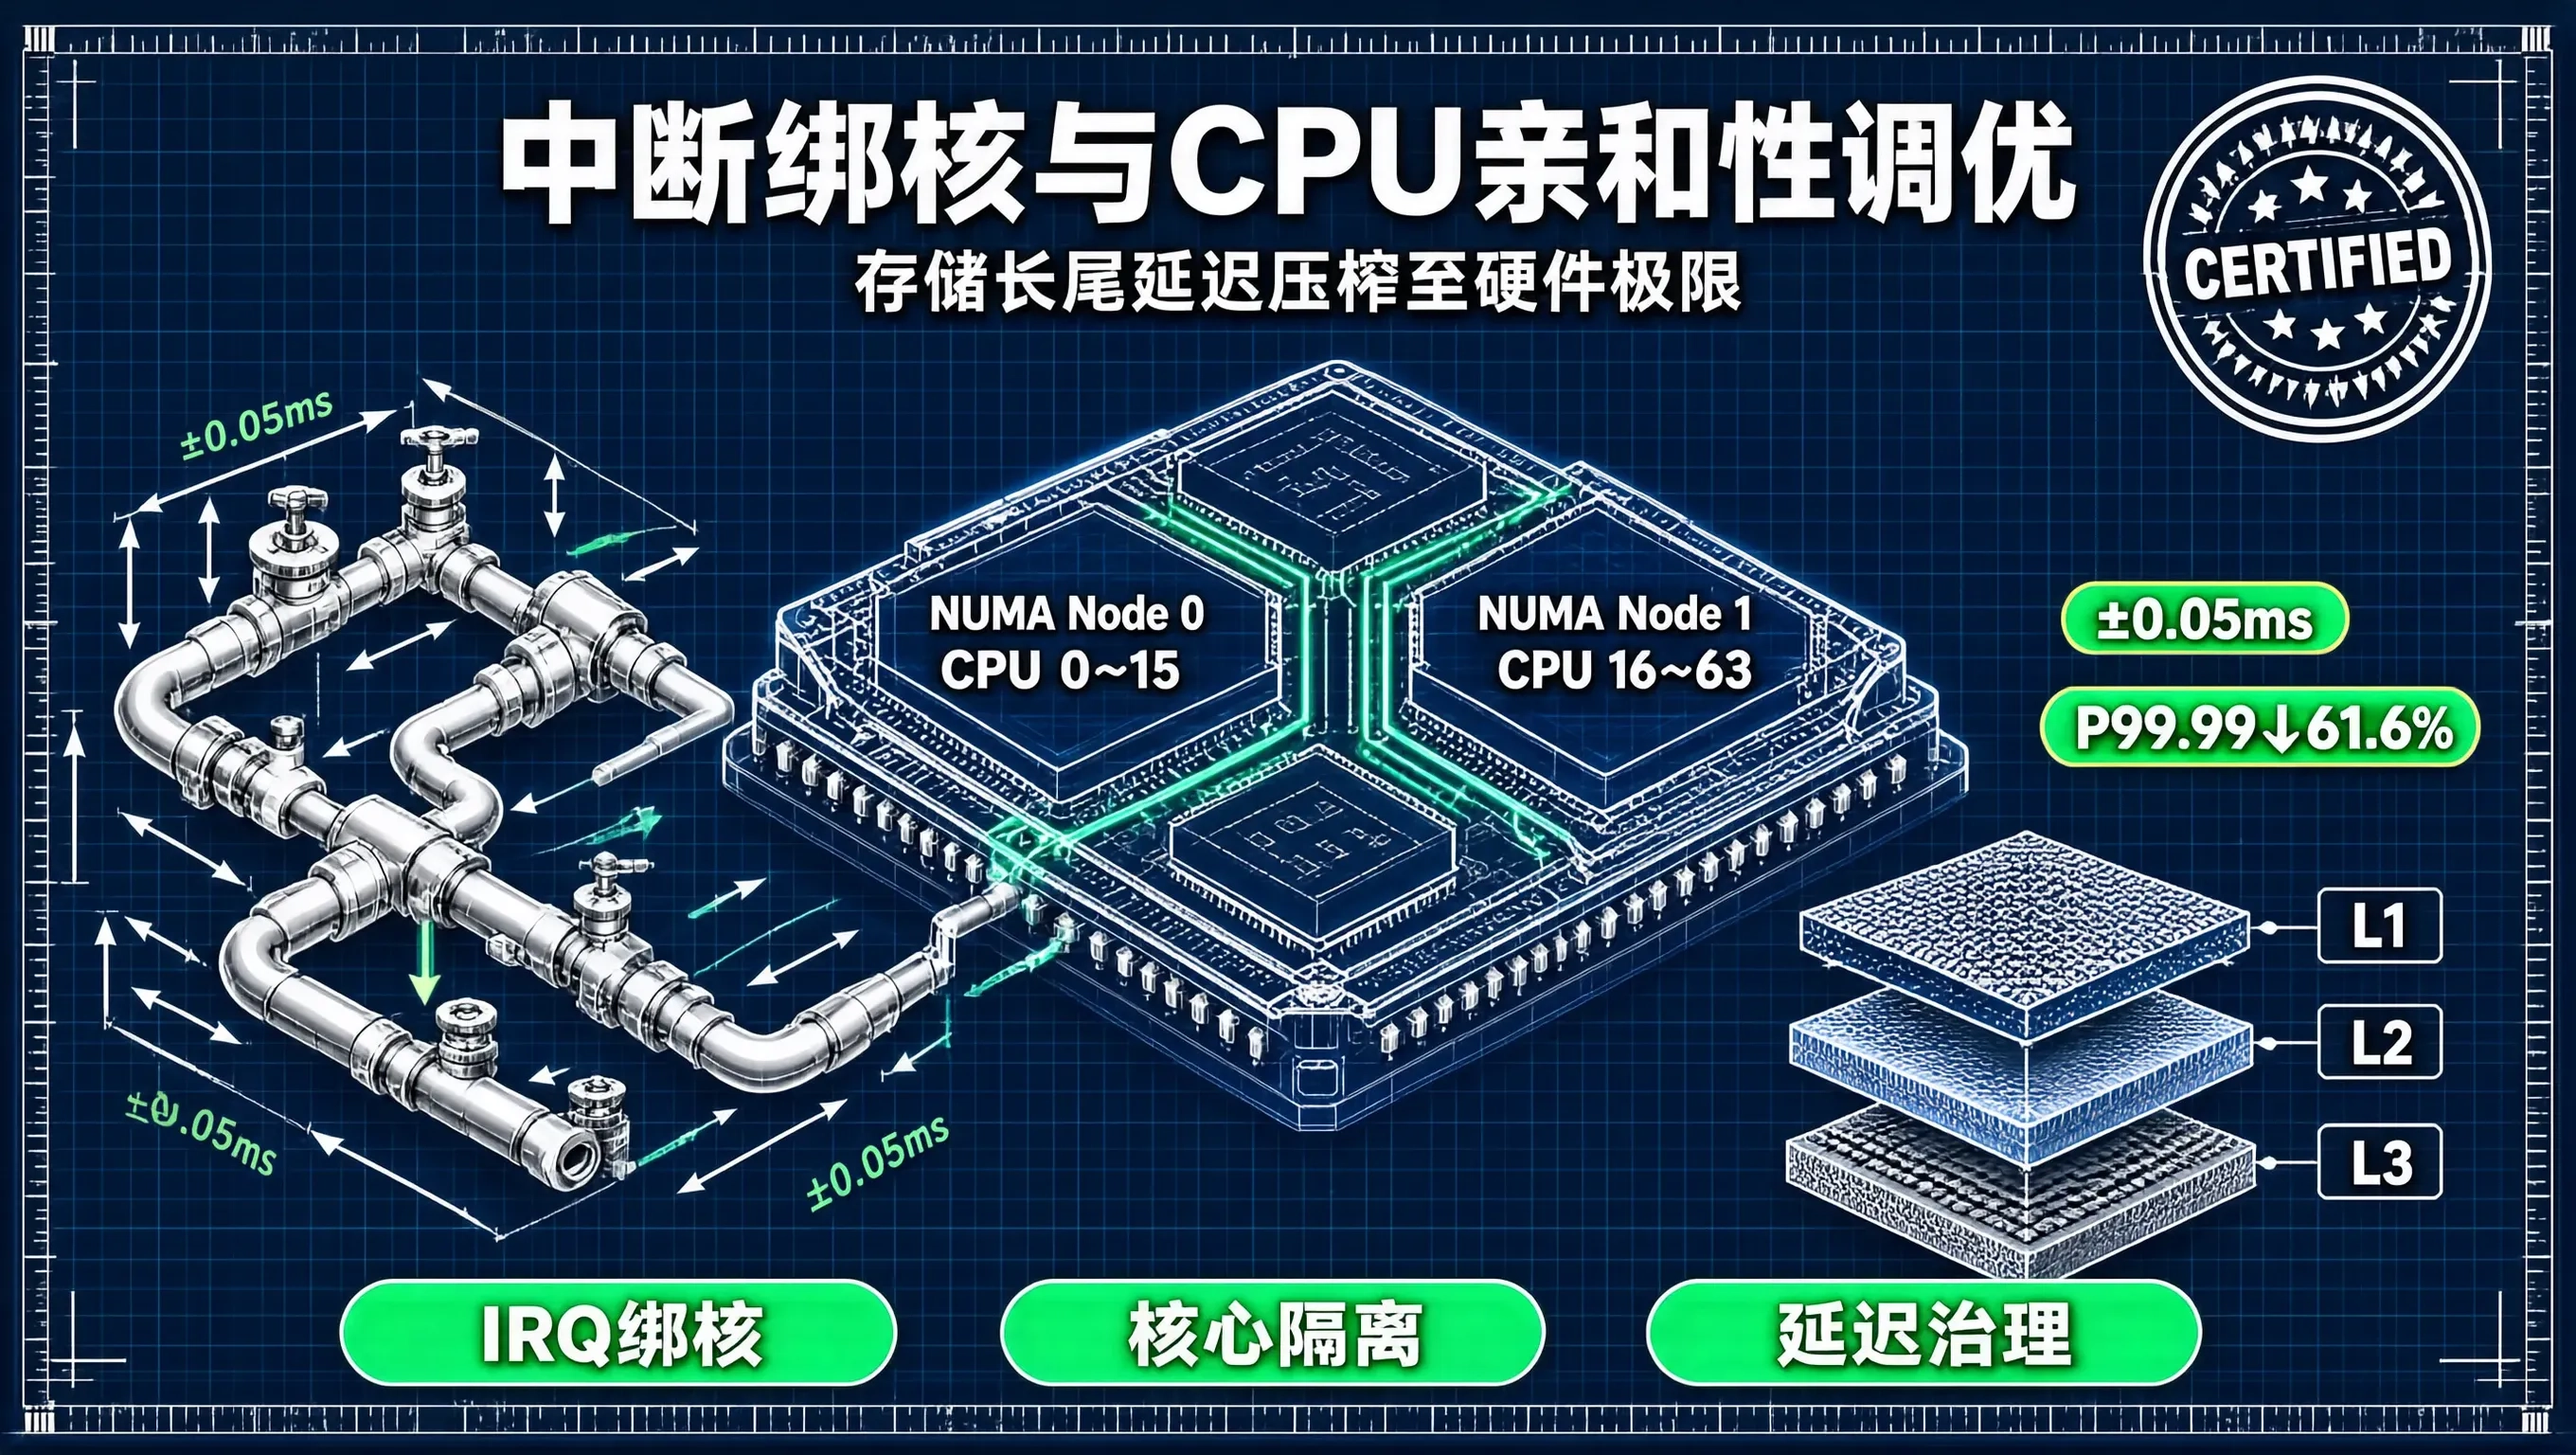
从数据库参数、SQL 优化,一路深潜至操作系统内核的中断向量表与 CPU 亲和性掩码,把每一行代码与每一片物理硅晶圆的潜能压榨到极致。这是存储专家在稳定性深水区所展现出的终极工匠精神。
本文介绍在openEuler系统上部署Kubernetes外部etcd集群的完整流程,包括基础环境配置、二进制安装etcd、systemd服务管理及TLS加密通信配置。重点阐述使用cfssl工具生成CA证书及服务器、客户端、对等节点证书,实现etcd集群间安全通信,确保生产环境安全性。
本文详解Kubernetes命令式对象配置,通过YAML文件管理资源。相较于直接在命令中指定参数,使用YAML可清晰定义Namespace、Pod等资源,包含apiVersion、kind、metadata及spec等核心字段。YAML支持多资源定义(以---分隔),便于维护与复用。通过kubectl create -f命令,实现资源的高效创建与管理,提升复杂配置的可读性与可维护性。
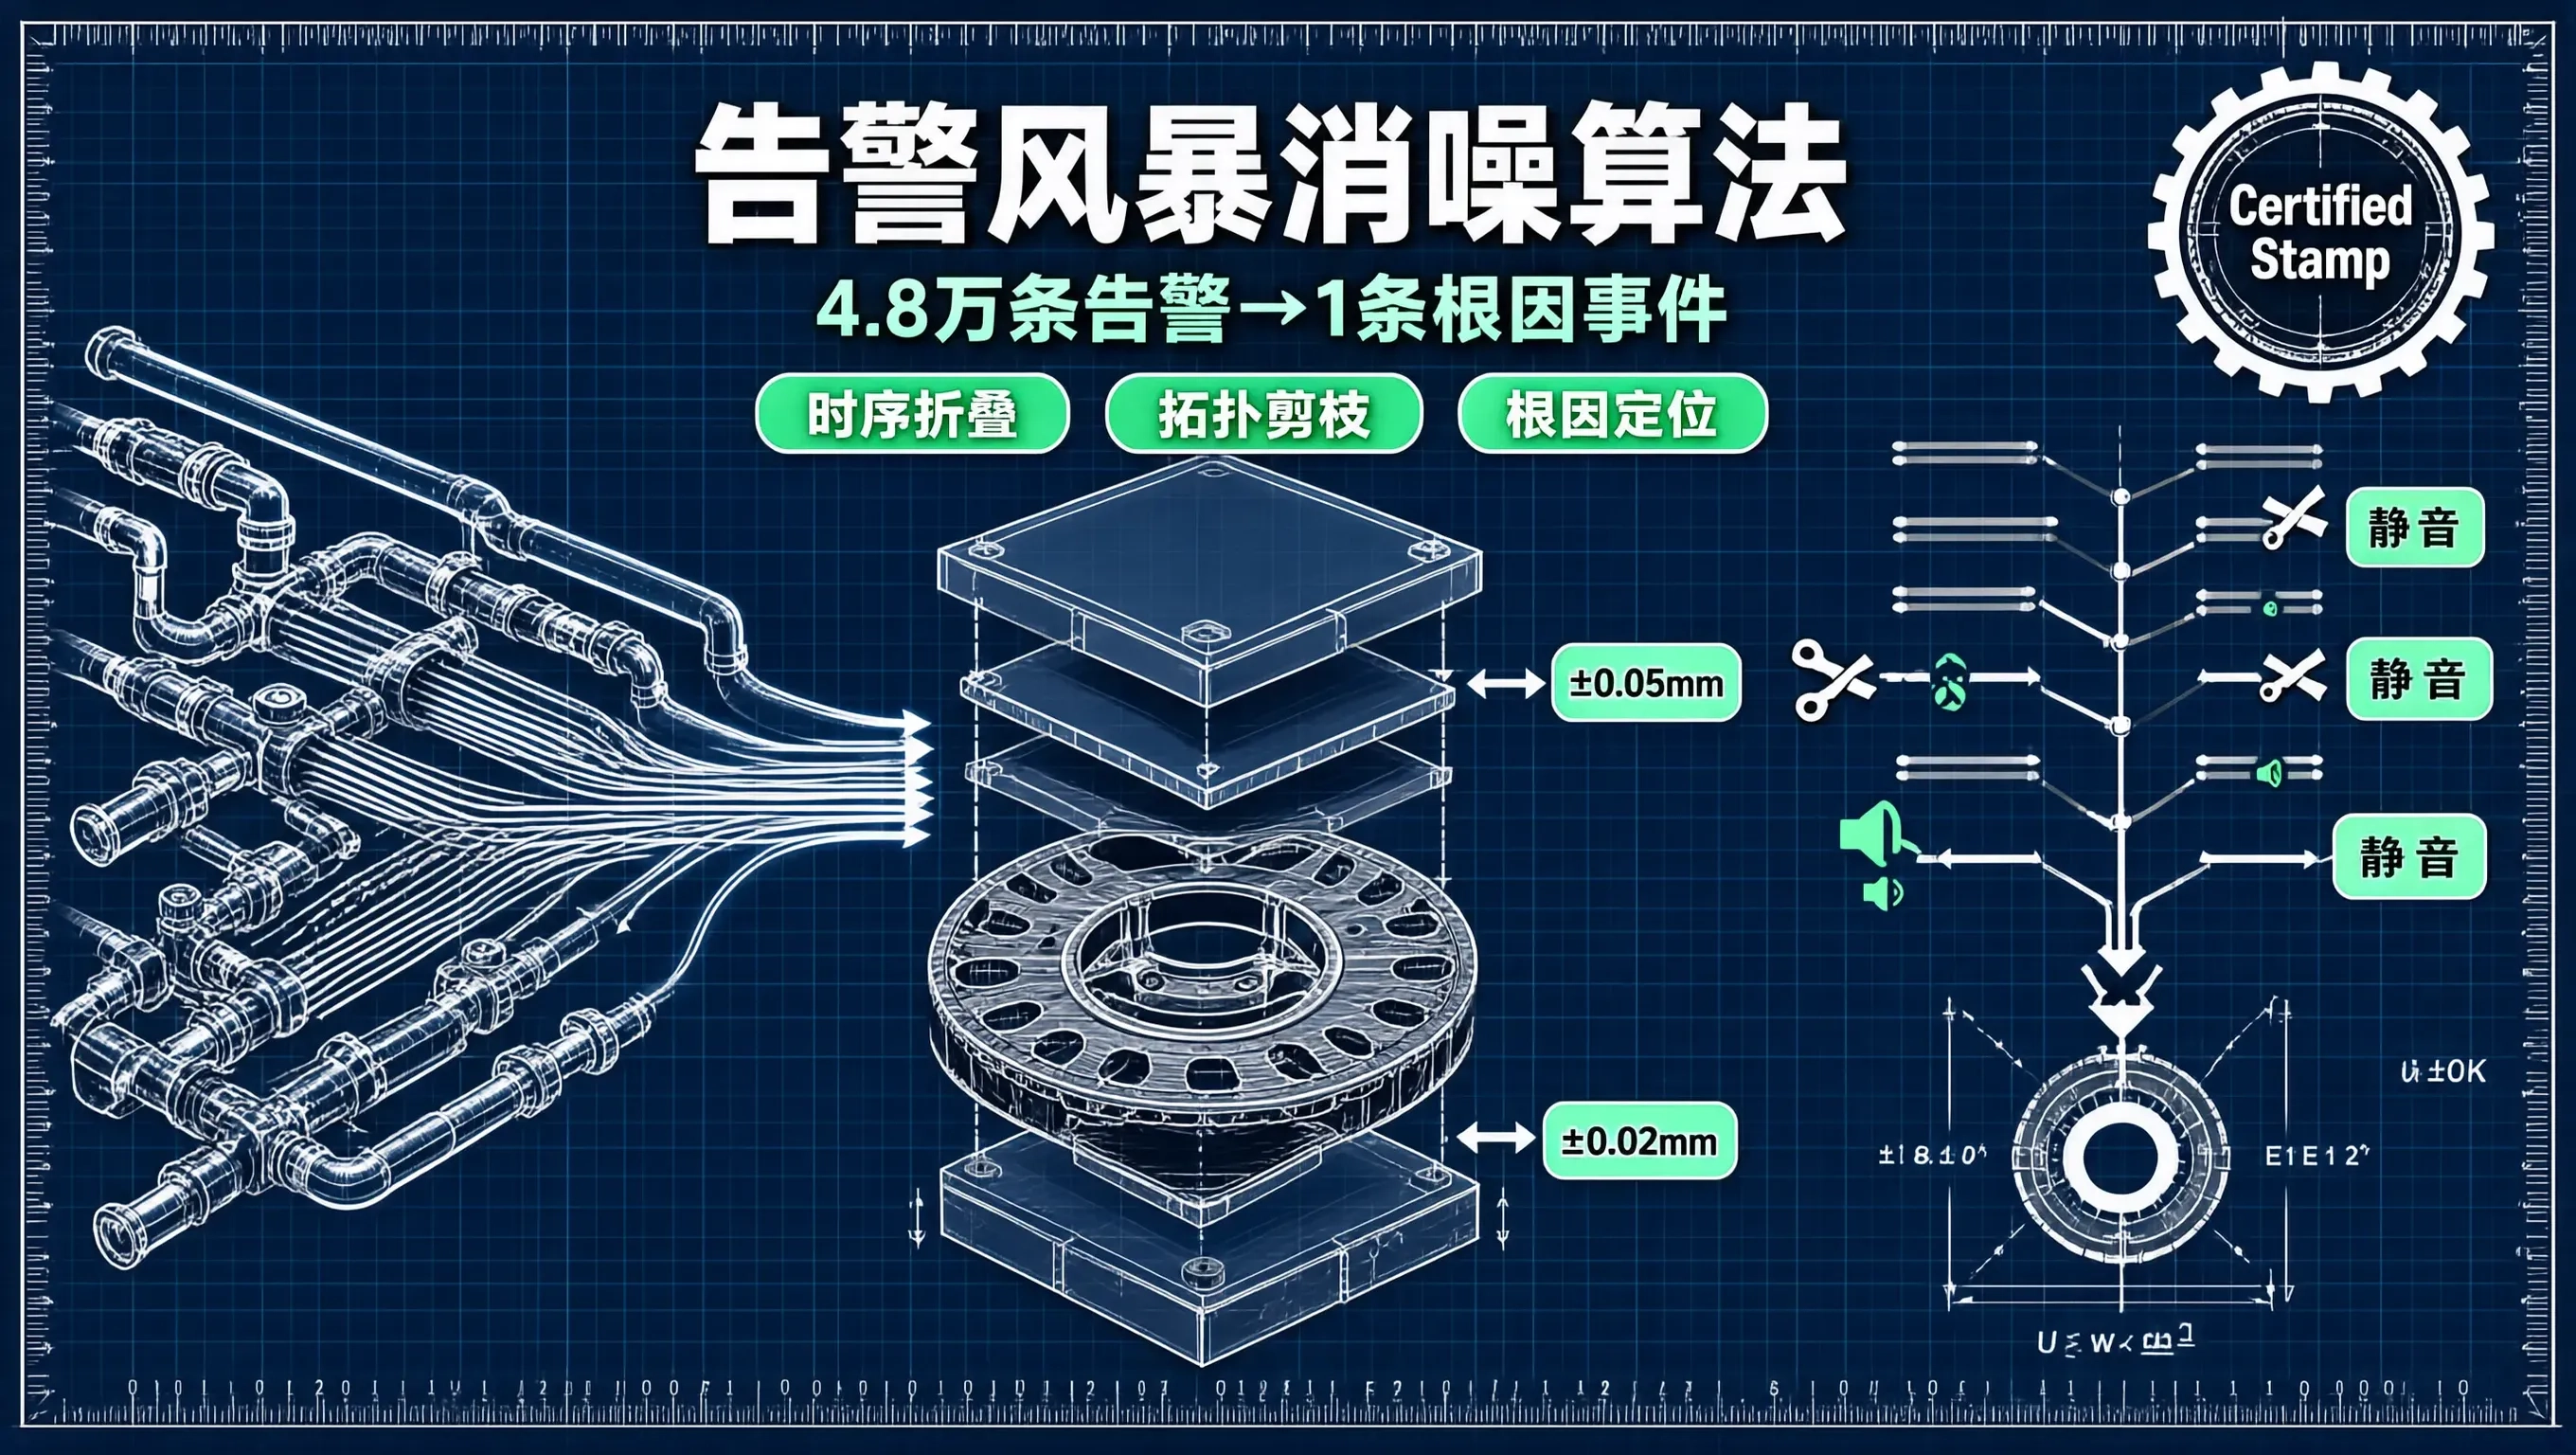
每年大促开售前后的核心保障期,技术作战指挥室(War Room)里最让人神经衰弱的噪音,莫过于监控大盘与值班手机上疯狂响起的报警声。当底层某个核心存储分片由于网络闪断发生主从切换时,在接下来的如何设计一套,在毫秒级时间内将 50,000 条告警噪音精准提炼为 1 条高置信度的根因事件?
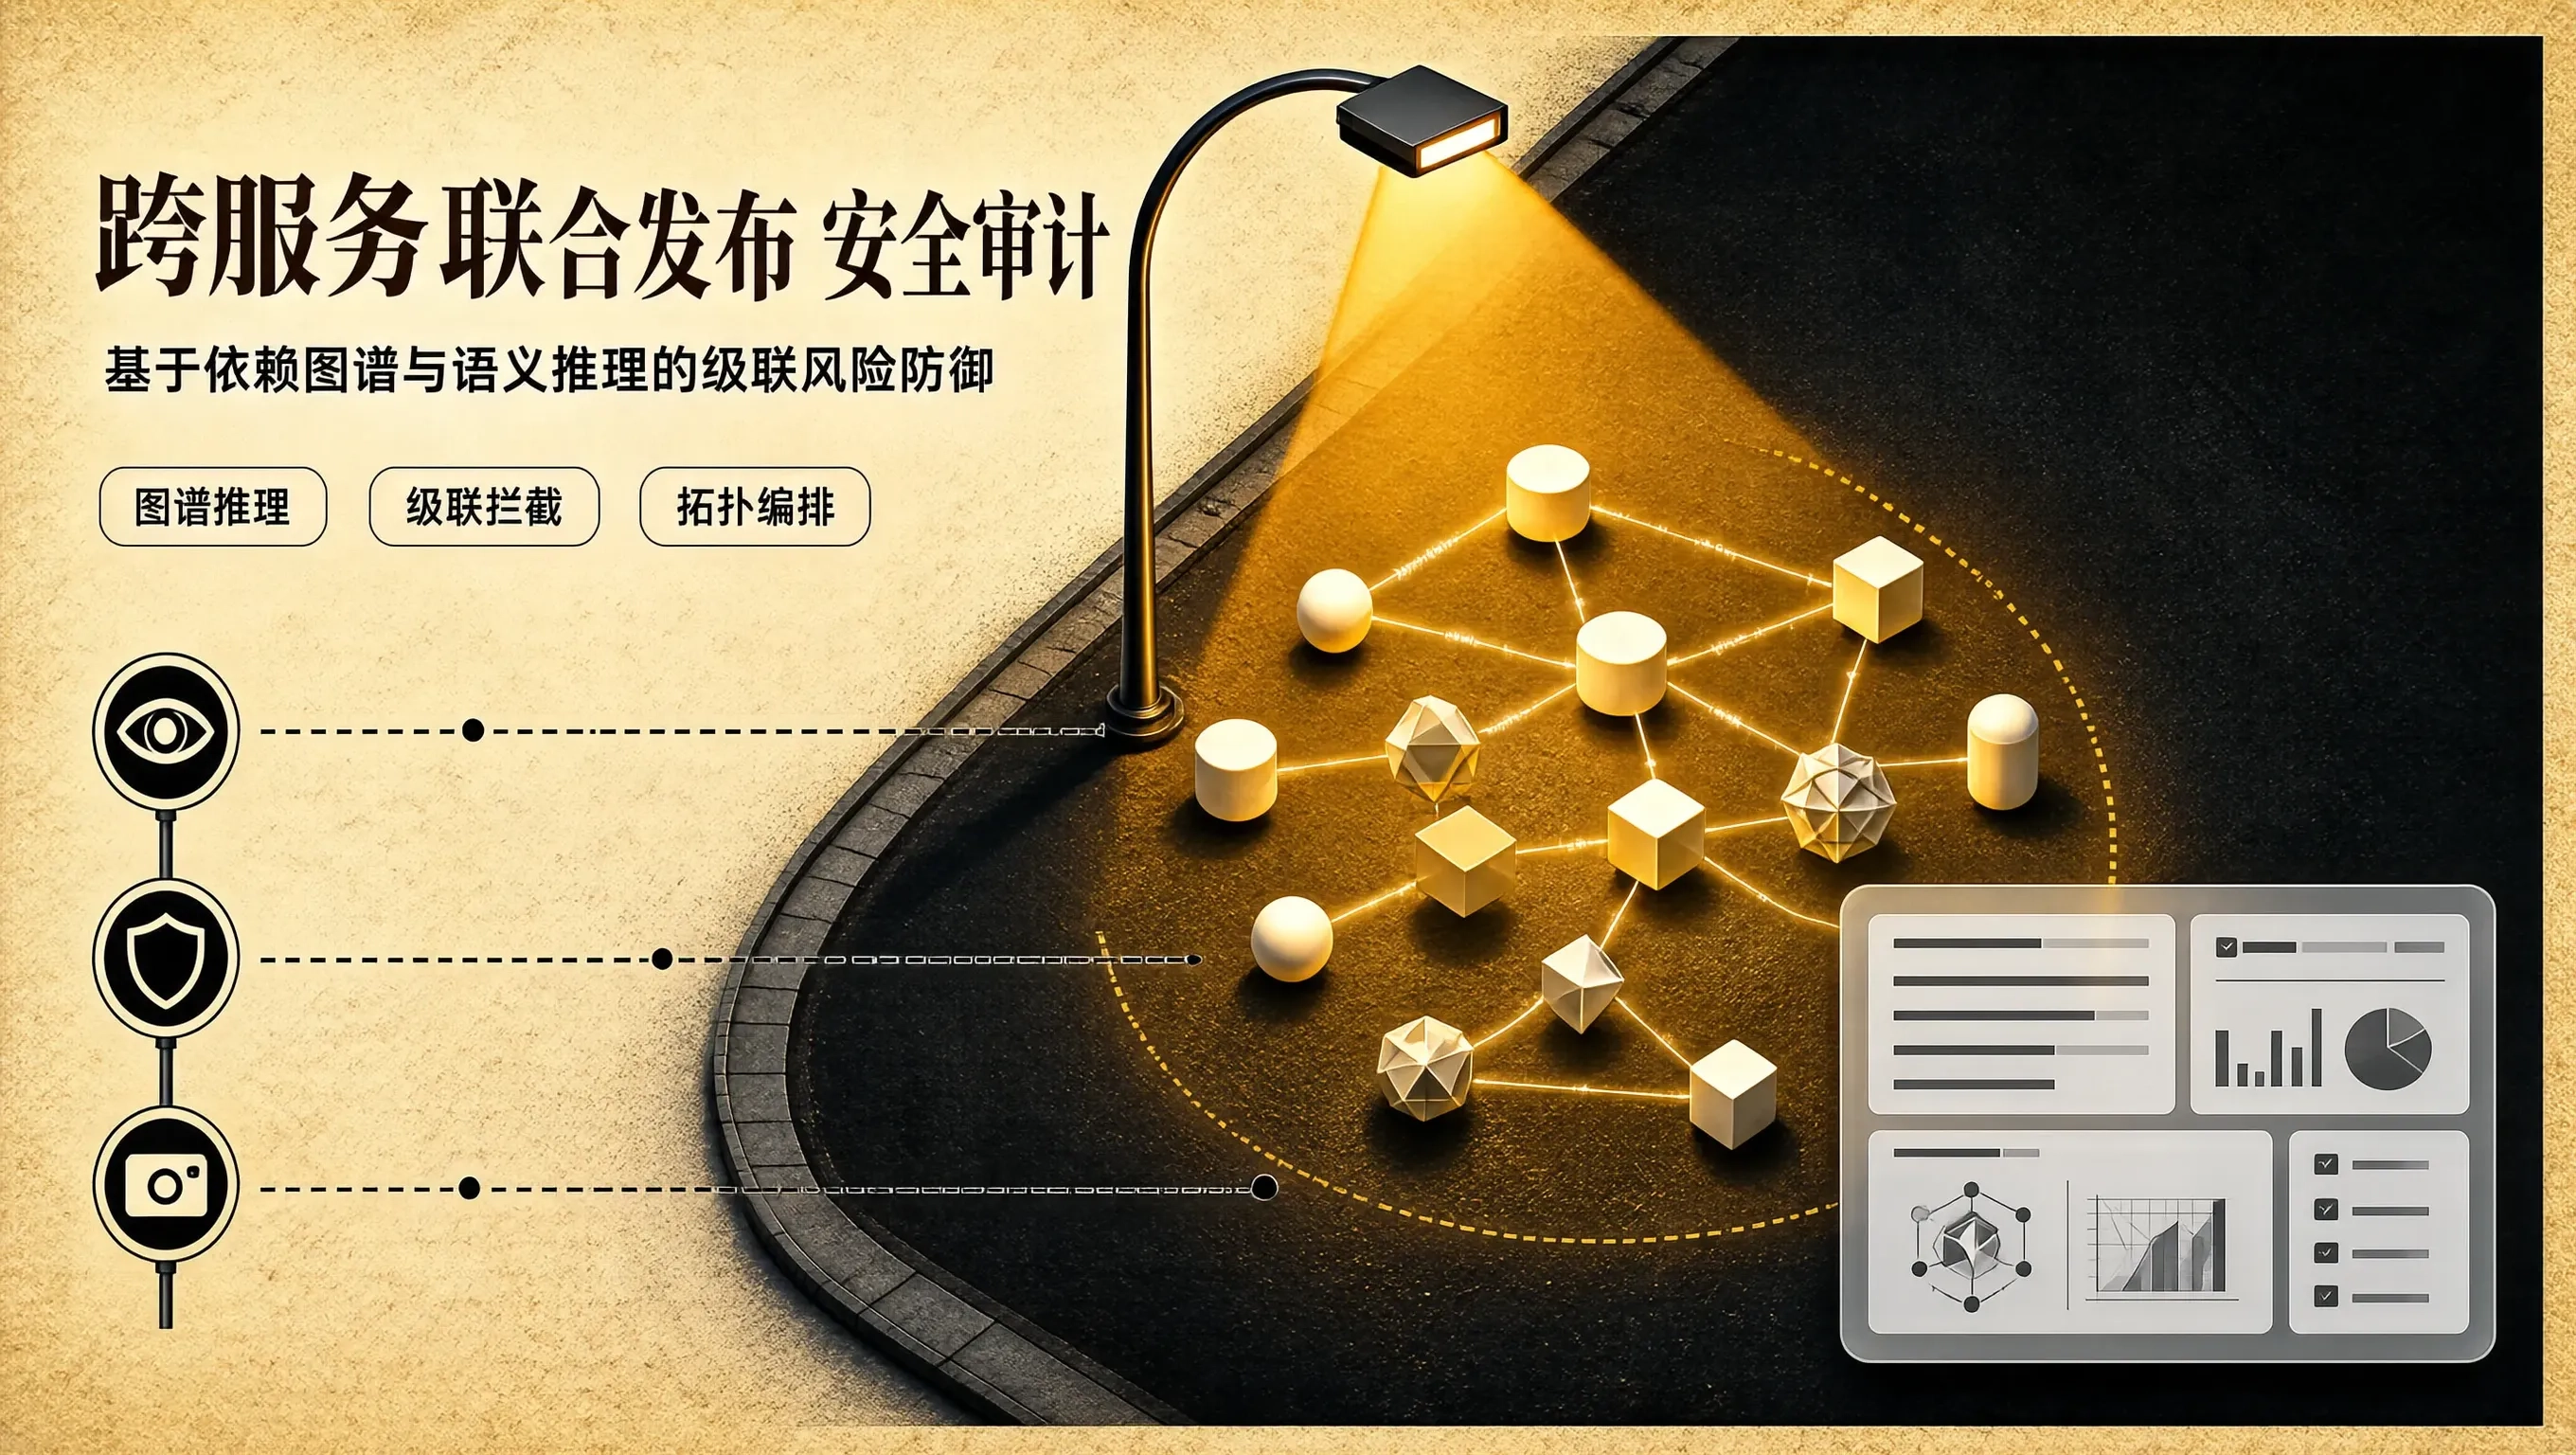
在企业级微服务持续交付的深水区,生产变更往往不再是孤立的“单微服务、单 YAML 文件”的独立修改,而是演变为了极其复杂的**“多微服务跨系统联合发布(Cross-Service Coordinated Releases)”**:user_levelvip_tier在面对这种复杂的跨系统联合变更时,传统的单文件静态代码检查(如单纯的 YAML Linter 或 SonarQube)彻底丧失了防御能
在将大语言模型(LLM)与检索增强生成(Retrieval-Augmented Generation, RAG)应用于生产故障应急排查(Incident Response)时,很多团队最初普遍采用**纯文本切片与稠密向量检索(Dense Vector RAG)**的方案:把公司几十份 Wiki 故障处理预案(Runbooks)切成 500 字的文本块,存入 Milvus 或 Chroma 向量数据
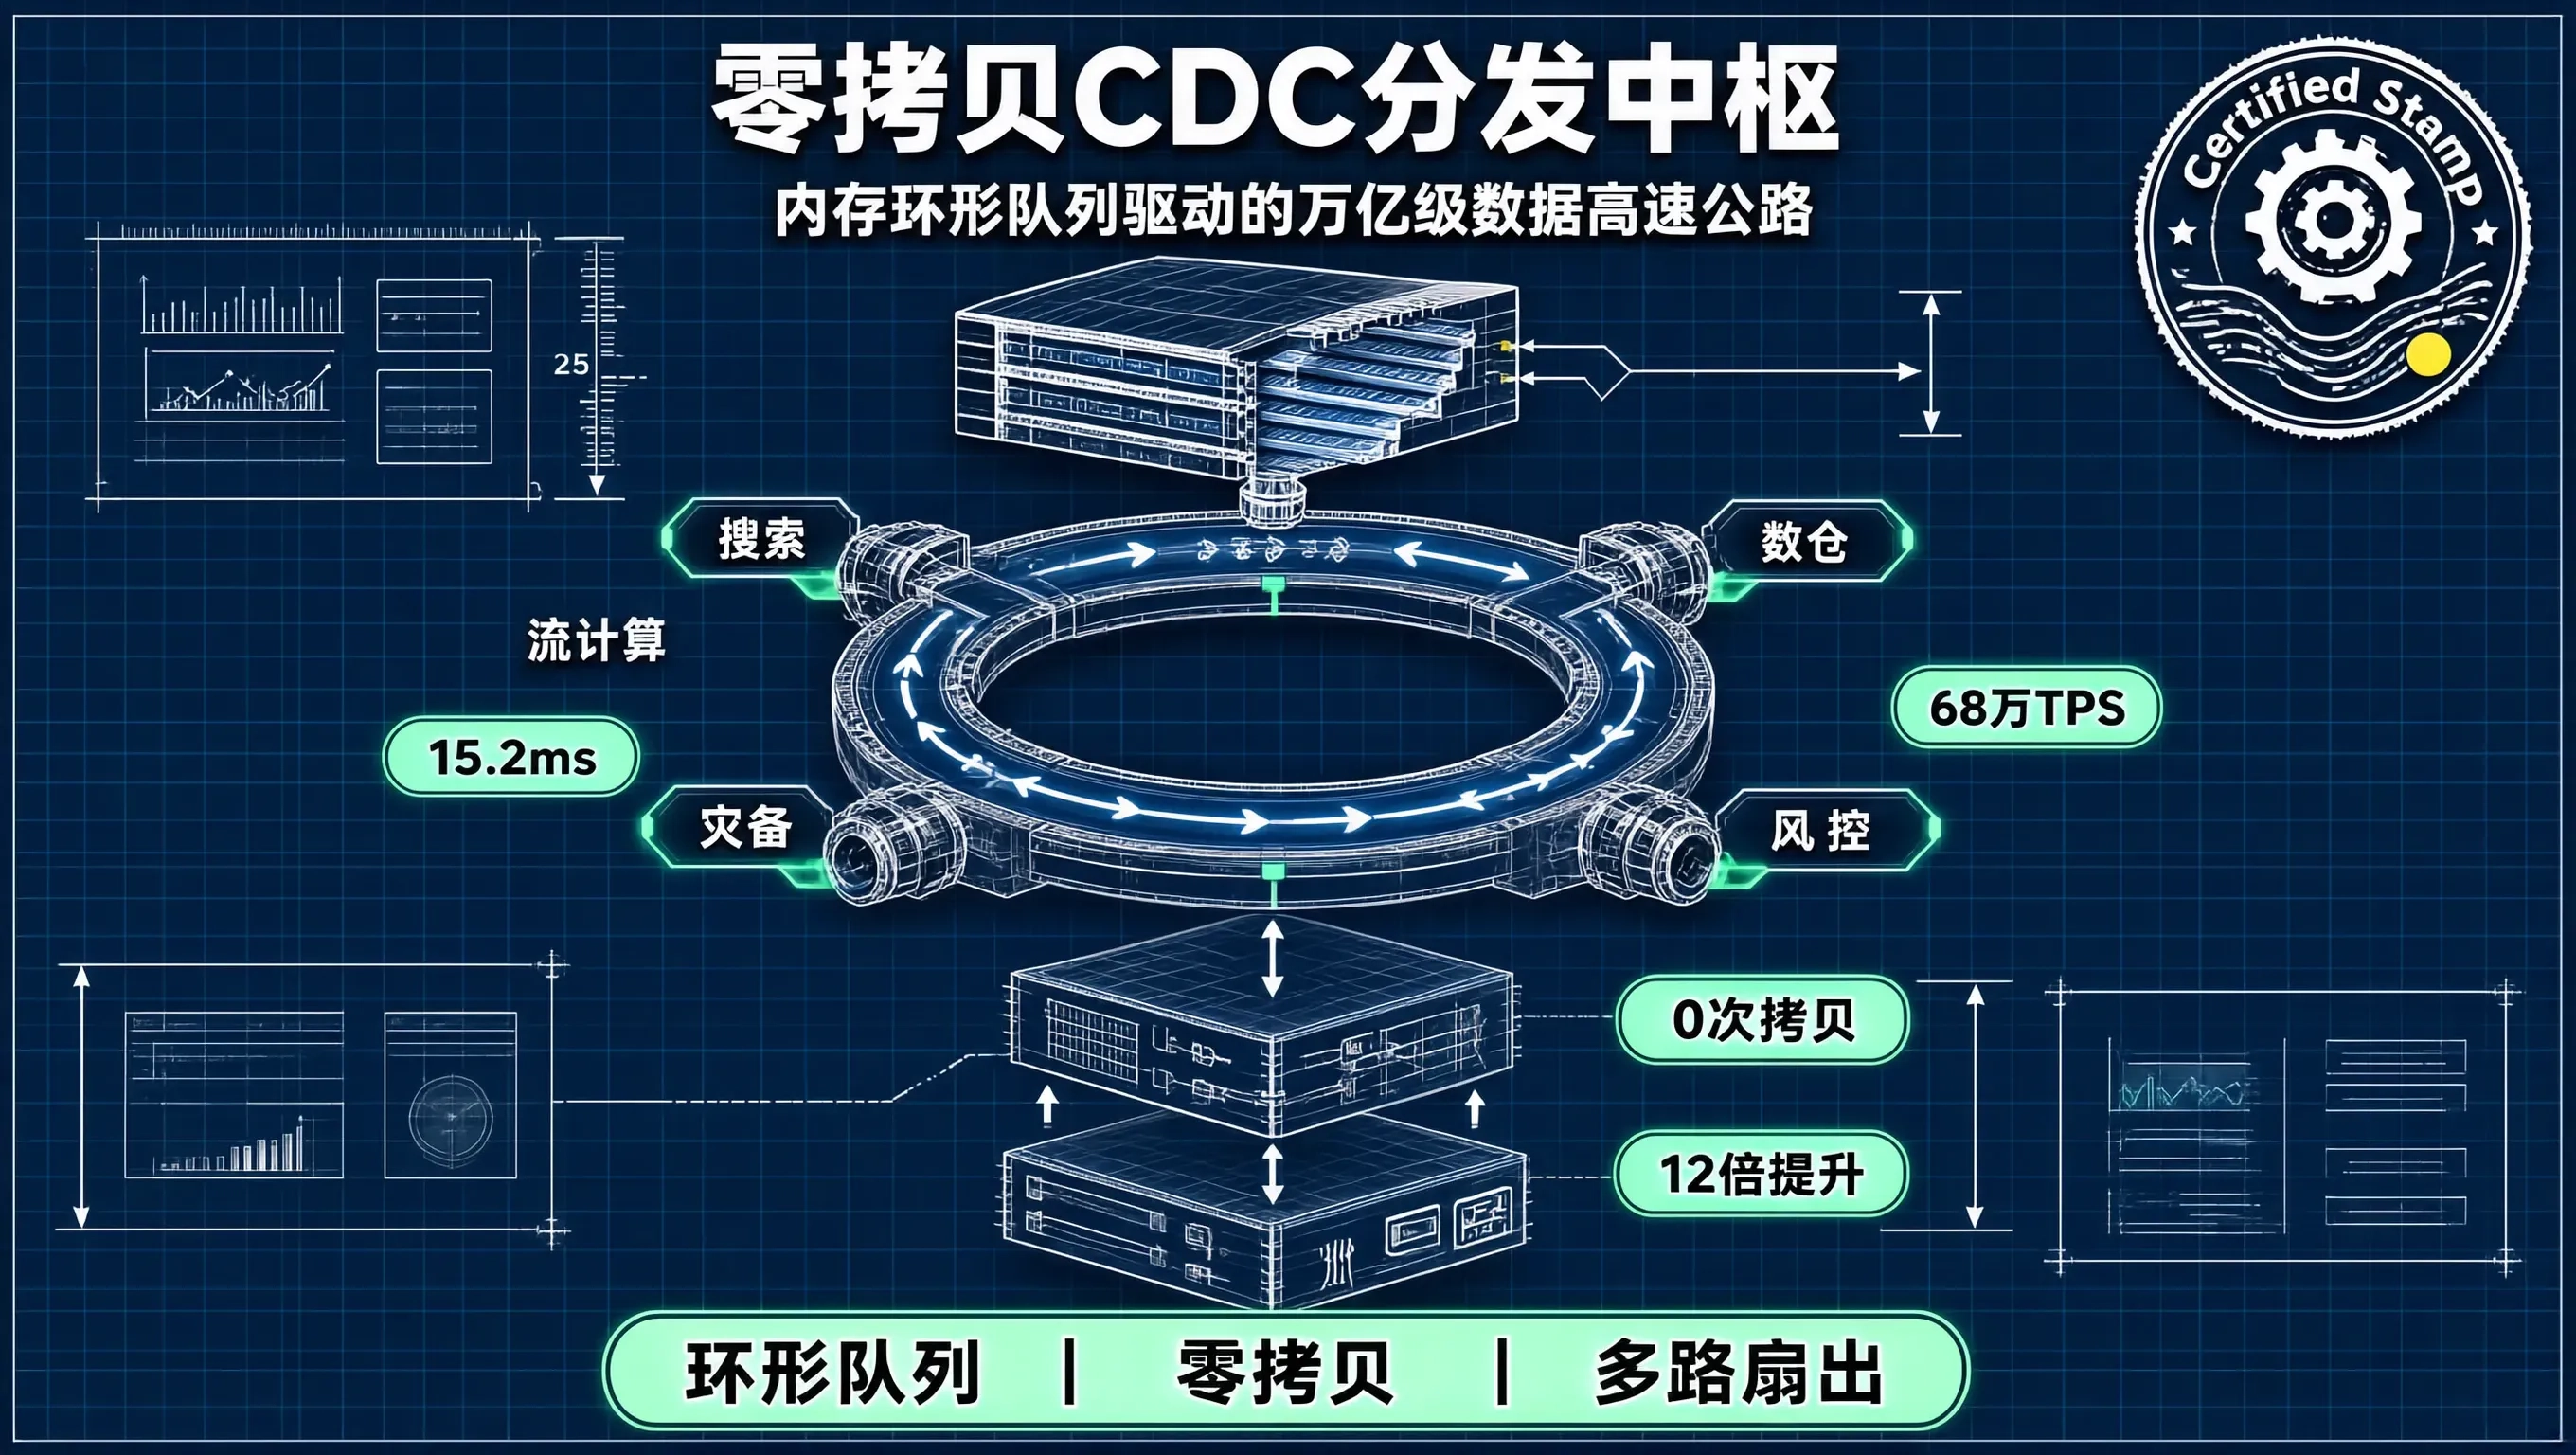
让数据在最底层的内存指针与操作系统内核空间中以零拷贝的方式极速流转,这是构建万亿级现代分布式数据高速公路的最高工程准则。
Linux 内存 Overcommit 机制深刻体现了操作系统在“极致吞吐效率”与“严格确定性安全”之间的哲学取舍。精准理解 0、1、2 三种模式的物理本质,针对 Redis 专用节点坚决开启消除 fork 死锁、针对通用集群推行 cgroup 硬配额约束,我们为全站各种不同计算形态的工作负载构筑了最契合、最稳固的内核内存运行环境。
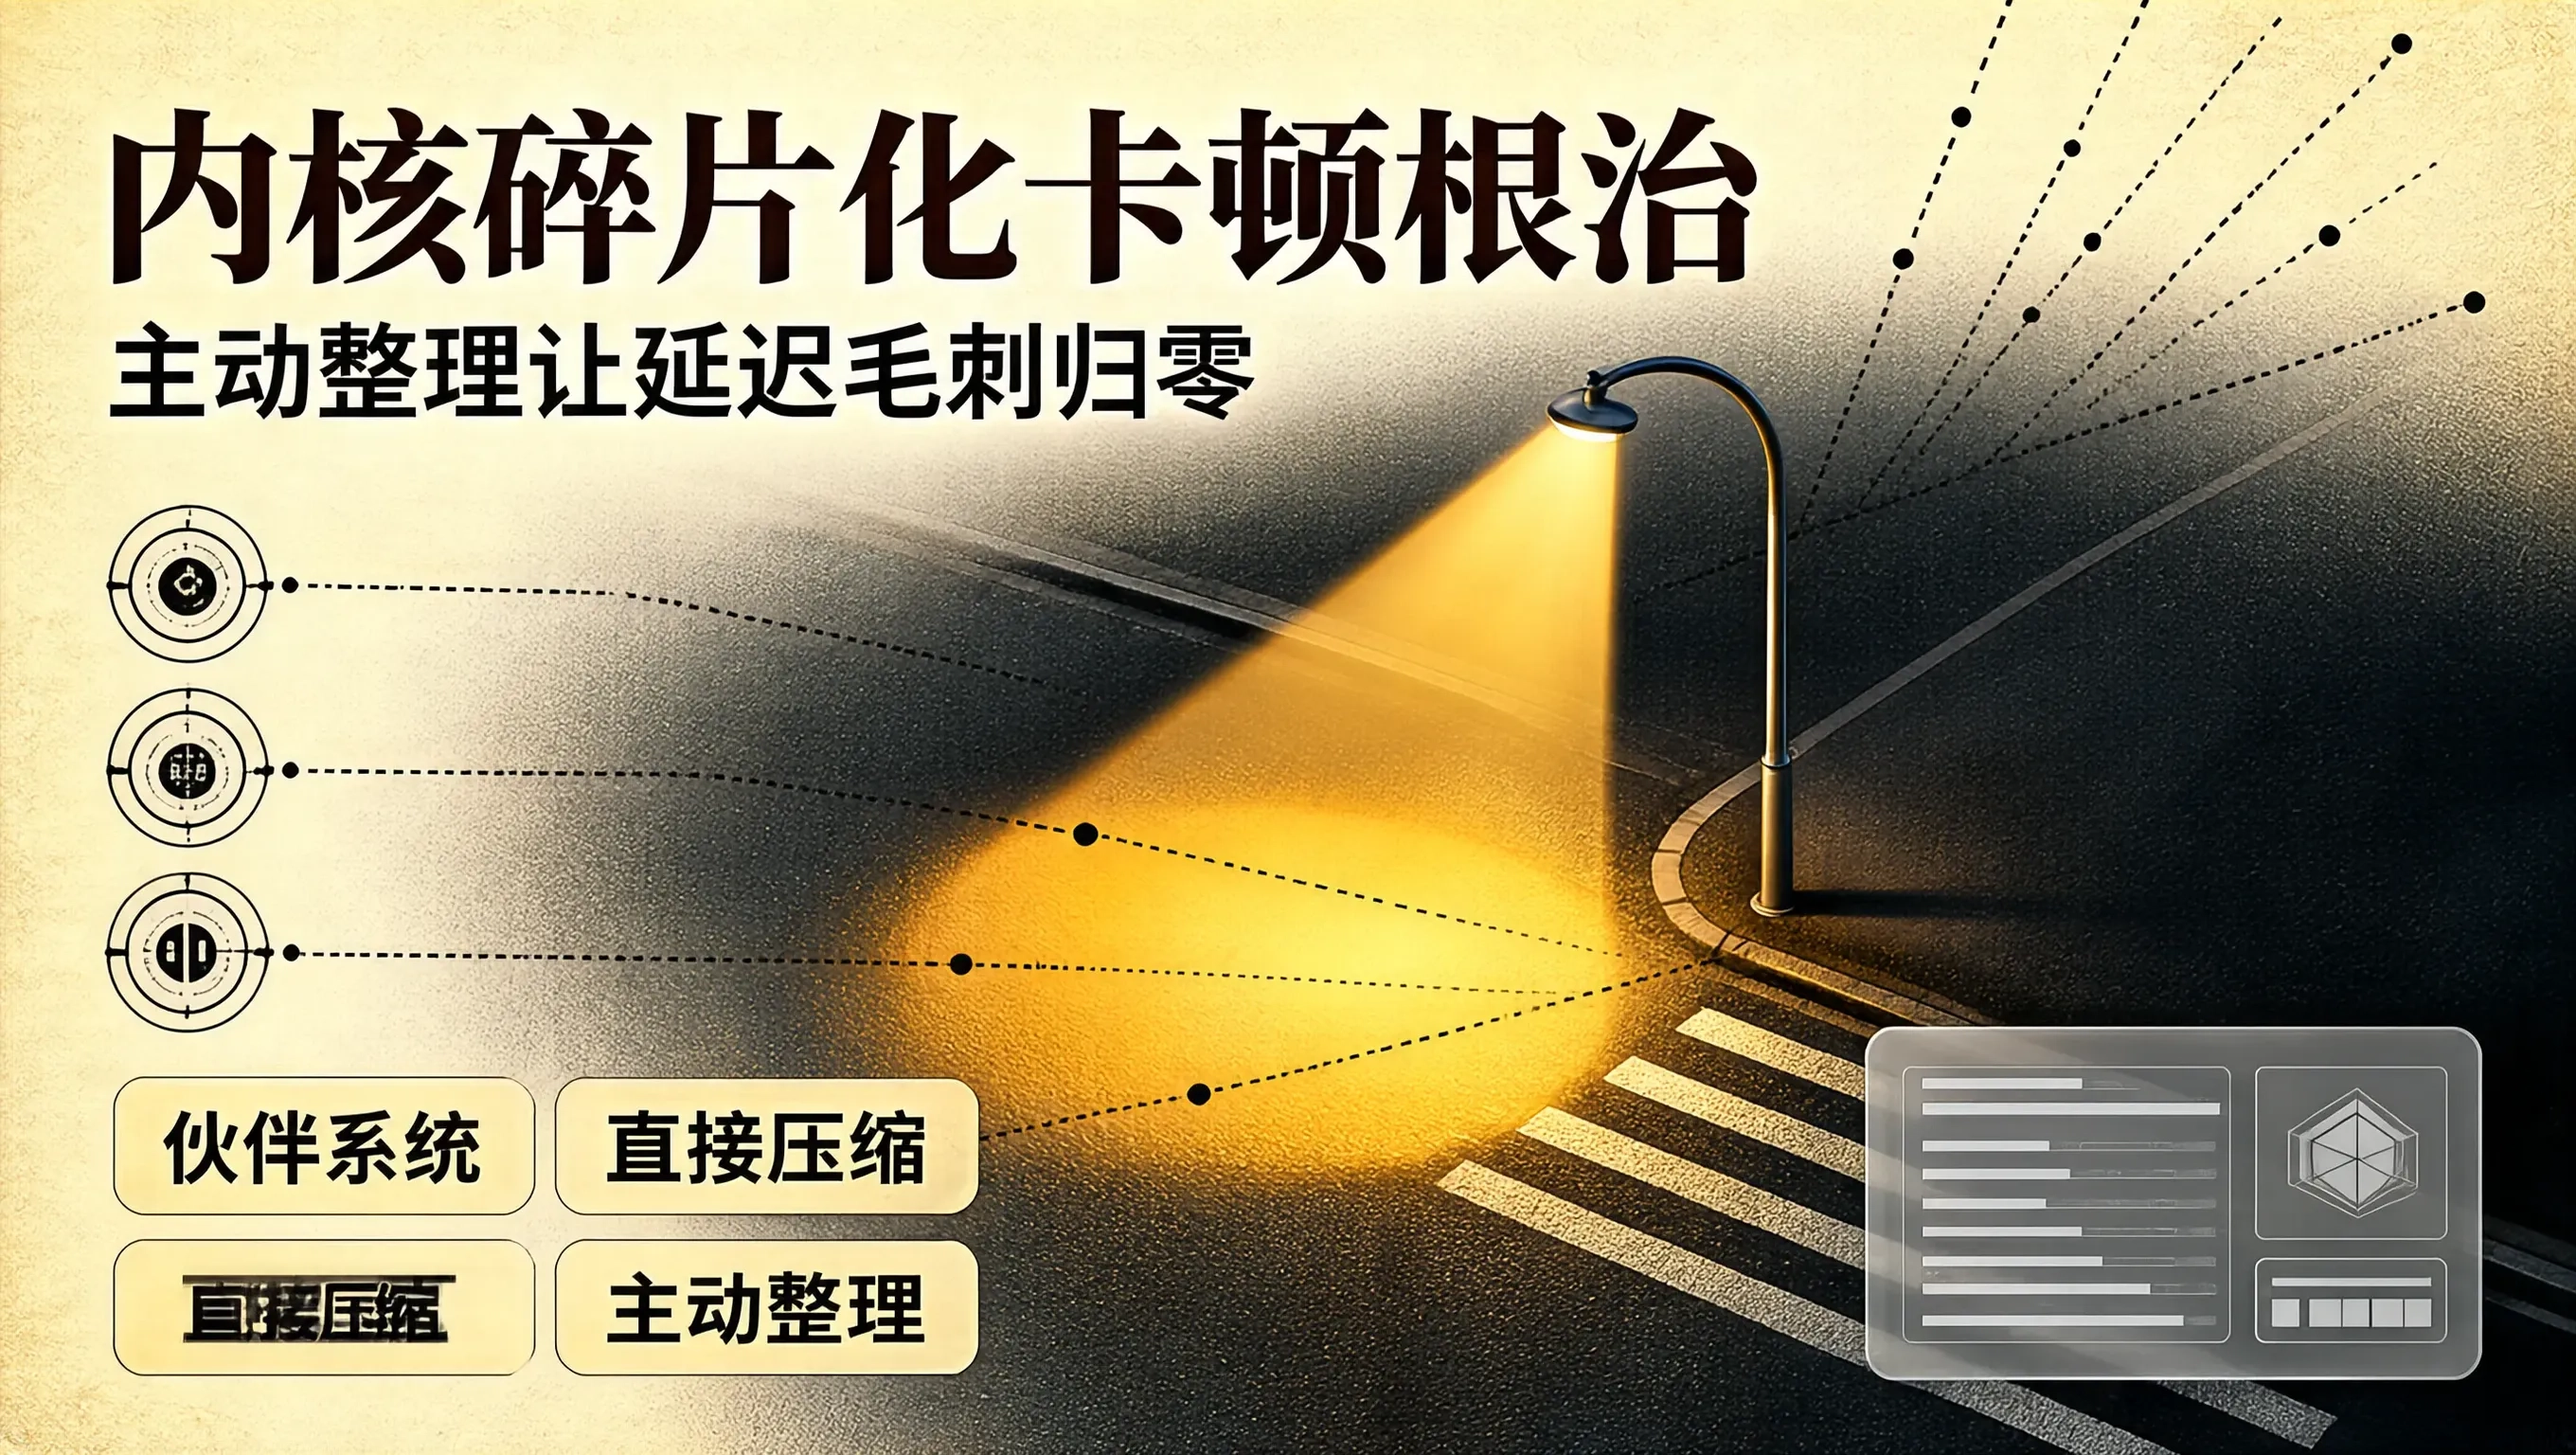
在 Linux 操作系统的通用存储栈中,是决定磁盘读写请求如何排序、合并并下发给底层硬件控制器的核心交通警察。然而,在现代数据中心全面普及的今天:如果操作系统依然使用传统的通用调度器,这套原本为了机械硬盘设计的排序逻辑,反而会蜕变为在 Linux 6.x 内核下,两大主流 NVMe 调度器——none与 mq-deadline,在极限高并发数据库负载下究竟表现如何?
在传统的研发流程中,生产变更的审查往往依赖于人肉 Peer Review(同行评审):一个研发提交了一个包含上千行代码和十几份 Kubernetes YAML 的发布 Merge Request(MR);负责审批的 Tech Lead 在疲惫中可能只是粗略扫了一眼标题,顺手点击了Approve。WHERE人肉审查总有疲劳和盲区,但。
free -mfreeavailablenew byte[]malloc在物理内存明明极其宽裕的情况下,为什么操作系统在分配内存时会发生长达整整一秒的“瞬间假死”?本文深入剖析 Linux 内核内存子系统伙伴系统(Buddy System)、的深层机理,并给出生产级。
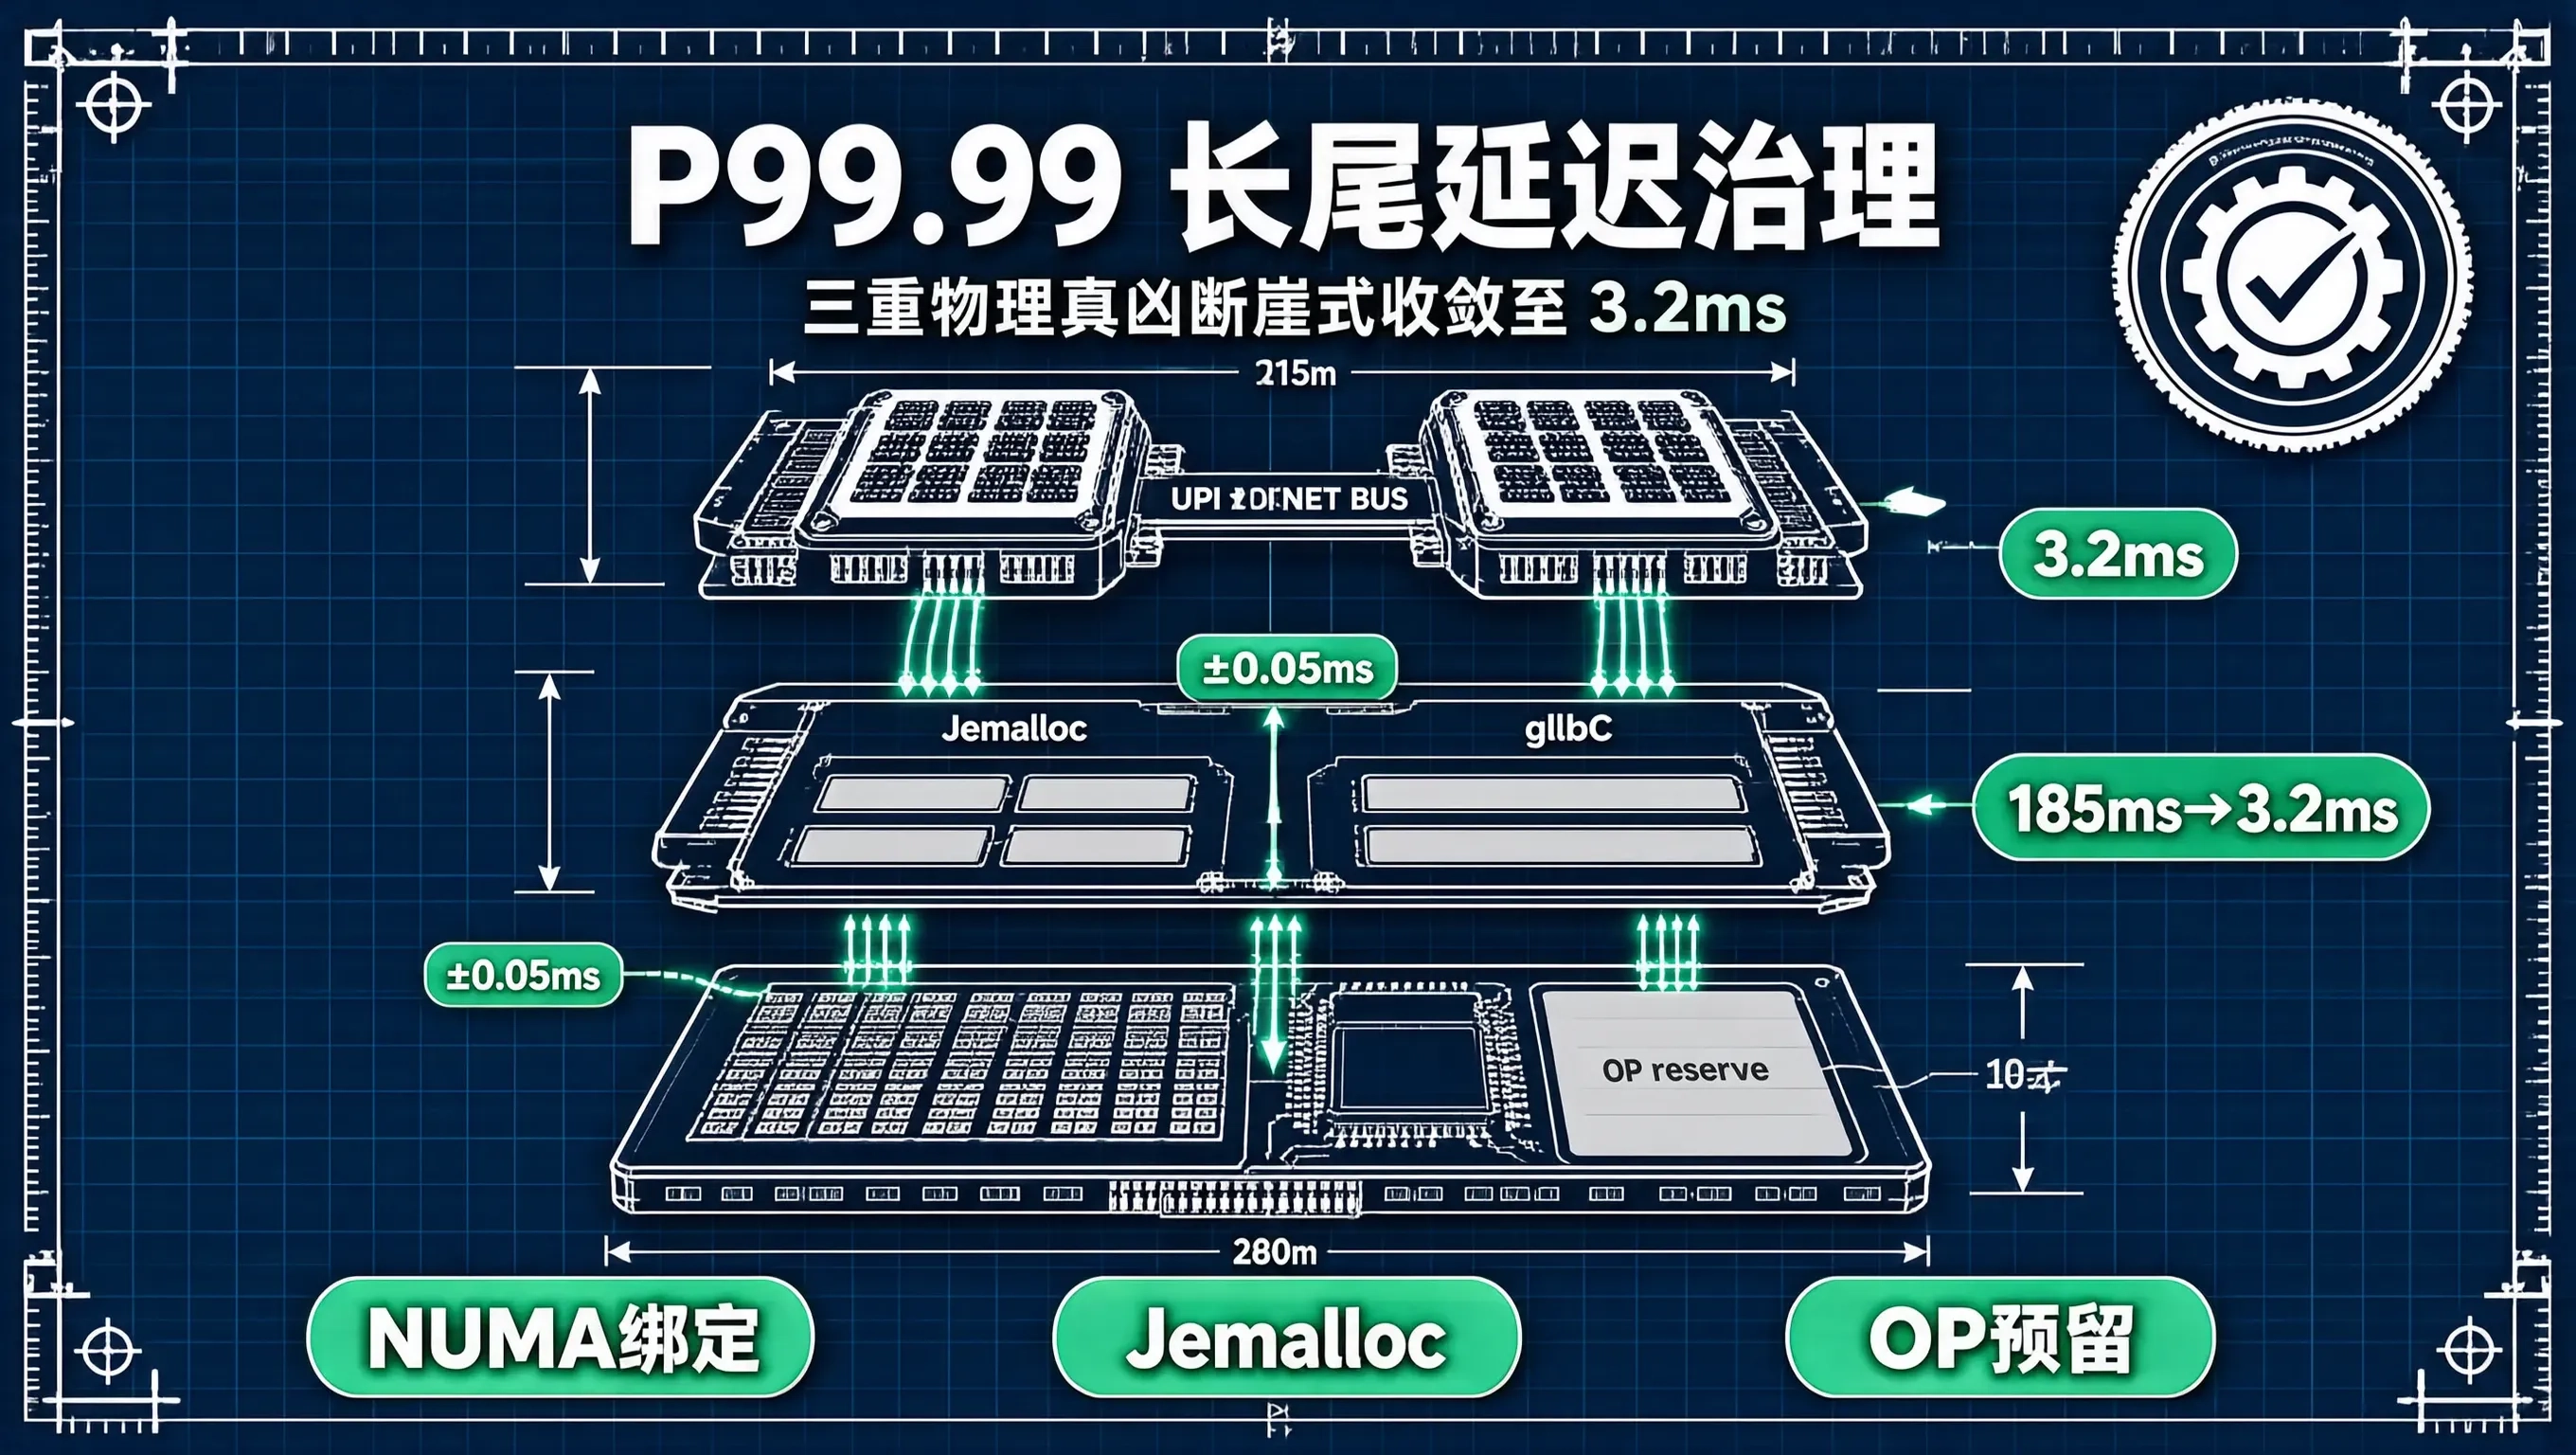
在每秒承载数十万 QPS 的分布式存储底座中,。在大促备战的最终性能攻坚中,我们的目标不再是把平均延迟从 1.2ms 优化到 1.1ms,而是深入计算机体系结构底层,导致存储系统产生极端长尾毛刺的真凶究竟是什么?我们如何从硬件、内核调度与内存微架构层面将其逐一斩杀?
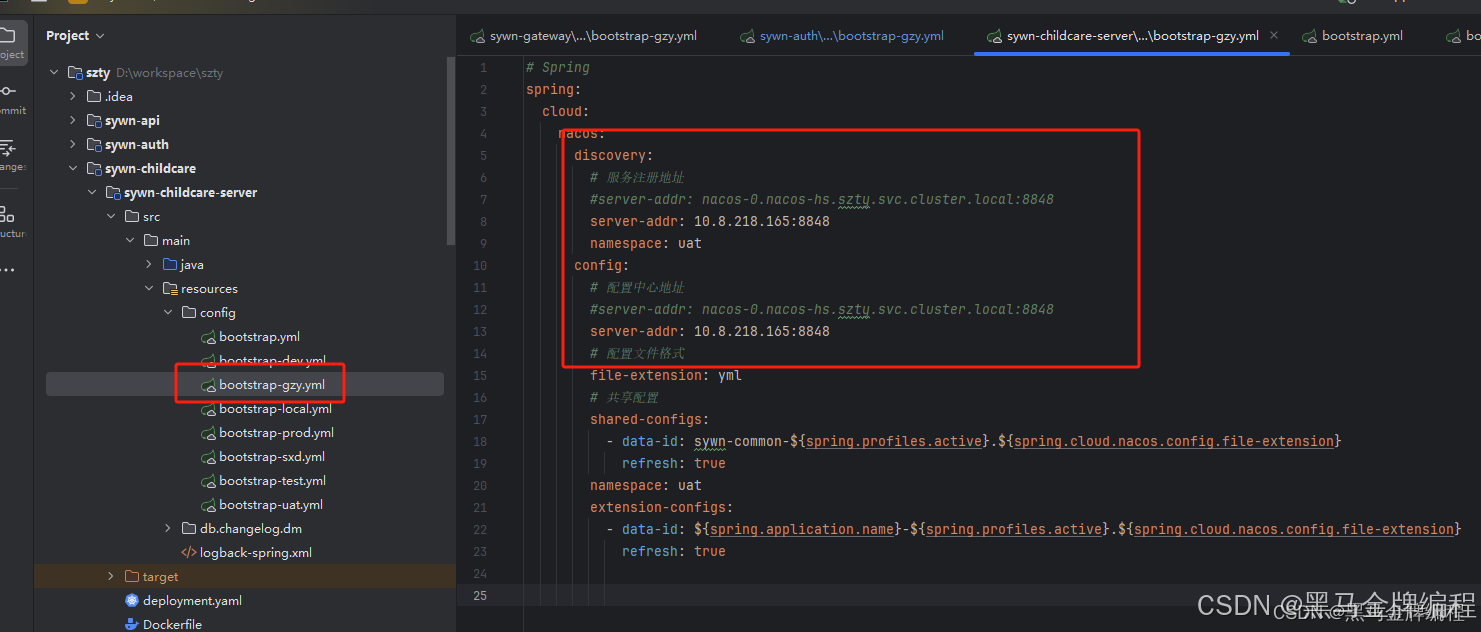
然后我就不想那么多,死马当活马医,继续发布了剩余端口,我重启服务,看着没啥变化,也就没有继续在管,正当我还以为再次失败的时候,过了十几分钟,刷新了nacos服务列表,突然看到有个应用成功注册了。后面想想,问了群里某个大佬,无意间的一句话被他点播了一下,nacos2以上版本使用了4个端口,可是我单机部署应该用不了那么多端口,那时候我只暴露了一个8848,之前我在k8s上集群部署过才需要这么多端口:其
通过加载必要的内核模块和启用桥接网络的 IP 过滤功能,我们可以轻松解决文件不存在的问题。对于大多数容器化环境和 Kubernetes 用户,这一步骤是至关重要的,能够确保网络通信的稳定性和安全性。记住,如果您希望这些设置在系统重启后仍然生效,可以将其持久化到sysctl配置文件中。希望本文能帮助您解决相关问题,顺利使用容器化应用。
禁用iptables和firewalld服务,kubernetes和docker在运行中会产生大量的iptables规则,为了不让系统规则跟它们混淆,直接关闭系统的规则。下载镜像:此镜像在kubernetes的仓库中,由于网络原因,无法连接,下面提供了一种替代方案下载这些镜像。在安装kubernetes集群之前,必须要提前准备好集群需要的镜像,所需镜像可以通过下面命令查看。,在查看集群状态 此时的
一、确定nacos需要使用的mysql信息,后面会用到二、nacos镜像版本2.0.3,nacos/nacos-server:2.0.3上yaml# cat nacos-StatefulSet.yaml---apiVersion: v1kind: Servicemetadata:name: nacoslabels:app: nacosspec:selector:app: nacosexternal
Go微服务架构实战本系列文章主要是针对云原生领域微服务架构的实战,包括网关,k8s,etcd以及grpc等相关技术的应用,同时也会把服务发现与注册,熔断,降级,限流以及分布式锁等加入到系列当中作为补充,课程的最后也会安排分布式链路追踪框架的学习,监控平台的搭建以及灰度发布等技术服务,所以总体来讲,课程范围涉及技术领域较广,知识面比较宽,大家下来各取所需尽量做到熟悉和应用,之后有时间了在研究下源码,
使用阿里云的k8s,更新一个项目需要如下步骤:1.先更新代码2.再将代码打包生成一个docker镜像,推送到阿里云镜像仓库(私有的)3.在阿里云上使用新的镜像新启一个docker,并把老的docker删除(阿里云k8s可以配置钩子,镜像更新自动重启docker)使用jenkins构建,就方便很多了。(先要阿里云k8s镜像更新自动重启docker配置好)在此只使用jenkins运行一个sh文件。只需
集群:多台计算机可以使用k8s组成计算机集群,解决一台计算机不够用的事情。分布式相比集群:相比于分布式来说,集群所解决的问题是一台电脑同时做同一件事能力不够,需要多台电脑做同一件事来解决,比如网站服务器,需要很多计算机处理相同的一件事。分布式则是用多台电脑解决多个问题,更多的用处是将一件事拆分成多个可以同步进行的事务,放在多个计算机上同时执行。所以分布式和集群相似点应该是都有多个计算机。k8s v
在树莓派 Ubuntu 20.04 LTS 上初始化 k8s,在执行 kubeadm init 的时候,出现如下报错:[init] Using Kubernetes version: v1.21.2[preflight] Running pre-flight checks[WARNING SystemVerification]: missing optional cgroups: hugetlb[
kubectl get pods --all-namespaceskubectl describe pod coredns-66bff467f8-kx4ck -n kube-systemkubectl logs -f coredns-66bff467f8-kx4ck -n kube-systemlinux/amd64, go1.13.6, da7f65bE0713 08:17:10.6682281
jenkins部署可参考如下方法,使用docker安装部署:mkdir -p /data/jenkins/jenkins_homecd /data/jenkinsdocker run -d -m 2048M -c 1024-p 8080:8080 -p 50000:50000--name jenkins -u root \-v /data/jenkins/jenkins_home:/var/jen
helm简介Helm 可以理解为 Kubernetes 的包管理工具,可以方便地发现、共享和使用为Kubernetes构建的应用。1.Helm的三个基本概念Chart:Helm应用(package),包括该应用的所有Kubernetes manifest模版,类似于YUM RPM或Apt dpkg文件Repository:Helm package存储仓库Release:char...
这里列出了 Gitea 与其它一些 Git 托管工具之间的异同,以便确认 Gitea 是否能够满足您的需求。请注意,此列表中的某些表项可能已经过时,因为我们并没有定期检查其它产品的功能是否有所更改。⚙️ - 由第三方服务或插件支持。低资源开销 (RAM/CPU)Git 驱动的静态 pages。Markdown数学公式。Markdown绘图。
K8S裸机集群只能使用 NodePort 或者 externalIPs service 来对面暴露服务,然而这两种方式和 LoadBalancer service 相比都有很大的缺点。NodePort 使用的端口范围是 30000-32767。当需要暴露的服务到达一定数量时,无法提供暴露。并且没有负债均衡的策略。端口也可能冲突externalIPs 需要为每个服务分配外部 IP 地址。这在 IP
k8s集群中搭建有elasticsearch服务一般都会用到pvc,但是考虑到有些自建k8s环境下,搭建的共享存储可能会存在稳定性及性能问题,所以这次是通过采用节点亲和性和hostpath来实现,目前的operator的基本都是采用共享存储的方法。本文将根据现有环境及不同需求将elasticsearch集群的搭建采用hostpath+亲和性的权重+多个副本分区的方式来实现数据持久化和高可用
1)新建一个nodeport类型的service ,选择器和application-deployment-rest 保持一致,映射8081端口。1)k8s上能执行kubectl 命令的节点上创建自定义工作负载配置任务文件 flink-cdc-demo.yaml。2) 访问flink-web-ui service 对应的端口即可出现flink-web-ui界面。1、在k8s 上部署 flink-ku
Docker镜像是构建应用程序的基础。然而,许多组织和开发团队希望保留他们的Docker镜像在私有仓库中,并从中拉取镜像,而不是从公共Docker Hub中下载。这样做的原因有很多,包括:因此,从私有仓库中拉取镜像已经成为了许多企业和开发团队的最佳实践。在本篇博客中,我们将探讨如何在Kubernetes集群中成功地从私有仓库中拉取镜像,以便更好地管理和部署应用程序。
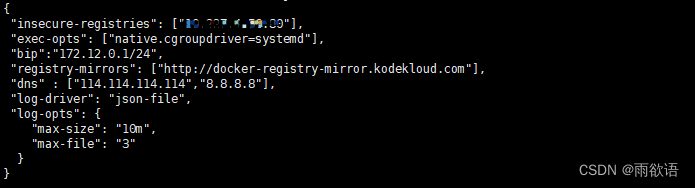
首先,找到docker的配置文件,通常是/etc/docker/daemon.json,如果文件不存在,你可以创建它。我这里部署harbor镜像仓库使用的是http,不是https,所以需要配置Insecure Registries,以便Docker能够与这些Registry建立连接。jenkins服务器使用docker login提示contection failed。重新启动Docker服务,
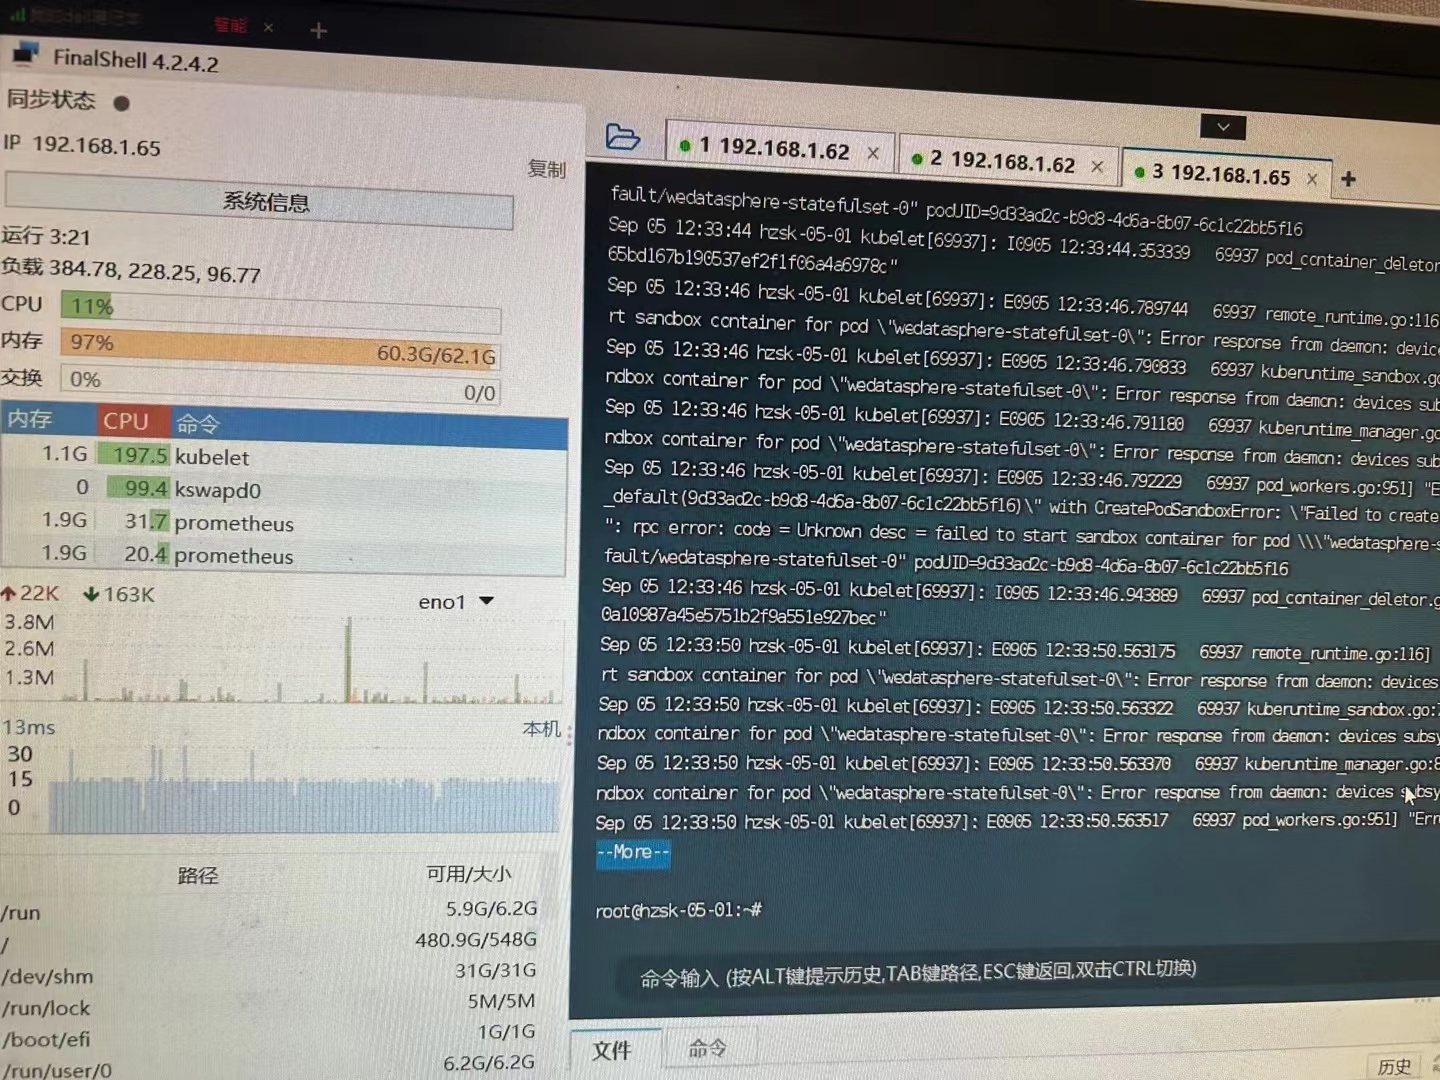
cgroup 挂载设备Failed to create pod sandbox: rpc error: code =devices subsystem is required: unknown
其中 application.properties 挂载到:/home/nacos/conf/application.properties,项目--配置--配置字典(需要添加两个数据,分别是application.properties和cluster.conf),不过这些都不能让我们在外面访问,所以这里还要再创建一个 nodeport 的服务,可以在外面访问到 nacos。cluster.conf
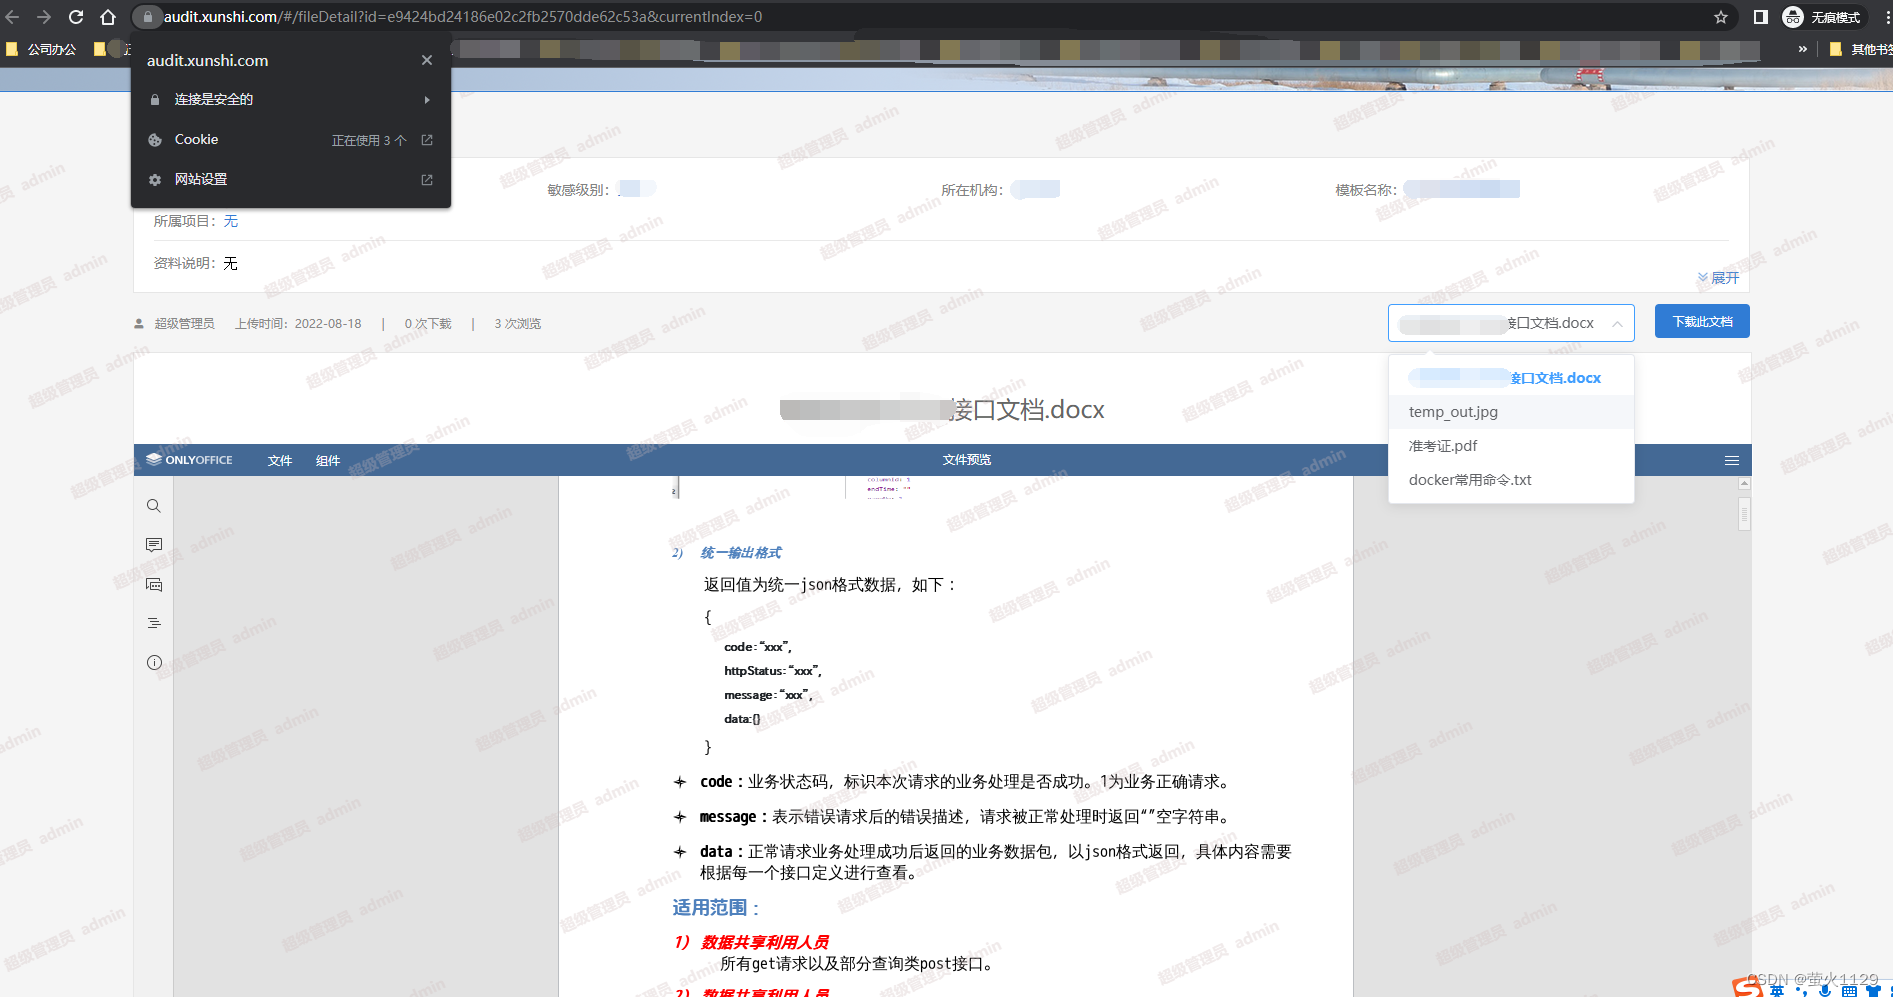
纯内网环境中k8s下onlyOffice启用https
修改Kubernetes报错cannot allocate memory的问题
k8s中所有节点做高可用,使用vip做代理.haproxy+keepalived实现
k8s排错过程----出现cgroupfs报错;FileContent --proc-sys-net-bridge-bridge-nf-call-iptables报错
上一篇,已经讲解了如何给harbor镜像仓库推送镜像。这一篇分享下,在k8s里头
helm3使用入门 - —八戒— - 博客园
环境:服务器 ubuntu1804*4k8s版本:v1.18.3docker版本:19.03.8背景:同事突然反馈说某个界面展示不了数据,还报服务访问错误,经过排查以后是Clickhouse集群出了问题。解决步骤1.在k8s集群上查看clickhouse集群状态Kubectl get pod |grep clickhouse查看发现报Clickhouse其中一个节点挂掉并显示OOMKilled,一
https://docs.rancher.cn/docs/rancher2.5/installation/install-rancher-on-k8s/_index/1. 安装helmcurl -OL https://get.helm.sh/helm-v3.6.3-linux-amd64.tar.gztar -xf helm-v3.6.3-linux-amd64.tar.gzcp linux-am
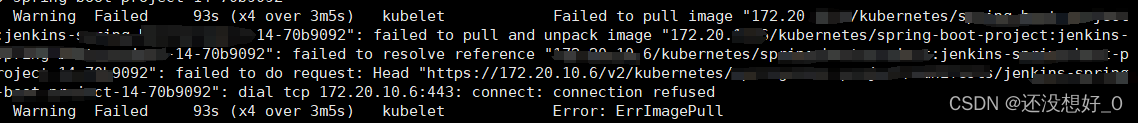
解决问题:failed to solve with frontend dockerfile.v0: failed to create LLB definition: failed to do request: Head https://172.16.100.107:2180/v2/base/nginx/manifests/1.17.6: http: server gave HTTP respons
聊聊四层和七层负载均衡。
如果你的es报错跟我一模一样,恭喜你找到组织了。这个问题也困扰我好久,开始以为是一个k8s节点运行了多个es。特意在k8s集群中加入新的节点来运行报错的es节点。但是还是报这个错。后来查看了es的持久存储pv使用的nfs 服务器文件夹的权限,发现还是root权限。导致es节点没法写入数据。解决方法:登陆到nfs服务器。对nfs的文件夹进行授权。chown -...
使用jenkins pipeline实现maven项目自动化构建打包部署至k8s前言目前公司环境分为dev,test,demo,pro等环境,各个环境独立,springcloud config配置复杂,构建部署强依赖运维,开发者平台应运而生。本文在于解决,开发者提交完开发的代码,在开发者平台点击构建,打包,部署等动作,目前这一套流程仅适用于dev环境,从test环境开始,都会产生chart包,..
k8s
——k8s
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 DAMO开发者矩阵
 openEuler 社区
 AI硬件创业社区


 乐奇 Rokid 开放社区