


- @weixin_51589123


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
提示:文章写完后,目录可以自动生成,如何生成可参考右边的帮助文档文章目录前言一、pandas是什么?二、使用步骤1.引入库2.读入数据总结前言提示:这里可以添加本文要记录的大概内容:例如:随着人工智能的不断发展,机器学习这门技术也越来越重要,很多人都开启了学习机器学习,本文就介绍了机器学习的基础内容。提示:以下是本篇文章正文内容,下面案例可供参考一、pandas是什么?示例:pandas 是基于N
目录(一)为什么要学习pandas的时间序列(二)pandas创建时间序列(三)案例分析3.1 911电话按照紧急类型进行统计分析3.1.1统计不同类型的紧急情况的次数3.1.2 统计出911数据中不同月份电话次数的变化情况3.1.3 统计出911数据中不同月份不同类型的电话的次数的变化情况3.2 PM2.5数据分析(一)为什么要学习pandas的时间序列不管在什么行业,时间序列都是一种非常重要的
文章目录1、sklearn中的降维算法(1)PCA(2)SVD(3)思考2、重要参数n_components3、PCA中的SVD4、重要接口inverse_transform5、重要接口,参数和属性总结6、案例:PCA对手写数字数据集的降维1、sklearn中的降维算法PCA使用的信息量衡量指标,就是样本方差,又称可解释性方 差,方差越大,特征所带的信息量越多。(1)PCA我们希望能够找出一种办法
内容来源于【菜菜&九天深度学习实战课程】上班以后时间少,为了提高效率,通过抄课件的方式加深记忆,而非听课。所以所有笔记仅仅是学习工具,并非抄袭!在传统机器学习中,通常会区分有监督、无监督、分类、回归、聚类等人物类别,在不同的任务重会指向不同形式的标签、不同的评估指标、不同的损失函数,这些内容会影响我们的训练和建模流程。在深度视觉以外,除了区分“回归、分类”之外,还需要区分众多的、视觉应用类别。
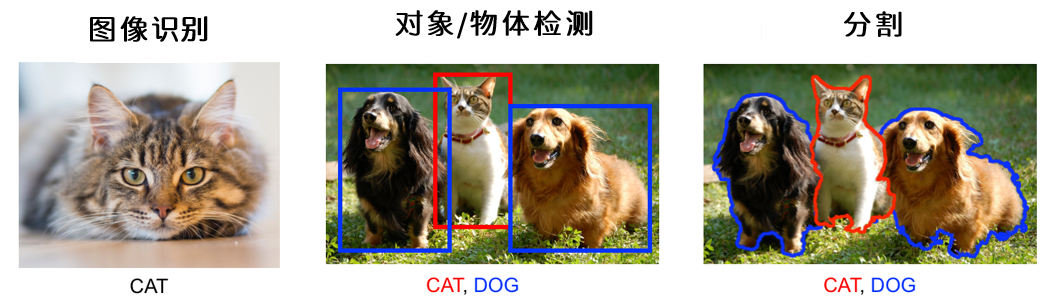
提示:仅仅是学习记录笔记,搬运了学习课程的ppt内容,本意不是抄袭!望大家不要误解!纯属学习记录笔记!!!!!!文章目录前言一、优化器与状态字典(state_dict)state_dict模型本地保存与读取方法二、LambdaLR基本使用方法三、LambdaLR学习率调度实验1.前期准备2.构建新的lambda函数3.模型训练与结果比较对比恒定学习率为0.03时模型训练结果对比恒定学习率为0.01
提示:仅仅是学习记录笔记,搬运了学习课程的ppt内容,本意不是抄袭!望大家不要误解!纯属学习记录笔记!!!!!!文章目录前言一、梯度消失与梯度爆炸二、Sigmoid和tanh激活函数的梯度更新问题理论说明Sigmoid函数饱和区间Sigmoid激活函数叠加后的梯度消失问题前言模型病灶与模型调优。实际上模型优化更像是对“患病”的模型进行诊断、然后对症下药,通过这些“治疗”方法,最终让模型运行恢复正常
提示:仅仅是学习记录笔记,搬运了学习课程的ppt内容,本意不是抄袭!望大家不要误解!纯属学习记录笔记!!!!!!文章目录前言一、Xavier方法1.Xavier初始化参数方法基础理论前言本部分内容介绍的是:参数初始化优化方法,也就是针对tanh和Sigmoid激活函数的Xavier方法,以及针对ReLU激活函数的Kaiming方法(HE初始化)。一、Xavier方法1.Xavier初始化参数方法基
注:仅仅是学习记录笔记,搬运了学习课程的ppt内容,本意不是抄袭!望大家不要误解!纯属学习记录笔记!!!!!!文章目录一、机器学习中的优化思想二、回归:误差平方和SSE三、二分类交叉熵损失函数1 极大似然估计求解二分类交叉熵损失2 用tensor实现二分类交叉熵损失3 用PyTorch中的类实现二分类交叉熵损失四、多分类交叉熵损失函数一、机器学习中的优化思想模型训练的目标:求解一组最适合的权重向量
提示:文章写完后,目录可以自动生成,如何生成可参考右边的帮助文档文章目录前言一、简单线性回归的机器学习建模思路1、回顾简单线性回归建模问题2.转化为优化问题3.最优化问题的求解方法图形展示目标函数函数的凹凸性凸函数的最小值SSE最小值4.机器学习建模一般流程Step 1:提出基本模型Step 2:确定损失函数和目标函数Step 3:根据目标函数特性,选择优化方法,求解目标函数二、第一个优化算法:最
神经网络兴起的三驾马车:算法、算例和数据