


- @AggressiveYu


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
《The C Programming Language》(简称 K&R)的第 4 章是 C 语言进阶的转折点。如果说前三章是在教你如何写“句子”,那么第四章就是在教你如何写“文章”。
19世纪末到20世纪初,统计学家(最典型的是Pearson那篇论文)遇到一个很具体的麻烦:他们手里有一批样本,每个样本身上量了好几个指标(比如同一批人的身高、体重、头围、坐高……),这些指标彼此并不独立——量了身高,某种程度上就能猜个大概体重。当时的困扰是:这些指标高度"重叠信息",但没人知道怎么用一个数学上站得住脚的办法,把重叠的部分"挤掉",只留下真正独立、有信息量的少数几个新指标。
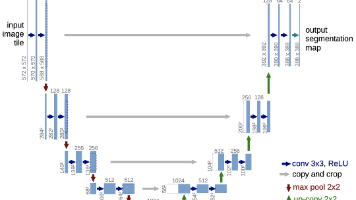
U-Net 是一个非常经典且极其重要的卷积神经网络(CNN)架构。它最初是为了生物医学图像分割而设计的,但由于其特别的设计,如今已经成为各种图像分割任务乃至 AI 图像生成模型(如 Stable Diffusion)的核心组件。
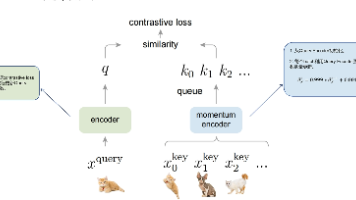
在深度学习追求“更大数据、更强模型”的浪潮中,昂贵的人工标注成本始终是一道难题。自监督学习(Self-Supervised Learning)为此而生,旨在让模型从海量无标签数据中自我进化,而其中的“对比学习”更是当今最闪亮的明星。然而,传统的对比学习方法常常受限于巨大的计算资源(尤其是显存)。本文将带你深入探索里程碑式的工作——MOCO (Momentum Contrast)。我们将从最基础的“
这周开始,我将会开始一场苏格拉底式的大模型(LLM)构建教学,教大家学会如何构建GPT,Deepseek这样的大模型(当然是缩水版)
需要手写训练所需的组件,而不是直接调用库函数:Cross-Entropy Loss: 手写交叉熵损失函数,注意处理 LogSumExp 的数值稳定性 。AdamW 优化器: 手写 AdamW 优化算法,包括动量更新和权重衰减逻辑。学习率调度:实现 Cosine Annealing(余弦退火)学习率调度器,带 Warmup 阶段 。Checkpointing:实现模型和优化器状态的保存与加载 。Da
这一章节会非常长,我们不仅要会写代码,还要把所有知识点吃透,不满足简单的定理,以及我会问一些及其深刻的问题,作为一个小点收尾,我敢打包票的事,你用一周或者两周时间吃透这篇博客,你的能力会有质的飞跃。
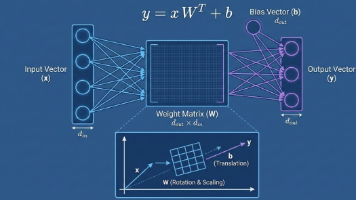
Pre-Norm(为了稳) +RMSNorm(为了快)。SwiGLU。ROPE(旋转位置编码)。(约 2.67倍)。使用GQA(分组查询) 来加速推理。多语言模型选100k+。用QK Norm或。不要加输入 (Input): "The cat sat on the"v[ 1. Tokenizer (分词器) ]| 操作:查表| 输出:Token IDs [101, 856, 221, ...]v[
为了真正讲透 RLHF (Reinforcement Learning from Human Feedback,基于人类反馈的强化学习),我们不能只看它是“怎么做的”,必须看它是“怎么来的”。
混合精度训练(Mixed Precision Training)是现代深度学习(特别是大模型训练)的基石。如果不理解它,就无法真正理解为什么现在的显卡(如 H100, A100)要这样设计,也无法理解大模型训练中的显存优化技巧。