登录社区云,与社区用户共同成长
邀请您加入社区
以上就是鸿蒙 ACL 权限申请的全过程:**先搞清判定规则,别凭印象申请;二进制证书个人不可得,断了「随包自带运行时」的念想;最后 3 项受限权限一次通过。**如果你也在做鸿蒙上架,这套「先判定、再精准申请、申请原因咬住官方约束」的思路可以直接抄。下一篇我写App 上架合规踩坑:被 AppGallery 打回 12 条整改,从商标撞名到 ArkWeb 合规,一条条踩过去。关注公众号并设为星标,别错
如果这个定位成立,那么 FlashMLA 与 FlashAttention 这类通用注意力实现的关系就不是替代关系:前者是面向特定模型结构的深度优化 kernel,后者覆盖更广的注意力变体集合。对迁移者的实际含义是:如果模型不用 MLA 结构,FlashMLA 的价值有限;如果用 MLA 结构,那么它是推理/训练路径上的关键 kernel,其正确性与数值行为需要单独验证,包括 softmax 缩放
在国产 AI 芯片上跑大模型是什么体验?问任何一个干过适配的工程师,大概率会收到一声叹息:芯片参数单看着都行,真跑起来,算子要自己写、通信库要自己凑、性能要自己调——硬件之上那一整层软件生态,才是最缺的东
AI 应用 = 调用 API。我们用几行代码让大模型开口说话,还学会了如何从 OpenAI 平滑切换到 DeepSeek。但现在的程序有个小问题——问一次就结束,而且它记不住上一句话。下一课,我们把它改造成真正的聊天机器人,并引入「对话历史」这个概念,这是 Memory 的第一步。
看完这篇,你会拿到一份可照抄的鸿蒙化规划。本文先给全景图:三层难点、为什么只换运行时、4 阶段构建、补丁为什么涨到 14+;后面每篇深挖一层。
中电信星辰大模型Xing4.0-29B-A4B在昇腾910C芯片与MindSpore框架下,训练吞吐较开箱状态提升96%,全靠软件栈优化:细粒度MoE通信、选择性重计算、算子融合等技术实现。这一突破凸显国产训练栈从“能跑”迈向“高效训”的关键跃迁。结合华为昇腾960超节点发布与科大讯飞语音模型落地,中国大模型竞争正从“堆参数”转向“比栈成熟度”。96%的提升非硬件之功,而是软件对算力潜力的深度挖掘
Seedance + Codex/HyperFrames双路径:Seedance负责视觉镜头生成,Codex/HyperFrames负责可控剪辑、字幕、配音、转场与工程化复用。如何通过Open AI Prism实现全流程写作,快速处理数学公式,论文引用,如何通过GPT5.2大模型的多模态功能,将手写公式直接导入论文,避免复杂公式的时间消耗。大语言模型(ChatGPT、Claude、Gemini、D
一、大模型评分标准1、四组旗舰与蒸馏模型2、评分标准与规则二、大模型多维对比1、参数对比2、旗舰与蒸馏的压缩比三、多维排名1、文字能力2、思考推理能力3、数学与科学能力4、编程能力5、自主 Agent 执行能力6、成本效率7、多模态理解能力8、日常办公四、场景选型1、场景决策2、团队选型五、落地实施1、路由 : 按不确定性分档路由2、缓存 : 缓存与峰谷的成本控制3、回归 : 自建回归集六、注意事
鉴于上面四种方式的利弊权衡,我最终选择了 WebCodex ,因为后续还是想把这种方式当做常驻的 Coding Agent。其实 DevSpace 也不错,我看看大家如果感兴趣的话,后面我也写一下 DevSpace 的,然后来实际对比一下。WebCodex 刚刚发布了 v0.4.1 版本,这次更新比之前白膜的界面有所提升了。Mac 用户直接下载对应的 Desktop 安装包就行。Apple Sil
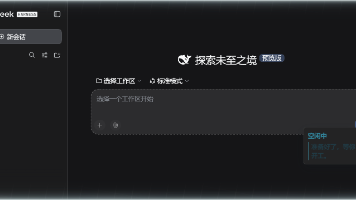
本文记录在 WSL2 Ubuntu 中使用 DeepSeek Harness 时,点击“添加工作区”不弹窗、只看到小企鹅窗口最小化的问题。通过修改 cordis.patch.yml,禁用系统原生目录选择器并启用浏览器内目录选择器解决,附完整配置和端口占用处理方法。
9 月 15 日,中国网络空间安全协会联合国家互联网应急中心及百度、科大讯飞、知乎等单位,在济南国家网络安全宣传周上发布中文互联网基础语料 4.0,数据量 120GB,并上线"中文互联网语料资源平台"。同日,华为发布全球首个 3D 数据中心架构,目标支撑十万卡以上昇腾超节点集群;字节跳动 CEO 梁汝波宣布已完成豆包、飞书、火山引擎的组织整合,发力企业 AI 市场。这三件事恰好对应国产大模型基础设
本文详细介绍了如何利用DeepSeek和豆包大模型构建主题乐园智能行程规划系统,涵盖多智能体协同架构设计、Eino框架集成配置及实战开发全流程。通过Function Call实现实时数据交互,该系统能动态生成个性化游园方案,显著提升游客体验与运营效率。
本文详细介绍了如何利用DeepSeek和Playwright实现高效自动化测试的5个关键步骤,包括元素定位、异步等待、测试数据管理、异常处理和脚本优化。通过自然语言指令生成稳定脚本,结合低代码实践,帮助测试工程师避开常见陷阱,提升测试效率和可靠性。
本文提供了一份详细的Windows环境下利用Ollama一键部署DeepSeek模型的实战指南。内容涵盖从安装Ollama、选择合适模型版本到一键下载运行的全过程,并介绍了进阶的本地部署技巧,如更改存储路径、API调用及部署图形化界面,旨在帮助用户轻松在个人电脑上搭建私有、安全的AI助手。
自DeepSeek-R1发布以来,Reasoning model(推理模型)可谓是大火。同时,LLM领域近期也发生了三件事:• 字节团队发布Seed-Thinking-v1.5技术报告;• 清华&上交团队在paper中提出:RL并不能真正提升LLM的推理能力;• 具备Reasoning能力的Qwen3问世,号称思考更深、行动更快。既然推理模型如此重要,笔者本次就针对几款主流的模型做一个总结,主要回
本文介绍了AI导出鸭工具如何解决豆包表格导出Word的难题。传统方法存在格式错乱、操作复杂等问题,AI导出鸭通过自研技术实现一键无损导出,支持多级表头、合并单元格等复杂格式,适配电脑、手机、平板全终端。数据显示使用该工具可将导出时间从11分钟缩短至18秒,格式修复率提升96%。产品提供浏览器插件、APP、小程序等多种使用方式,基础功能免费,是提升AI办公效率的实用工具。
本文详细介绍了如何通过SpringBoot集成MCP协议,实现DeepSeek直接驱动业务数据库的实战方案。无需依赖Ollama,开发者可以快速构建AI与数据库的高效交互系统,提升业务开发效率。文章涵盖环境配置、MCP服务端实现、智能对话客户端构建及高级优化技巧,助力开发者轻松应对AI集成挑战。
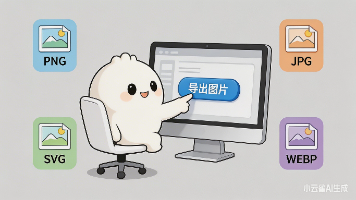
本文针对AI绘画平台(如豆包)图片批量导出效率低的问题,从技术角度分析了三大难点:动态DOM结构、懒加载策略和CORS限制,并探讨了三种解决方案(自动化脚本、API解析、浏览器扩展)。重点推荐了开箱即用的「AI导出鸭」插件,该工具深度适配平台结构,支持一键批量导出及跨平台资源管理,有效解决了专业用户的高效素材获取需求,平衡了技术实现与用户体验。全文为AI创作流程中的资源归档提供了实用优化方案。
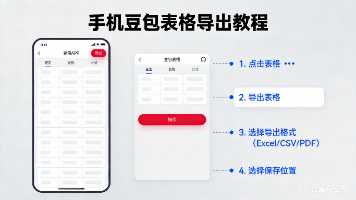
本文探讨了豆包移动端表格导出的技术挑战与解决方案。移动端因沙盒机制、富文本渲染差异和缺乏原生导出接口,导致表格导出困难。常规方法如Markdown代码块、PDF中转和Web端同步各有局限。理想的导出工具需具备智能解析、多维渲染和一键交互能力。推荐使用AI导出鸭APP,它能原生兼容豆包格式,一键导出为Excel或PDF,实现高效转换。该工具解决了AI移动端产出与本地办公间的数据流通问题,大幅提升工作
本文提供了在Mac上快速部署Ollama与DeepSeek的完整指南,涵盖从安装到模型运行的全过程。详细介绍了Ollama的安装步骤、DeepSeek模型的选择与下载,以及高级使用技巧和性能优化建议,帮助开发者和AI爱好者轻松在本地运行大语言模型。
本文详细介绍了如何利用n8n和DeepSeek快速构建自动化问答系统,批量处理Google表格数据。通过环境配置、核心工作流构建、高级循环控制技术以及结果回写与错误处理等步骤,实现高效数据自动化处理,大幅提升工作效率。特别适合电商、客户满意度调查等场景。
DeepSeek Harness 本地部署与第三方插件排障实录:从 fetch failed 到 preset not found > 本文是一次完整真实的排障复盘:在 Windows 上从零跑通 DeepSeek Harness(dsh), > 再装上一个第三方 client UI 插件,然后把踩到的每一个坑连根因带修法全部拆开。 > 文中所有报错原文、版
本文详细介绍了使用Ollama在消费级电脑上部署Deepseek-R1大语言模型的方法,并提供了四种知识库解决方案:Ragflow、Dify、Cherry Studio和AnythingLLM。文章从Ollama安装配置开始,详细讲解了Deepseek-R1模型的下载与使用,以及如何将模型与不同知识库工具集成,实现本地知识库搭建和智能问答功能,为个人或企业提供了低成本、高隐私的本地LLM应用方案。
本文详细介绍了如何利用Spring AI框架与Ollama本地模型服务,结合DeepSeek大语言模型,构建一个可编程的智能家居控制中枢。通过定义工具方法、编写系统提示词,实现模型对自然语言指令的理解与自动化执行,为开发者提供了一个兼顾隐私与高度定制化的AI家居解决方案,并附有完整的代码示例。
本文详细介绍了如何利用Cherry Studio、DeepSeek大模型与Ollama工具,在企业内网环境中构建一个完全离线、安全可控的RAG(检索增强生成)知识库系统。该方案通过本地化部署,确保数据隐私与合规性,并提供了从硬件选型、模型部署到多知识库管理的完整实战指南,帮助企业高效激活内部文档价值。
你有没有想过,有一天可以轻松从海量复杂文档中找到藏针的信息 ?如果你正为企业化私有信息提取困难而头痛不已 ?
下载安装后查看版本号安装成功!搜索具体参数可参照配置表自行选择出现success安装成功!
ollama 是一个开源的本地大语言模型运行框架,它提供了非常简单便捷的使用形式,让用户可以十分方便的在本地机器上部署和运行大型语言模型,从而实现免费离线的方式使用 LLM 能力,并确保私有数据的隐私和安全性。
(同时,在用Trae,在写一个游戏教学,total用时3小时,浓缩时长估计5分钟)用了CSDN推荐的IDE,基于AI开发代码几乎不自己写代码习惯了双屏幕ctrl+c ,ctrl+v的程序员,自然也会习惯这种一半代码,一半AI的界面。
近期,DeepSeek-R1模型凭借其在数学推理、代码生成和自然语言推理Reasoning等领域的卓越性能,引起广泛关注,从AI界火出圈了。很少有一种技术既能充当幕后扛旗的无名英雄,又能兼具网红明星的气质。而DeepSeek做到了这一点。作为提升生产力的利器,DeepSeek正吸引着众多个人开发者与企业用户的兴趣,他们纷纷寻求在本地环境中部署DeepSeek-R1模型,以充分利用其强大的AI能力。
本文介绍了在Windows环境下,通过Ollama来本地部署DeepSeek R1。该问包含了Ollama的下载、安装(命令和双击安装)、安装目录迁移、大模型存储位置修改、下载DeepSeek以及通过Web UI来对话等相关内容。
本文将深入探讨如何使用DeepSeek来进行性能测试。性能测试往往涉及大量数据分析和性能瓶颈诊断,这正是AI的强项。让我们看看如何借助DeepSeek的强大能力,让性能测试变得更智能、更高效。
unity 接入阿里云版Deep Seek 完整代码
区分本机服务未启动、插件加载失败和模型请求报错,用 dsh-launcher 的状态与 Doctor 入口、Error Lens 及 Billing 排查和观察,附兼容说明与下载入口。
回头看这5天:把过期时间写进模型名是工程师的浪漫,被用户顶回来续命是商业的清醒,四音色的海洋命名是品牌的用心。一家曾经"发模型看心情"的实验室公司,正在学着在能力、成本和客户感受之间找平衡。一个实验室开始"听劝",未必是坏事。只是这个通知节奏——做API集成的朋友,最好早点习惯。参考信源:DeepSeek开放平台API定价页及公告、钛媒体(2026-09-13)、网易科技·三易生活(2026-09
同一份输入,缓存命中付 0.02 元,未命中付 1 元。50 倍的价差,是理解「中国模型调用量连续 20 周超过美国」最直接的一把尺子。
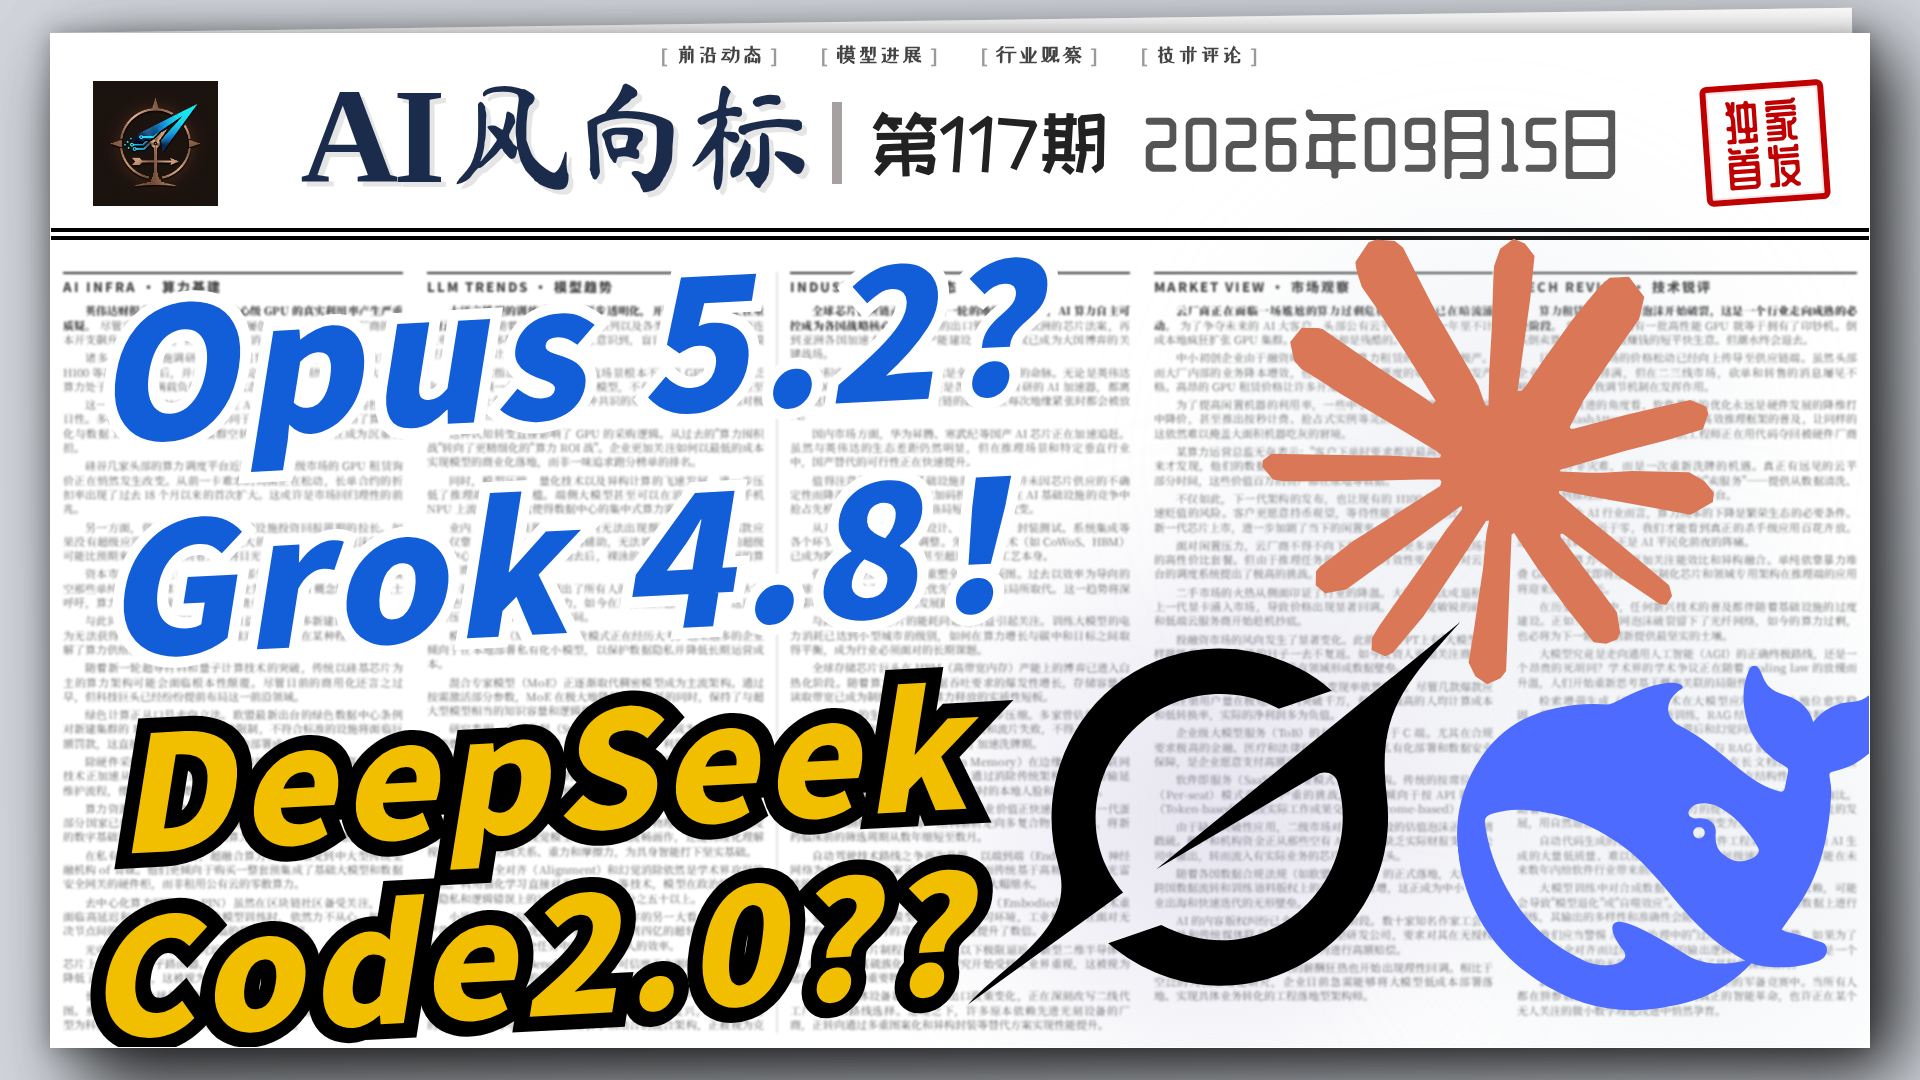
DeepSeek Code 2.0泄露,传闻开放权重并支持百万上下文;Claude Code疑似把Opus 5路由到Opus 5.2;马斯克宣布Grok 4.8完成2.5万亿参数预训练,巨头集体亮出下一代底牌,模型竞争白热化。
本文介绍如何利用ICOAST和ITAG等结构化Prompt模型,高效挖掘DeepSeek大语言模型在测试用例生成方面的潜力。通过电商登录模块的实战案例,详细拆解了如何将测试思维框架转化为精准指令,从而生成全面、深度且可执行的测试用例,显著提升测试设计效率与覆盖率。
本地化部署DeepSeek-R1蒸馏大模型:基于飞桨PaddleNLP 3.0的实战指南
随着DeepSeek的日益流行和AI技术的飞速发展,今天我们将深入探讨如何利用DeepSeek来增强自动化测试的效率与质量。通过AI的介入,我们有望实现测试过程的智能化与高效化。
本文详细介绍了如何在 Windows 系统上通过 Ollama 部署 DeepSeek 模型。从安装 Ollama、下载 DeepSeek 模型到运行测试,每一步都配有具体操作和代码示例。文中还提供了 API 集成和图形界面的可选方案,适合初学者和开发者快速上手。无论是生成文本还是解决实际问题,本地部署 DeepSeek 既简单又高效,兼顾隐私与性能。
DeepSeek
——DeepSeek
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 人工智能6S服务平台



 DAMO开发者矩阵


 AtomGit AI 社区

 2048 AI社区


 DeepSeek技术社区

 乐奇 Rokid 开放社区













 天工造物局