


- @m0_58966968


简介
首个存内计算开发者社区,基于知存科技领先的存内技术,涵盖最丰富的存内计算内容,以存内技术为核心,史无前例的技术开源内容,囊括云/边/端侧商业化应用解析以及新技术趋势洞察等, 邀请业内大咖定期举办线下存内workshop,实战演练体验前沿架构;从理论到实践,做为最佳窗口,存内计算让你触手可及。传送门:https://bbs.csdn.net/forums/computinginmemory?category=10003;
擅长的技术栈
可提供的服务
暂无可提供的服务
在神经网络的实际应用中,ADT(AdderTree,ADT)的输入数据往往不是完全随机的,而是存在一定的统计特性。在软硬件协同优化方面,研究团队提出了SS-VAF技术,通过在CIM内部实现FP2MX和SS处理,并结合方差信息提升输入尾数的稀疏性,有效降低了数据传输开销和计算能耗,克服了传统CIM设计中系统到CIM数据传输的瓶颈难题;此外,A2-DF累加感知数据流技术的提出,实现了动态可重配置的数据

大语言模型的表现往往遵循扩展法则,但是对于某些能力,只有当语言模型规模达到某一程度才会显现,这些能力被称为“涌现能力”,代表性的涌现能力包括三点:其一是具备上下文学习能力,可以通过完成输入文本的词序列来生成测试实例的预期输出,而无需额外的训练或梯度更新;本篇文章集中讨论了存内计算技术在加速大语言模型推理方面的潜力,从大语言模型的背景知识出发,探讨目前其面临的挑战,进而剖析两篇经典的文献以彰显存内计

具体体现在边缘PaaS平台的云边协同能力,包括边缘资源运维管控、应用管理、云管边端的云边协同,利用OpenYurt提供的容器化隔离环境,统一部署Master集群在公有云,将结点下沉到边缘端,并重写结点的心跳检测机制和自治逻辑,以实现边缘容器在稳定的局域网络环境中自运行。随着云边端计算的不断发展,存算架构的优势不断显现,通过赋能边缘计算,相信在不远的将来,存内计算的应用将更为广泛。从以上对云边端计算

存内计算技术是一种新兴的计算范式,其核心理念是将存储和计算功能集成在同一硬件单元中。这种技术的优势在于能够在存储单元内部直接进行计算操作,从而减少数据在存储器和处理器之间的传输,提高计算效率。存储与计算的集成:存内计算技术通过在存储单元内部集成计算逻辑,实现了存储和计算的紧密结合。这允许在存储单元内部直接进行计算操作,而不需要将数据传输到外部处理器。减少数据传输:由于计算操作在存储单元内部进行,存
存内计算芯片通过器件、架构、电路、工艺的协同创新,突破了冯诺依曼架构的限制以实现高能效比。例如,在实时语音转写应用方面,具身智能通常在本地实时地进行语音转写和处理,不仅减少了延迟还实现了更加丰富和多样化的交互体验,与此相比传统的人工智能依赖于预训练的数据,在面对实时变化的环境时难以快速反应。具身智能作为人工智能的下一个浪潮,相比传统的工业机器人、协作机器人等,其有着智能化程度高、工作场景限制小、能

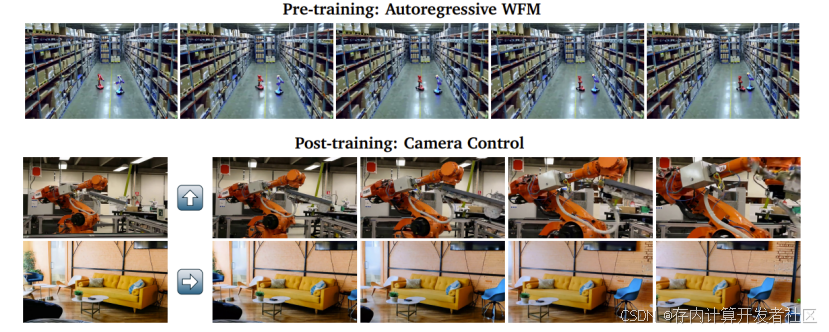
cosmos是一个用于加速物理AI开发的平台,可以预测与生成未来虚拟世界物理感知视频的神经网络,以帮助开发者进一步构建未来机器人与自动驾驶应用。WFM如大语言模型,属于一个基础性模型,WFM 通过学习大规模视频数据集中的物理规律和自然行为,能够生成与现实世界具有一定相似性的3D高清视频场景。同时通过扩散模型和自回归模型,对预训练的 WFM 进行微调,可以使其适应特定的物理 AI 任务。对于当下的具
在3C、汽车、新能源等行业,这些机器人凭借高精度的视觉检测和精准的运动控制能力,实时感知并适应复杂变化的工业环境,大幅提升生产效率和产品质量,降低人力成本和生产周期。随着技术的成熟和成本的降低,具身智能机器人有望实现从专业领域向大众消费市场的普及,成为人们生活中不可或缺的一部分,深刻改变人类的生产生活方式,推动社会的智能化发展进程。Google DeepMind的RT-2模型是VLA的典型代表,它

QAT量化,是将训练过的模型进行量化并再训练。如图5所示,为标准的QAT量化流程,包括跨层均衡(CLE)、添加量化器(Add Quantizers)、范围设置(Range Estimation)、量化参数可学习(Learnable Quantization Params)等步骤,其中在量化参数可学习中,需要直接学习量化参数,而不是在每个周期中更新它们,从而带来更高的性能,特别是在处理低比特量化时,
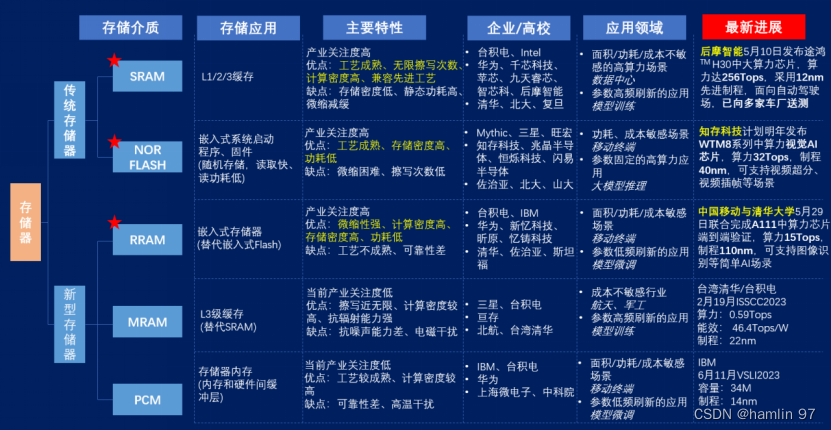
如图4所示,上下为电极层,中间为绝缘的电阻转变层。即相变存储器,是一种由硫族化合物材料构成的非易失存储器件,因为相变材料的两种相在切换之后,即使在断电的情况下也可以相对稳定地保持,这是因为相变涉及材料的结构重排,而这种结构变化是物理上的,并不依赖于持续的电源供应。存储器繁多、各具特点。需要注意的是,以下信息均源于企业的公开资料,由于作者能力有限,未罗列全基于SRAM做存算一体芯片的企业,列举的可能
北京大学研究团队在《Nature Electronics》发表了一项基于忆阻器的存算一体排序架构创新成果。该研究突破了传统排序算法在CPU/GPU上的性能瓶颈,提出"就地排序"理念,通过三项核心技术实现突破:1) 数字读取技术消除物理比较器依赖;2) 树节点跳过技术实现智能剪枝优化;3) 跨阵列并行策略增强可扩展性。实验显示,该架构在速度、面积效率和能源效率上分别提升7.7倍、
