登录社区云,与社区用户共同成长
邀请您加入社区
ELK日志监控体系的核心架构全链路追踪与日志的集成方法基于日志的性能瓶颈定位技术Kibana可视化与告警配置生产环境的最佳实践关键收获通过TraceID实现跨系统日志关联利用ELK快速定位性能瓶颈根源构建数据驱动的性能优化闭环下一步行动在本地搭建ELK环境配置一个Spring Boot应用的日志收集执行压测并分析日志创建Kibana监控看板配置关键性能告警资源推荐ELK官方文档日志模式设计指南。
ELK是Elasticsearch(ES) , Logstash, Kibana的结合,是一个开源日志收集软件。开源分布式搜索引擎,提供存储、分析、搜索功能。特点:分布式、基于reasful风格、支持海量高并发的准实时搜索场景、稳定、可靠、快速、使用方便等。接收搜集的海量结构化日志数据,并提供给Kibana查询分析。开源日志搜集、分析、过滤框架,支持多种数据输入输出方式。用于收集日志,对日志进行过
建议吧stdout这段删除,会影响到导入数据,这个是显示导入数据过程的。# 监听文件读取信息记录的位置(名称随便填一个)# 设置多长时间会写入读取的位置信息(单位:秒)#去除每行记录中需要过滤的\N,替换为空字符串。# 设置多长时间检测文件是否修改(单位:秒)#elasticsearch 的地址+端口。# 监听文件的起始位置,默认是end。# 每行记录的字段之间以|分隔。# 过滤掉默认加上的字段。
elk日志某个时间节点突然搜索不到了,检查filebeat正常Kibana手动上传数据:响应:Error:总分片数量导致的异常,ES总分片数限制最大只有2000个,目前已经用完了,导致已经没法创建新的索引了。解决方案:解决方法就是提高ES的分片数量。方法1:控制台persistent:永久生效,transient:临时生效。
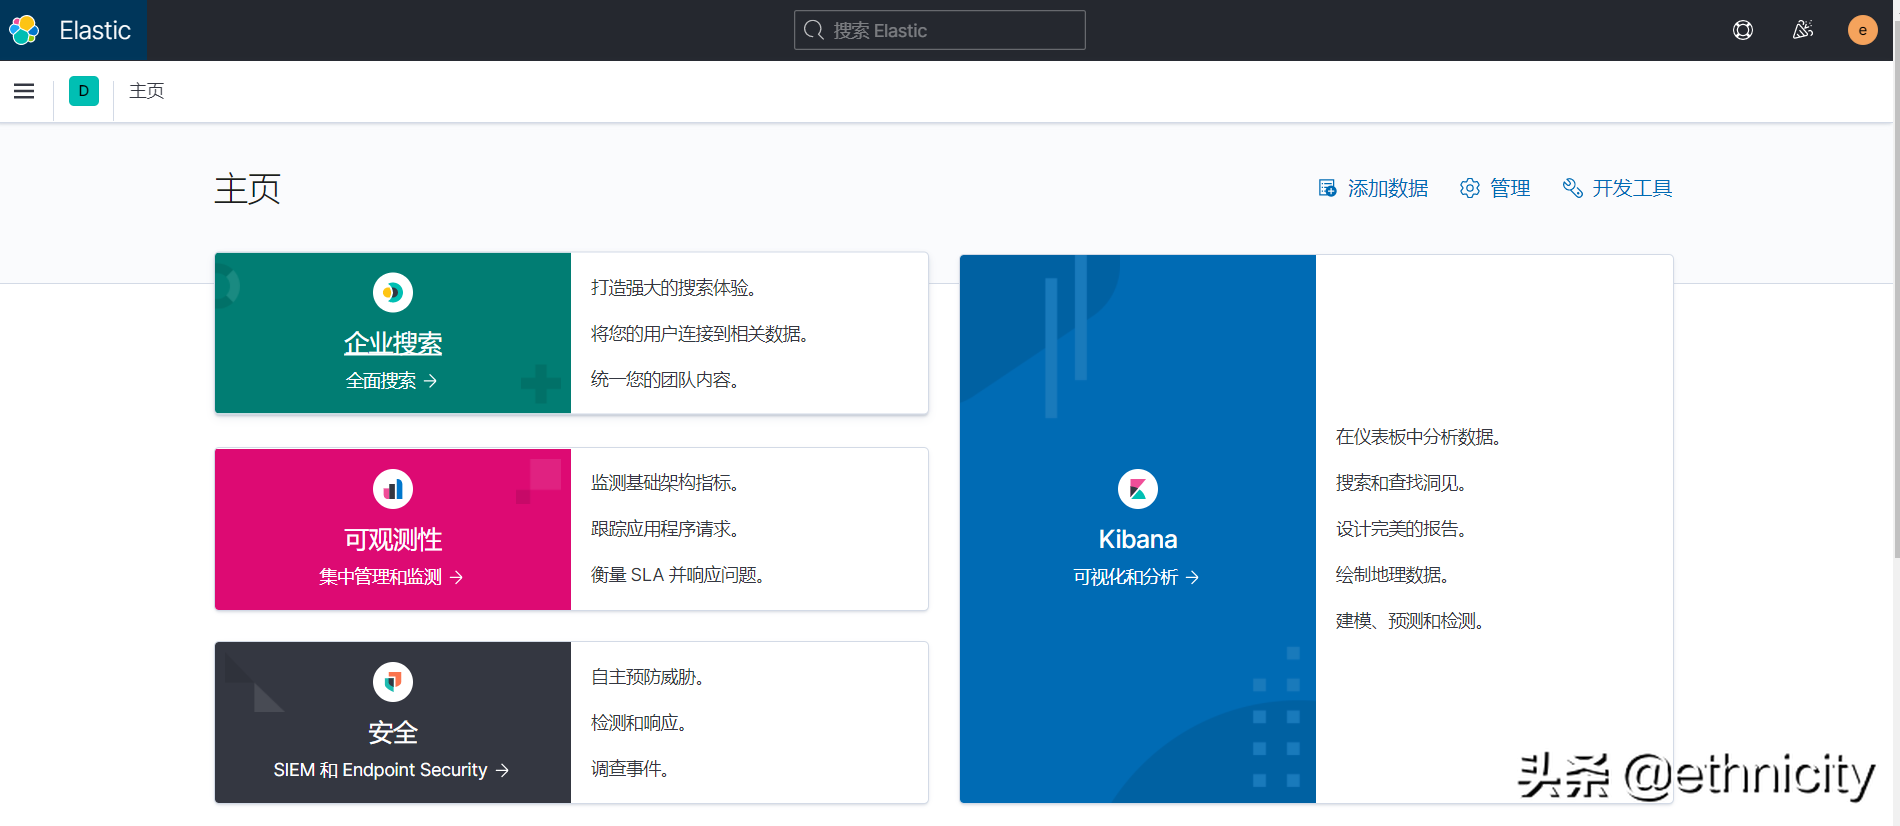
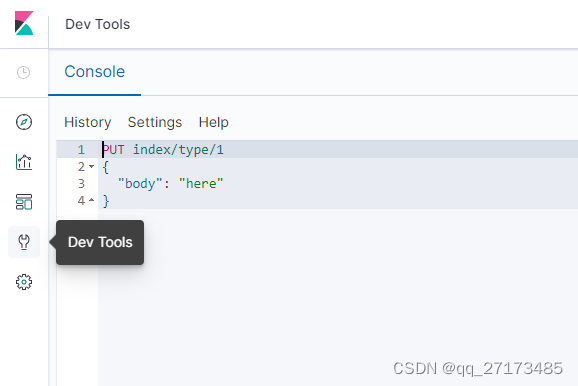
Kibana是一个开源的分析与可视化平台,设计出来用于和Elasticsearch一起使用的。下载好kibana-7.10.2-linux-x86_64.tar.gz后,上传的linux 服务器。我的es是elasticsearch-7.10.2版本,所以kibana 选择同样的版本。解压kibana-7.10.2-linux-x86_64.tar.gz。http://安装的服务器ip:5601/
Linux安装elk
skywalking测试环境部署实战
docker安装elk,springboot整合不同级别日志监控 含TLS和HTTPS
前言这是一个前端项目,需要本机已安装nodejs,资源已放进资源包中。zip资源包http://https://download.csdn.net/download/qq_35261606/80795964提示:以下是本篇文章正文内容,下面案例可供参考。一、下载解压文件略过二、修改端口号如果有修改端口号需求,可以在Gruntfile.js中修改,默认是9100.connect: {server:
综合集群练习搭建如下集群该集群建议3台虚拟机以上来完成!大家根据情况调整配置文档的环境:3台centos7.6系统Elasticsearch虚拟机配置:内存 2G cpu 2C其他为1C1GIP规划Elastisearch+kibana: 192.168.189.171LNMP+logstash: 192.168.189.172zabbix+Grafana: 192.168.189.173安装el
wwww
/data/logstash/logstash-springboot.conf:/usr/share/logstash/pipeline/logstash.conf # 挂载Logstash的配置文件。- /data/elasticsearch/plugins:/usr/share/elasticsearch/plugins # 插件文件挂载。- /data/elasticsearch/:/usr
可以适用于大多数情况,也可根据实际情况可以选择不同的收集工具),收集多种不同格式的数据,并转换成es可以分辨的格式(如json)存入es中指定的索引中,然后通过kibana就可以查看es中收到的数据。es中的文档:是 Elasticsearch 中存储的基本数据单元,表示一条记录或一项数据,类似于数据库中的一行。elastic中的索引:是一个逻辑命名空间,包含一组相关的文档,类似于传统关系型数据库
微服务架构是一个分布式架构,它按业务划分服务单元,一个分布式系统往往有很多个服务单元。由于服务单元数量众多,业务的复杂性,如果出现了错误和异常,很难去定位。主要体现在,一个请求可能需要调用很多个服务,而内部服务的调用复杂性,决定了问题难以定位。所以微服务架构中,必须实现分布式链路追踪,去跟进一个请求到底有哪些服务参与,参与的顺序又是怎样的,从而达到每个请求的步骤清晰可见,出了问题,很快定位。
主要修改input和output,我这个环境通过rsyslog将日志汇聚到了一台服务器的/home/log路径上,所以就写的/home/log下的文件。其中output指向es的开放端口。
json.overwrite_keys: true#覆盖默认的key,使用自定义json格式的key。setup.template.settings:#定义索引分片数和副本。setup.template.name: nginx#索引关联的模板名称。setup.template.name: nginx#索引关联的模板名称。特别分散–> syslog --> file.txt。3.删除filebeat
机器分配。
总结:ELK的作用,当我们管理一个大集群时,响应分析定位的日志就会很多,每一台服务器分别去分析,将会耗时耗力。极高的提高了定位问题的效率。所有的键盘命令行输出,转化成标准输出(rubydebug的模式) , 6.0之后, lgstash的默认输出格式就是rubydebug格式的标准输出。6.0之后的logstash自带的输出格式rubydebug.自动的把输出格式,定义为统- -的标准格式输出。作
版本信息,不一定按照我的版本。
(1)什么是分布式日志在分布式应用中,日志被分散在储存不同的设备上。如果你管理数十上百台服务器,你还在使用依次登录每台机器的传统方法查阅日志。这样是不是感觉很繁琐和效率低下。所以我们使用集中化的日志管理,分布式日志就是对大规模日志数据进行采集、追踪、处理。(2)为什么要使用分布式日志一般我们需要进行日志分析场景:直接在日志文件中grep、awk就可以获得自己想要的信息。但在规模较大的场景中,此方法
elk笔记24--用gohangout替代logstash消费日志介绍使用gohangout使用gohangout前后对比注意事项说明介绍gohangout 是 childe 大佬使用 golang 模仿的 Logstash 开源项目。用于消费 Kafka 数据,处理后写入 ES、Clickhouse 等。 相对于elk 中官方提供的 logstash, 其可以更加高效的利用 cpu 资源、降低内
参考文章:【实验级】Docker-Compose搭建单服务器ELK伪集群了解了一些基础知识以后,我们来搭建ELK集群并模拟真实业务场景实验一下负载均衡日志的收集环境win10、8g内存(还是小了点,都爆红了,但还是能用的)wsl2 linux子系统ubuntu20.04docker-desktop安装elk集群和nginx负载均衡节点参考上方大神文章并做一些调整:(去掉了kafka部分,因为我把握
一.elasticsearch简介官网:https://www.elastic.co/cn/Elasticsearch 是一个开源的分布式搜索分析引擎,建立在一个全文搜索引擎库 Apache Lucene基础之上。Elasticsearch 不仅仅是 Lucene,并且也不仅仅只是一个全文搜索引擎:一个分布式的实时文档存储,每个字段 可以被索引与搜索一个分布式实时分析搜索引擎能胜任上百个服务节点的
1、 概述性能测试为了分析日志,统计性能指标需要安装ELK作为性能分析。filebeat :轻量级日志采集器;logstash:收集日志、解析过滤日志(logstash也可以收集日志但是其使用jvm资源消耗比较大)elasticsearch:存贮数据kibana:开源的分析与可视化平(kibana搜索、查看、分析存放在Elasticsearch中的数据)为了学习filebeat、logstash、
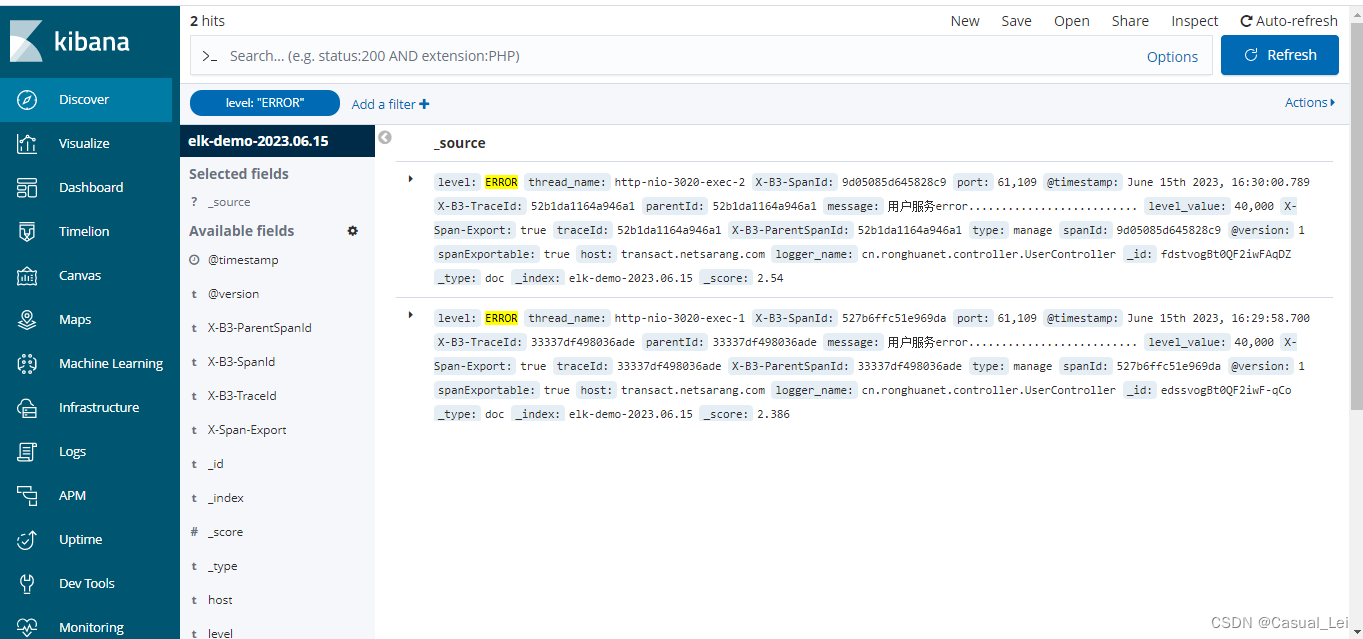
开头在分布式系统中,日志跟踪是一件很令程序员头疼的问题,在遇到生产问题时,如果是多节点需要打开多节点服务器去跟踪问题,如果下游也是多节点且调用多个服务,那就更麻烦,再者,如果没有分布式链路,在生产日志飞速滑动的情况下,很难找出问题。所以,分布式系统中很有必要搭建一套分布式日志系统,笔者采用了市面成熟的解决方案ELK+skywalking解决,本文将从0到1搭建一个分布式日志系统。效果先看效果图1.
ELKelk1.elk-环境初始化配置JDK安装elasticstack下载安装报错处理解决方案elk1.elk-环境初始化配置1.安装之前先将防火墙与selinux关闭,防止后期出问题2.创建目录用于存放软件包mkdir /opt/es-software/JDK安装3.查看现有JDK版本,并卸载rpm -qa |grep javarpm -e --nodeps java-1.8.0-openjd
CentOS 7安装elasticsearch6.5.4+logstash6.5.4并且使用java代码实现查询文章目录CentOS 7安装elasticsearch6.5.4+logstash6.5.4并且使用java代码实现查询1、环境准备1.1 创建普通用户1.2 安装jdk1.3 防火墙设置2、安装elasticsearch2.1 elasticsearch配置2.2 把elasticse
在日常的运维过程中,对系统日志和业务日志的处理比较重要,对于以后的数据分析、排查异常问题有很重的作用。今天就分享一个自己基于kafka+ELK+filebeat的日志记录分析平台。组件介绍ElasticsearchElasticsearch(ES)是一个基于Lucene构件的开源、分布式、RESTful接口全文搜索引擎。ES还是一个分布式文档数据库,其中每个字段均是被索引的数据且可被搜索,它能够扩
1.docker安装elasticsearchdocker pull elasticsearch:7.3.0后面最好带上版本号创建elasticsearch容器docker run --name es -p 9200:9200 -p 9300:9300 --network esnet -e "discovery.type=single-node" 镜像id启动/重启/停止:docker start
问题描述:对于免费版本的elk,默认情况会保留全部数据,导致数据列越来越多,如下3个月的累计数据量为27G,平均每月增加9G,需要定期清理elk日志;解决办法1)创建脚本vi rm_es_log.shchmod +x rm_es_log.sh默认只保留最近7天的日志,可以传入参数清理其他时间的日志;我的elasticsearch有权限控制,如果无密码方式登录,需要去掉-u参数#!...
elasticsearch启动的准备动作:#添加一个用户:elasticsearch$useradd elasticsearch#给用户elasticsearch设置密码,连续输入2次$passwd elasticsearch#创建一个用户组 esgroupadd es#分配 elasticsearch 到 es 组usermod -G elasticsearch es#这里注意下,如果提示用户“
elk + kafka 简单搭建日志分析系统文介绍使用ELK(elasticsearch、logstash、kibana) + kafka来搭建一个日志系统。想象一下淘宝,它可以对不同的用户实现推荐不同的产品,它主要是通过分析我们使用淘宝产生的日志来进行推荐的。对于比较小的项目,可以把日志储存到DB中。但是并发量高了怎么办?这时候出现了ELK,但是对于双11这种活动时,那么多人同时访问,单
最近项目准备用到elasticsearch, 首先需要搞清楚elasticsearch的一些概念,在网上发现这篇文章不错,以通俗易懂的语言讲明白了mapping的概念。默认mappingelasticsearch(以下简称ES)是没有模式(schema)的,当我们执行以下命令:[sql] viewplaincopy
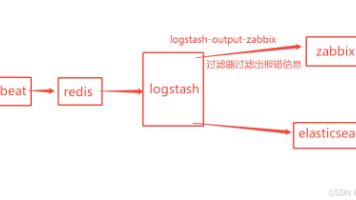
摘要:本文介绍如何通过logstash-output-zabbix插件实现ELK日志与Zabbix告警联动。首先安装插件并配置logstash,通过input接收日志源,filter解析日志字段并添加zabbix所需字段,output将含关键字的日志发送至Zabbix。然后在Zabbix创建对应模板、监控项和触发器,确保日志能被正常接收并触发告警。最终实现当ELK收集到含error等关键词的日志时
Windows ELK8 测试: filebeat8+kakfa+logstash8+elasticsearch8+kibana8 搭建日志系统(二)之加密1、elasticsearch 配置xpack2、重置下xpack 中的elastic用户密码**【重置前要先关闭http ssl认证】**3、重置下xpack 中的kibana用户密码**【重置前要先关闭http ssl认证】**4、启用xp
elk部署
• ./logstash –path.settings /etc/logstash/ -f /etc/logstash/conf.d/syslog.conf//这样可以在屏幕上查看到日志输出,不能敲命令。• /usr/share/filebeat/bin/filebeat -c /etc/filebeat/filebeat.yml //可以在屏幕上看到对应的日志信息。• ./logstash-pl
如果服务部署了几十台甚至上百台服务器,就要分别登录到这些台机器上看,这样大大的降低了我们的工作效率,等到了分布式和微服务架构流行时代,一个从APP或H5发起的请求除了需要登陆服务器去排查日志,往往还会经过远程软件远程到了别的主机继续处理,开发人员定位问题可能还需要根据TraceID或者业务唯一主键去跟踪服务的链路日志,基于传统SSH方式登陆主机查看日志的方式就像图中排查线路的工人一样困难,线上服务
生成一个logger对象交给spring容器管理。后面直接从容器取就可以了。
k8s中部署kafka-kraft模式集群,镜像构建到对外暴露
springcloud搭建elk日志管理
本文没开启证书,大家可以按需设置一、es集群配置es集群10.10.100.410.10.100.510.10.100.61、开启的配置如下(增加的配置参数)# /etc/elasticsearch/elasticsearch.ymlxpack.security.enabled: true2、重启es集群(三台都要操作)# systemctlrestart elasticsearch3、创建认证用
脚本安装elk1. 安装elasticsearch+filebeat+kibana(6.6.0)tar的安装包2. rpm的安装方式(elasticsearch+filebeat+kibana)6.8..01. 安装elasticsearch+filebeat+kibana(6.6.0)tar的安装包elasticsearch不能使用root用户所以我们使用的elk用户启动关闭pkill#!/bi
elk笔记22--通过api快速创建索引1 简介2 功能实现2.1 源码2.2 测试3 注意事项4 说明1 简介elk 是一个被广泛使用的日志检索系统,每次有新日志接入的时候,都需要一系列操作创建索引和kibana 配置。如果在企业中每次手动创建就显得很低效了,因此本文将相关操作封装成一个简单的python api,每次只需要传入指定的参数就可以快速完成索引创建和kibana 配置了。2 功能实现
1、日志文件准备首先日志集成json格式,这个在我搭建的项目案例中的logback-spring.xml中有过配置如何将日志转成json格式,具体参考gitee项目的logback-spring.xml配置,也可参考之前写过的一篇文章。2、安装filebeat在应用启动的机器上安装filebeat,将日志推送到kafka集群中...
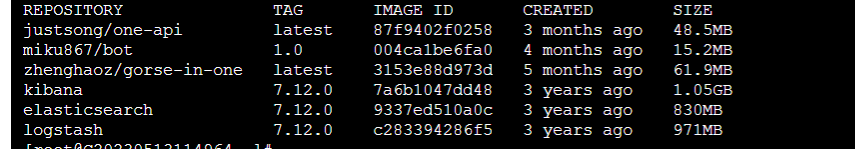
命令如下:#下载ELK使用的镜像docker pull elasticsearch:7.6.0docker pull kibana:7.6.0docker pull logstash:7.6.0docker pull mobz/elasticsearch‐head:5#安装elasticsearch,创建一个elk文件夹, 后面的elk日志采集系统的配置文件都放在这里面#创建elk使用配置文件的目
第一步: Create docker-compose.yml创建docker-合成.yml对于Docker Compose。Docker Compose是一个用于定义和运行多容器Docker应用程序的工具。通过下面的YAML文件,您可以通过一个命令创建和启动所有服务(在本例中是Apache、Fluentd、Elasticsearch、Kibana):version: '3'services:flu
Mac下elk、ElasticSearch logstash kibana安装与启动安装java8安装es(elasticsearch)安装logstash安装Kibana
环境介绍192.168.17.30 logstash192.168.17.31 elasticsearch192.168.17.32 kibana系统相关优化vim /etc/security/limits.conf* soft nofile 65536* hard nofile 131072* soft nproc 2048* hard nproc 4096vim...
#!/bin/bashshijian=`date +%Y.%m.%d -d "3 days ago"`curl -XDELETE "192.168.0.231:9200/filebeat-${shijian}"
elk
——elk
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 乐奇 Rokid 开放社区











 天工造物局