登录社区云,与社区用户共同成长
邀请您加入社区
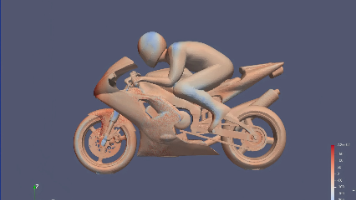
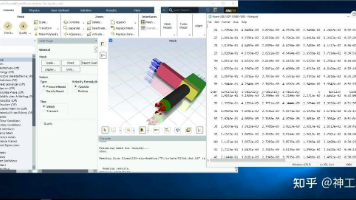
基于典型复杂外形外流场场景 —— “motorbike高速绕流” 算例,在多个主流仿真平台上开展了 OpenFOAM 求解效率的对比分析。
神工坊®技术团队基于典型复杂外形外流场场景 —— “motorbike高速绕流” 算例,在仿真平台上开展了 OpenFOAM 求解效率的对比分析。
本期我们选取风道流体仿真算例,看看基于SimForge™高性能工业仿真云平台的 Fluent 求解计算,与其他仿真云平台的效率差异究竟如何。
一个无向图称为弦图(chordal graph),如果它不包含长度≥4的无弦环。换句话说,任何长度的环都至少有一条对角线(弦)。消去树(elimination tree)是描述Cholesky分解中依赖关系的有向树(或森林):顶点集与矩阵相同对每个,如果且对所有,则是的父节点更简单的定义:顶点jj的父节点是预测填充,即通过符号分解提前知道L的非零模式减少填充,即通过图重排序算法优化消元顺序并行计算
本期选取了CFD领域的典型场景,稳态仿真计算案例——基于MRF方法的旋转机械流场分析,我们选用的软件是CFD领域最常用的仿真软件Fluent。
说到高性能计算,一般都是利用搭建集群配合加速卡做并行计算实现。但用相同的硬件实现更快的方法,那就是做测试了。比较有名的就是Linpack测试了。本文将谈到HPCC测试和NAMD测试。
在三维克希霍夫积分法深度偏移成像中,旅行时计算是核心环节,而振幅和相位信息的准确计算直接影响成像质量。这种方法的精度依赖于速度模型的准确性和高频近似有效性,对于复杂介质(如强横向变速),需结合波束偏移或全波形偏移(FWI)改进。克希霍夫偏移基于波动方程积分解,其核心是计算从震源到成像点再到接收点的旅行时场((\tau(x,z)))。其中 (v(x)) 为速度场。但仅旅行时不足以描述波场特性,需补充
Slurm 是一个开源、容错、高度可扩展的集群管理和作业调度系统,适用于大型和小型 Linux 集群。Slurm 的操作不需要修改内核,而且相对独立。作为集群工作负载管理器,slurm 有三个关键功能。首先,它在一段时间内为用户分配对资源(计算节点)的独占和/或非独占访问权,以便他们能够执行工作。其次,它提供了一个框架,用于在分配的节点集上启动、执行和监视工作(通常是一个并行作业)。最后,它通过管
本文主要介绍并行计算相关概念、并行计算条件、层次、并行计算机体系结构、并行程序设计基础等。
Intel MPI(Intel® MPI Library)提供了丰富的环境变量,用于控制运行时行为、性能调优、调试、资源分配等。调试级别(0-1000+),值越高输出越详细。是否尊重作业调度器的进程放置(SLURM 等)。指定 mpirun 启动进程时使用的网络接口。手动指定进程绑定到的 CPU 列表(如。启用兼容模式(如与 MPICH 兼容)。指定 TCP 通信使用的网络接口(如。控制共享内存通
CAE技术在无人机领域的应用,为无人机的设计与制造提供了强大的支持,同时也为低空经济的发展添砖加瓦。
异构计算是指将不同类型的处理器(如CPU、GPU、FPGA等)组合在一个计算系统中,充分发挥各处理器的独特优势,以实现更高的计算性能和能效比。
SM是streaming multiprocessor的简写,4个处理单元组成一个SM,如Figure 2。每个SM有64个INT32,64个FP32,32个FP64的CUDA core;每个SM还有4个Tensor Core。SM内共享L1缓存。CUDA Core是用作通用计算的,Tensor Core是专门针对深度学习优化的,负责矩阵运算、混合精度运算。Figure 1Figure 3展示了N
(openmpi官方指导版本,有问题,待解)2路cpu,8A100卡。
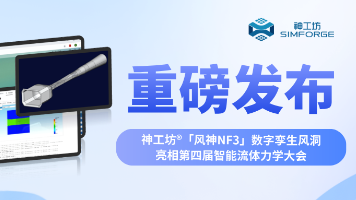
神工坊®江苏省重点研发计划(No. BE2022050)项目成果——数字孪生风洞「风神NF3」正式发布!本次发布会向业界展示了「风神NF3」高保真、高效率与高易用性的突破性进展,标志着数字风洞技术步入规模化产业应用的新阶段。
本文深入解析了在HPC环境中Singularity相比Docker的优势,包括无需特权运行、与主机文件系统无缝集成以及对MPI的原生友好支持。文章提供了在CentOS 7.9系统上从环境准备、依赖安装到编译部署Singularity的完整实战教程,帮助科研人员和系统管理员在受控集群环境中高效部署和使用容器技术。
本文探讨了在HPC环境中推荐使用Singularity而非Docker的核心原因,包括权限模型、安全性和与调度器的集成优势。文章提供了在CentOS7.9系统上从源码编译安装Singularity的详细实战教程,帮助用户在高性能计算场景下高效部署和使用容器技术。
构建“环境即代码(EaC)”全栈交付体系,用户只需提交一份YAML声明,标注镜像、依赖、硬件规格等信息,平台便自动完成环境拉取、资源预分配,以及JupyterLab、VS Code Server等IDE的秒级实例化,彻底告别繁琐配置。在科研创新冲刺、工业仿真提速的当下,高性能计算(HPC)早已成为不可或缺的核心基础设施,但传统HPC架构存在资源浪费、配置耗时、调度卡顿、运维繁琐等问题,这些瓶颈不仅
Serverless计算和HPC(高性能计算)是当前数据处理领域的两大关键技术。Serverless以其弹性伸缩和按需付费的特性,显著降低了运维成本;而HPC则通过并行计算提供极高的处理性能。Cylon架构创新性地将两者结合,利用NAT穿透技术解决了Serverless函数间通信的高延迟问题,实现了接近裸机性能的分布式数据处理。该架构特别适用于基因组测序、天文观测等需要处理海量数据的场景,通过统一
容器技术通过封装应用及其依赖,实现了环境一致性与可移植性,其核心原理在于利用Linux内核的命名空间和控制组(cgroups)进行资源隔离。在科学计算与工程领域,这一技术价值尤为凸显,它能够确保复杂软件栈在不同计算环境中的稳定复现。然而,通用容器方案在高性能计算(HPC)、人工智能模型训练等场景下面临着性能损耗、权限管理复杂以及与宿主机硬件(如GPU、高速网络)集成度低的挑战。为此,专为高性能计算
高性能计算(HPC)与云原生技术的融合是当前云计算领域的重要趋势。传统HPC应用迁移到云平台时,常面临资源调度僵化、性能难以保障等挑战。通过引入智能体(Agent)技术,构建感知-决策-执行闭环,能够实现对HPC应用全生命周期的自主管理。这种智能体编排模式,结合Kubernetes生态和Volcano批处理调度器,可动态适配云上高性能实例、InfiniBand网络等基础设施,在保障计算效率的同时,
容器技术通过封装应用及其依赖环境,解决了软件部署中的依赖冲突和环境一致性问题,其核心原理是基于操作系统层面的虚拟化实现资源隔离。在科学计算和高性能计算领域,这一技术价值尤为突出,能够确保计算过程的可重复性并简化复杂软件栈的部署。针对HPC环境对安全性和高性能的特殊需求,Singularity容器应运而生,它允许用户在无需root权限的情况下运行容器,并可直接集成宿主机的GPU、高速网络等硬件资源。
在高性能计算(HPC)领域,单元测试面临并行编程带来的独特挑战,如非确定性行为和同步问题。OpenMP和MPI等并行编程模型使得传统测试方法难以应对数据竞争和死锁等问题。HPCAgentTester通过多Agent协作架构,结合静态分析和动态检测技术,有效提升了测试覆盖率和准确性。该系统特别适用于气象模拟、分子动力学等需要高并行度的科学计算场景,能够自动识别并测试常见的并行编程错误模式,如MPI通
本文介绍了如何使用Singularity定义文件(Definition File)一键复现机器学习环境,解决环境配置冲突问题。通过详细解析Singularity的核心优势、定义文件语法及实战案例,帮助开发者快速构建标准化、可复现的机器学习环境,特别适合HPC场景下的科学计算需求。
在数据密集型科研领域,数据治理的核心挑战在于实现数据的可查找、可访问、可互操作与可重用,即FAIR原则。其技术原理在于通过语义网技术,特别是领域本体,为数据赋予机器可理解的标准化含义,从而打破数据孤岛。这为数据集成、自动化分析与AI模型训练提供了坚实基础,尤其在需要处理复杂、大规模数据集的高性能计算场景中价值显著。本文聚焦于HPC领域,通过引入HPC本体对数据进行语义标注,并采用F-UJI自动化工
在数据密集型的高性能计算(HPC)和机器学习(ML)领域,数据资产的管理与共享是提升研究效率和可复现性的核心挑战。FAIR原则(可发现、可访问、可互操作、可重用)为解决这一问题提供了系统性的指导框架。其核心在于通过持久标识符(如DOI)和丰富的元数据实现数据的可发现性,并利用领域本体(如HPC Ontology)对数据进行语义化标注,从而实现机器可理解的互操作性。这不仅大幅降低了数据复用的门槛,也
高性能计算(HPC)作为解决复杂科学问题的关键技术,其核心在于并行计算架构与优化方法。ARM架构凭借多核设计与高内存带宽优势,在计算密集型场景中逐渐崭露头角。以华为鲲鹏920处理器为例,其采用的ARMv8架构通过NUMA优化、专用指令集等技术,可显著提升气象预测、分子动力学等领域的计算效率。在工程实践中,从编译器优化(如毕昇编译器)、并行库适配到任务调度策略的全链路调优尤为关键。通过WRF气象模型
科学计算作为高性能计算(HPC)的核心领域,通过浮点运算解决连续数学问题,在计算精度和规模上具有严苛要求。其技术原理涉及数值分析、并行计算和算法优化,支撑着从物理模拟到生物信息学的关键突破。随着AI与HPC的深度融合,如AlphaFold2等应用展现了机器学习对科学计算的革命性提升。当前科学计算已形成计算物理学、计算生物学、计算化学和地球系统建模四大支柱领域,在天气预报、基因测序、新药研发等场景发
神经架构搜索(NAS)作为自动化机器学习的关键技术,通过算法自动设计神经网络架构,大幅提升模型开发效率。其核心原理是通过搜索算法在预定义的搜索空间中探索最优架构,涉及进化算法、强化学习等技术路径。在HPC(高性能计算)环境中部署NAS面临资源分配、通信效率等独特挑战,需要结合RDMA、拓扑感知等优化手段。本文以生物医药图像分析为应用场景,详细解析如何改造ENAS算法以适应超算环境,实现92%的GP
在云计算与高性能计算(HPC)融合的背景下,资源编排技术成为提升计算效率与降低成本的核心。其原理在于通过自动化工具对计算、存储和网络资源进行统一调度与管理,以应对弹性、异构的云环境。这一技术的核心价值在于解决传统HPC应用在云上运行时的资源管理复杂性与成本控制难题,广泛应用于科学计算、工程仿真和AI训练等计算密集型场景。其中,基于Kubernetes的增强调度器(如Volcano)和智能体(Age
SIMFORGE FanVLab 风扇虚拟试验室 现已正式上线 SimForge™ 高性能仿真云平台,诚邀您体验这款专为工业风扇仿真打造的轻量化CFD工具。
1. 压力方程求解器的选择与优化代数多重网格法(AMG)压力方程(泊松型)的求解通常占主要计算时间,AMG对这类椭圆型方程具有最优的收敛速度(接近O(n))。优先选用基于AMG的求解器(如Hypre、PETSc或开源库AMGCL)。调整AMG参数:粗化策略(Ruge-Stuben或PMIS)、平滑迭代次数(通常1-2次Gauss-Seidel)、循环类型(V-cycle比W-cycle更快)。Kr
本文主要研究测试abaqus-2022如何在Linux并行计算集群安装与简单使用。
本文详细介绍了生产级轻量Slurm集群的搭建流程。集群采用标准架构,包含控制节点、计算节点、登录节点和存储节点,支持x86_64架构的CPU/GPU节点。搭建过程分为七个步骤:1)存储节点搭建NFS共享存储;2)控制节点安装MySQL、Slurm核心服务并配置调度系统;3)计算节点部署slurmd服务;4)登录节点配置用户环境;5)集群功能验证;6)日常维护命令;7)生产优化建议。关键配置包括Mu
本文主要介绍,主流CAE仿真软件,如大型有限元分析软件ANSYS FLUENT、ANSYSMECHANICAL、ANSYSCFX、ANSYSLS-DYNA,ABAQUS、HFSS、NASTRAN、CST、STAR-CCM+、NUMECA、FEKO、COMSOL在HPC或Linux并行计算集群上如何使用pbs或slurm作业调度系统脚本提交作业以及如何使用软件在命令行提交作业,旨在帮助初入科研行业的
关于OpenLavaOpenLava是100%免费、开源、兼容IBM® Spectrum LSFTM的工作负载调度器,支持各种高性能计算和分析应用。伴随成千上万次的下载和安装,OpenLava的可扩展性和健壮性已经在拥有数十万个内核和和几百万作业的集群上得到了验证。由于OpenLava的命令行和文件格式与大多数LSF功能相兼容,因此用户和管理员都将非常熟悉OpenLava的操作。组织和
本文主要介绍Gaussian软件在Linux或HPC并行计算集群上安装与使用,Gaussian是做半经验计算和从头计算使用最广泛的量子化学软件,可以研究分子能量和结构、过渡态的能量和结构、化学键以及反应能量、分子轨道、偶极矩和多极矩、原子电荷和电势、振动频率、红外和拉曼光谱、NMR、极化率和超极化率、热力学性质、反应路径等。
本文主要介绍了分子动力学模拟软件GROMCAS的作用及特性,详细安装步骤等。
本文深入解析Dragonfly拓扑中UGAL路由算法的实战配置与调优,针对对抗性流量导致的网络性能问题,详细探讨了UGAL-G与UGAL-L的核心差异、虚拟通道配置、偏移常数T的动态调整策略以及缓冲区与信用延迟机制的协同优化。通过实际案例和配置示例,帮助网络架构师在高性能计算集群中实现负载均衡和性能提升。
工业仿真从来不是单兵作战——复杂模型的多方协作、海量数据的跨团队流转,才是研发场景的常态。为此,SimForge™平台推出「共享空间」功能,打破传统孤岛式研发模式,为仿真团队构建云端协同中枢,让数据流转与知识沉淀更安全、更智能。
GPT系列、BERT等AI大模型,以其在自然语言处理、计算机视觉等多个领域的卓越表现,成为了当今人工智能领域的焦点。这些模型通过海量的数据进行训练,能够学习到复杂的模式和语义信息,从而在各种任务中展现出惊人的泛化能力。要将这些大模型成功应用到实际场景中,从模型的训练到部署,每一个环节都面临着严峻的挑战。高性能计算HPC作为一种强大的计算手段,为解决AI大模型应用落地提供了可能。
是由法国数据分析公司QuantStack主导维护的一套现代 C++ 数值计算生态开源组织,对标 Python NumPy、MATLAB、Eigen,但更侧重现代 C++、向量化 SIMD、零开销抽象、跨平台、高性能科学计算。官网:https://github.com/xtensor-stack把 Python 式简单易用的数组语法,搬到高性能 C++,兼顾易用性 + 极致性能。
prerequisite 中也有操作;
HPC
——HPC
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 乐奇 Rokid 开放社区
 天工造物局



 DAMO开发者矩阵




 亚马逊云科技技术品牌专区


 码道开发者社区




 脑启社区
 AtomGit开源社区
 AMD开发者中国社区