登录社区云,与社区用户共同成长
邀请您加入社区
Spring中使用MDC和traceId实现日志链路追踪
druid 的LogFilter 为我们准备了四种logger类型,对应打印 datasource相关、connection相关、statement相关、resultset相关的日志。druid.sql.Connection:打印应用程序获得数据库连接的过程。druid.sql.Statement:打印静态 SQL 语句相关的内容。druid.sql.Datasource:打印数据源相关的字段。d
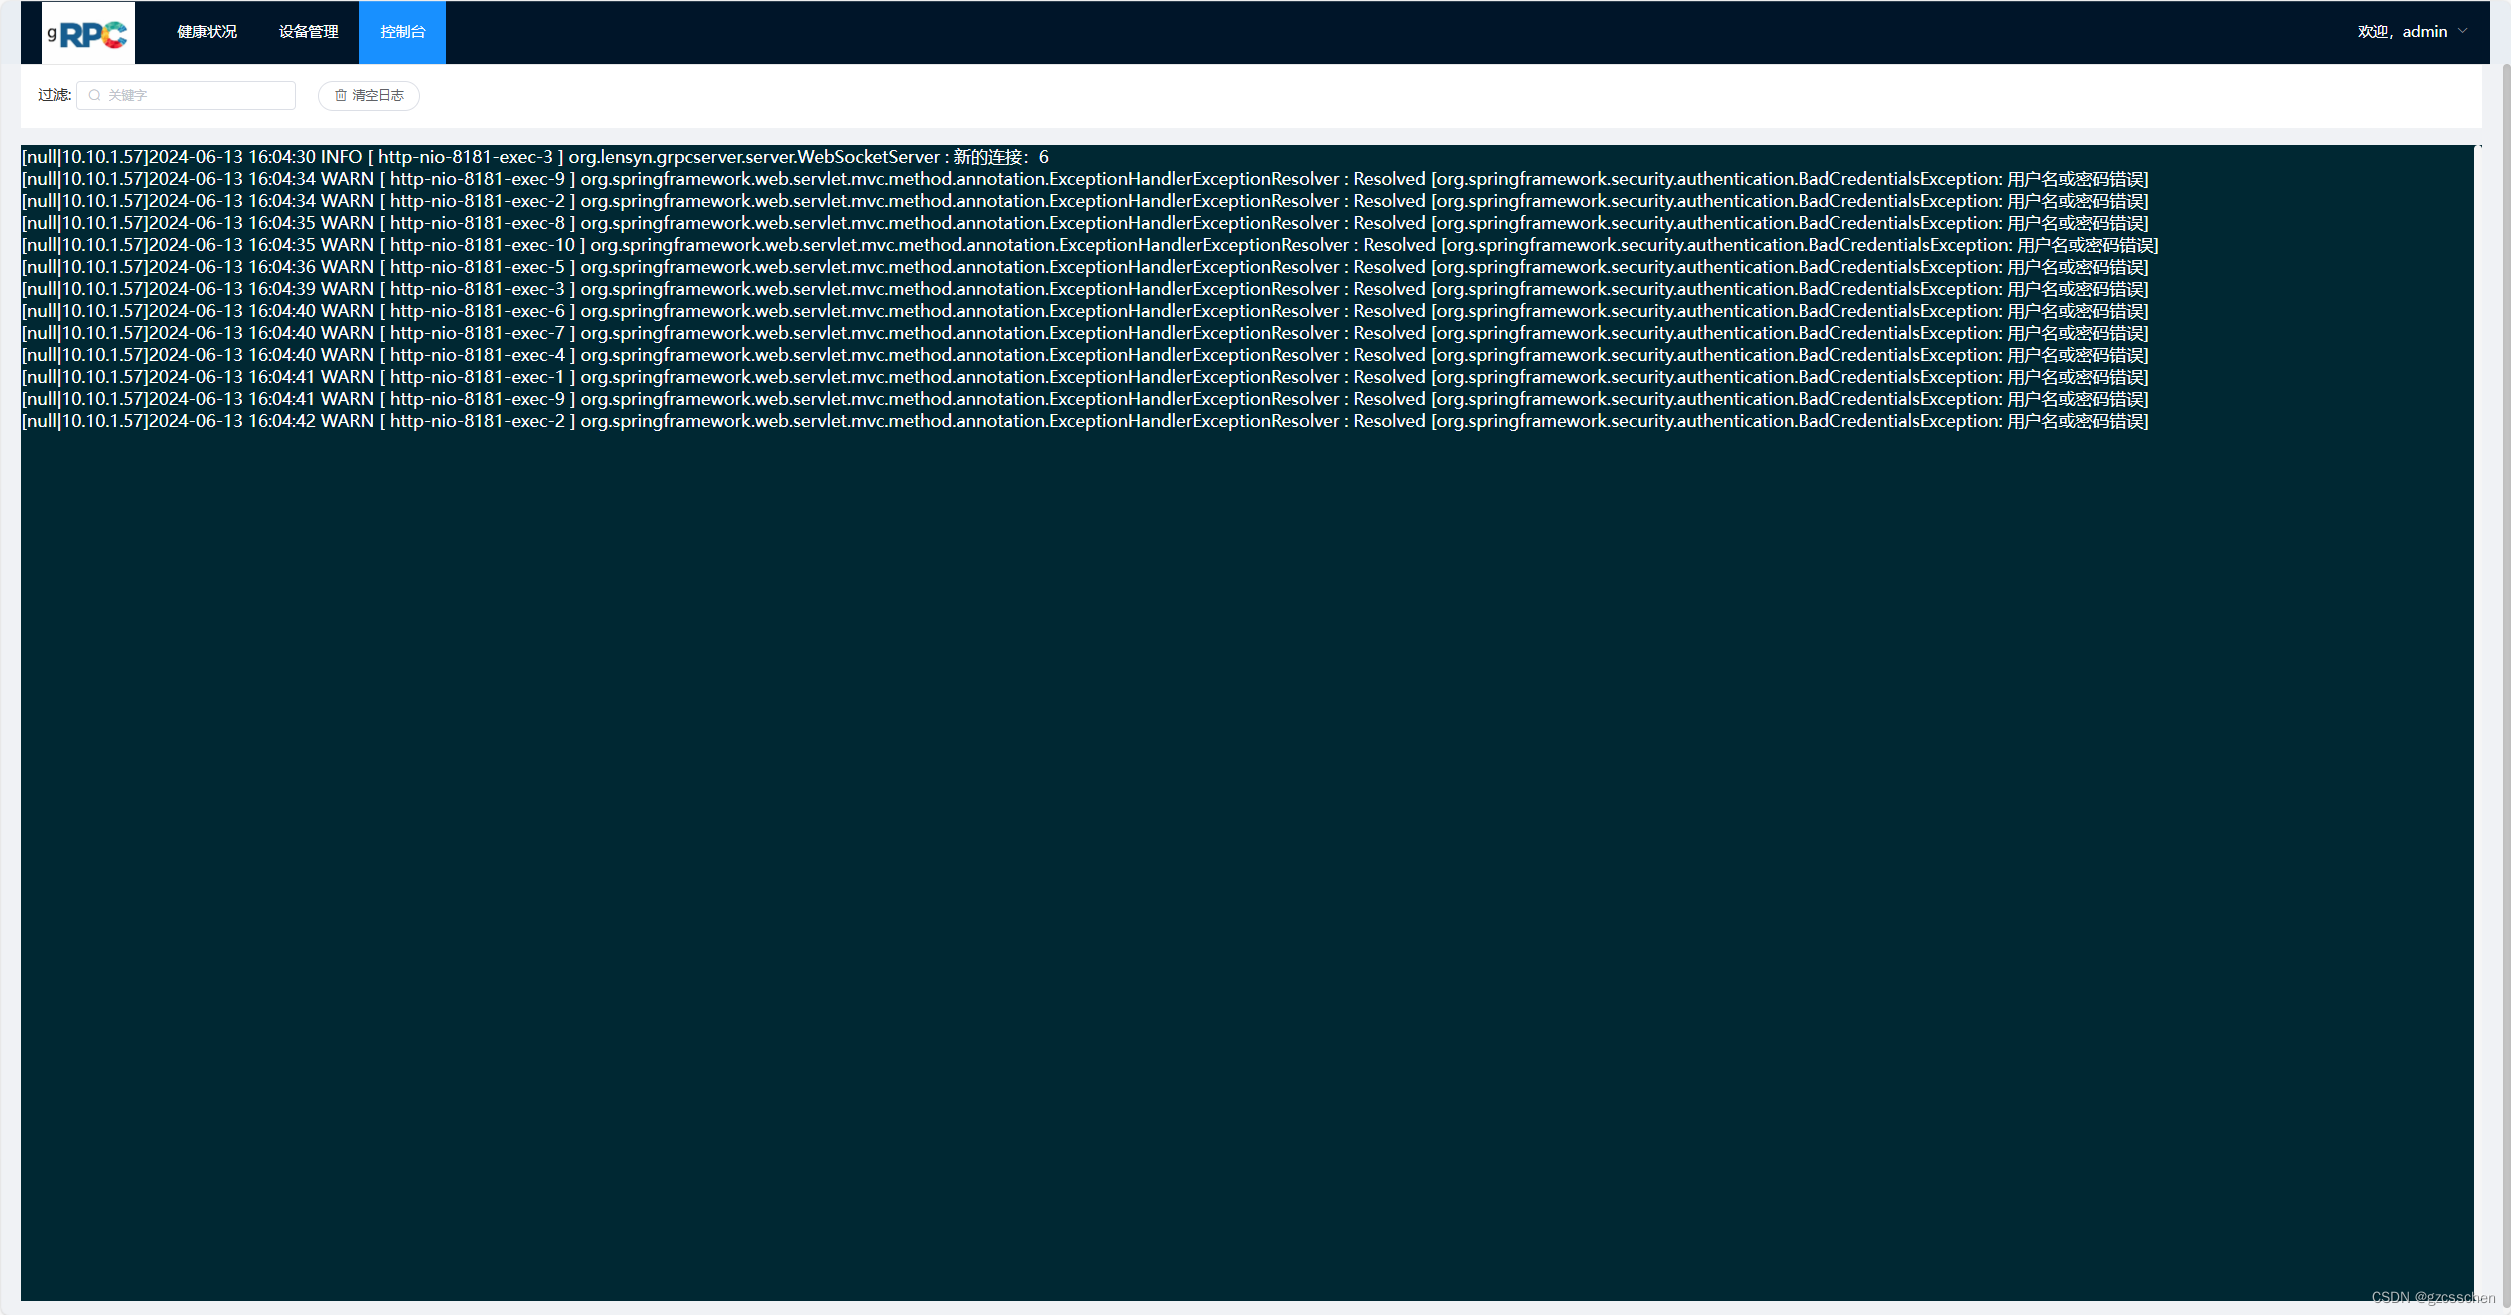
logback 实现自定义appender,把日志内容通过websocket推送到页面显示,因为考虑到服务会部署多个节点的情况下,页面前端要展示所有节点的日志,所以采用每个节点的日志发送到kafka,然后kafka的消费端,再通过websocket 发送到页面进行滚动显示。
接下来真正的实现当然是放在agent里面去做的首先去继承/*** issue.* *//***/@Override/***/@Override/***/@Override@Override@Override@Override这里主要定义agent要增强哪个类、哪个方法。比如这里就通过定义增强类,定义增强的方法之后再配置类中添加这个类拦截class就是配置我们下面要写的也就是真正的实现类。
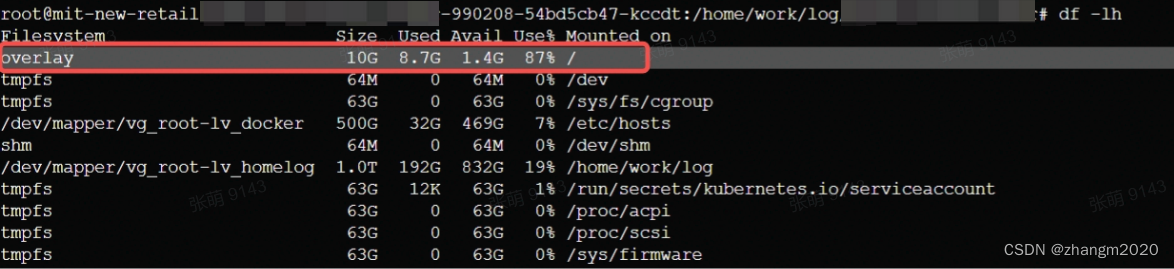
线上的服务突然内存爆满,查服务器突然发现,日志全部打印到了/tmp/tomcat.xxx.port目录下,后来对应操作时间,和nacos修改配置是同一时间发生的,但是疑惑的点是,nacos配置变更为什么会引起logback的日志打印目录突然切换,以下是分析结论和原理。
accesslog追踪请求日志applog追踪服务内部日志response返回traceId用于debugzipkin用于监控
【代码】logback 问题 ch.qos.logback.core.joran.spi.JoranException: Parser configuration error occurred。
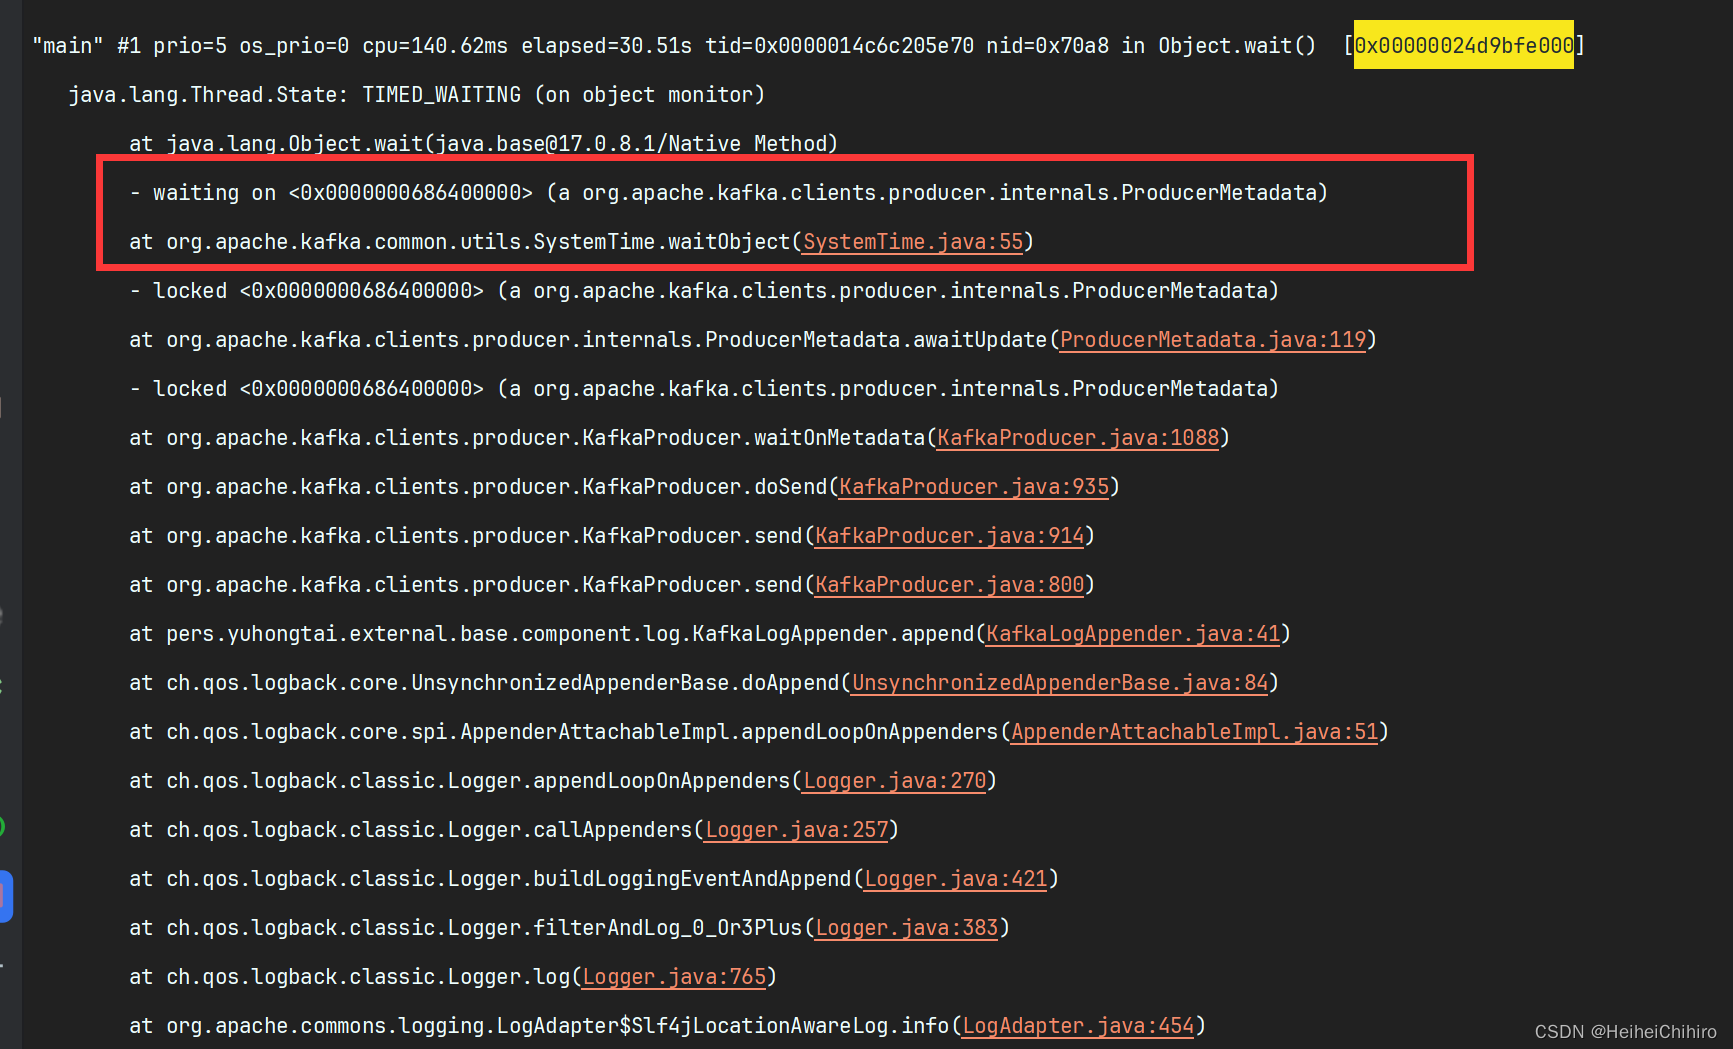
自定义同步kafkaAppender时,发生springboot启动死锁,排查及解决
查看自定义客户端日志配置,分为两步第一步,配置rocketmq.client.logUseSlf4j=true启动参数 添加: -Drocketmq.client.logUseSlf4j=true 【推荐】或者启动类添加:System.setProperty("rocketmq.client.logUseSlf4j","true")第二步,配置logback日志配置检查项目中的配置第一步,配置在a
【代码】Caused by: java.lang.ClassNotFoundException: ch.qos.logback.core.joran.spi.JoranException。
服务器上部署项目,Log4j日志中文乱码。本地运行没有问题,SpringMVC + Maven项目
1 agent探针配置1.1 agent探针目录将 D:\Soft\apache-skywalking-apm-bin\agent 目录拷贝到 E:\agent ,保持目录结构不变1.2 修改探针agent.config修改探针服务名称# The service name in UIagent.service_name=${SW_AGENT_NAME:chy-server}2 增加skywalki
Logback通过mdc实现日志链路追踪
logback将日志通过logstash传输到elasticsearch
下载skywalking官方地址部署skywalking解压apache-skywalking-apm-8.3.0.tar.gz启动apache-skywalking-apm-bin\bin\startup.bat生产环境,需要把数据保存EShttp://localhost:8080/整合项目启动idea 启动命令添加-javaagent:D:\shitou\envir\apache-skywal
前置条件:需要安装skywalking-aop 与skywalking-ui, 并配置aop使用的数据源(es/mysql/H2等).注:安装配置过程不在此赘述.1.引入POM 用于输出业务日志到skywalking<dependency><groupId>org.apache.skywalking</groupId><artifactId>apm-
一、log4j作为日志打印降级方法继承org.apache.log4j.Logger类,重写里面的isDebugEnabled、getEffectiveLevel及getLogger三个方法log4j配置文件指定好日志处理类在程序启动时,log4j将利用配置中指定日志处理类,放入缓存。当logFlag的标识来判断是否打印debug日志。二、logback日志降级方法继承日志过滤器TurboFilt
一、问题背景最近改造以前的老项目,将disconfig丢弃掉。引入了Apollo进行集体管理所有项目的配置文件。日志配置文件 logback.xml中有一些值需要从配置中心获取二、解决方法(1)修改application.xml中的配置apollo :meta : http://127.0.0.1:8080bootstrap :enabled : truenamespaces : applicat
Logback通过rabbitmq发送日志到Logstash前言新的改变功能快捷键合理的创建标题,有助于目录的生成如何改变文本的样式插入链接与图片如何插入一段漂亮的代码片生成一个适合你的列表创建一个表格设定内容居中、居左、居右SmartyPants创建一个自定义列表如何创建一个注脚注释也是必不可少的KaTeX数学公式新的甘特图功能,丰富你的文章UML 图表FLowchart流程图导出与导入导出导入
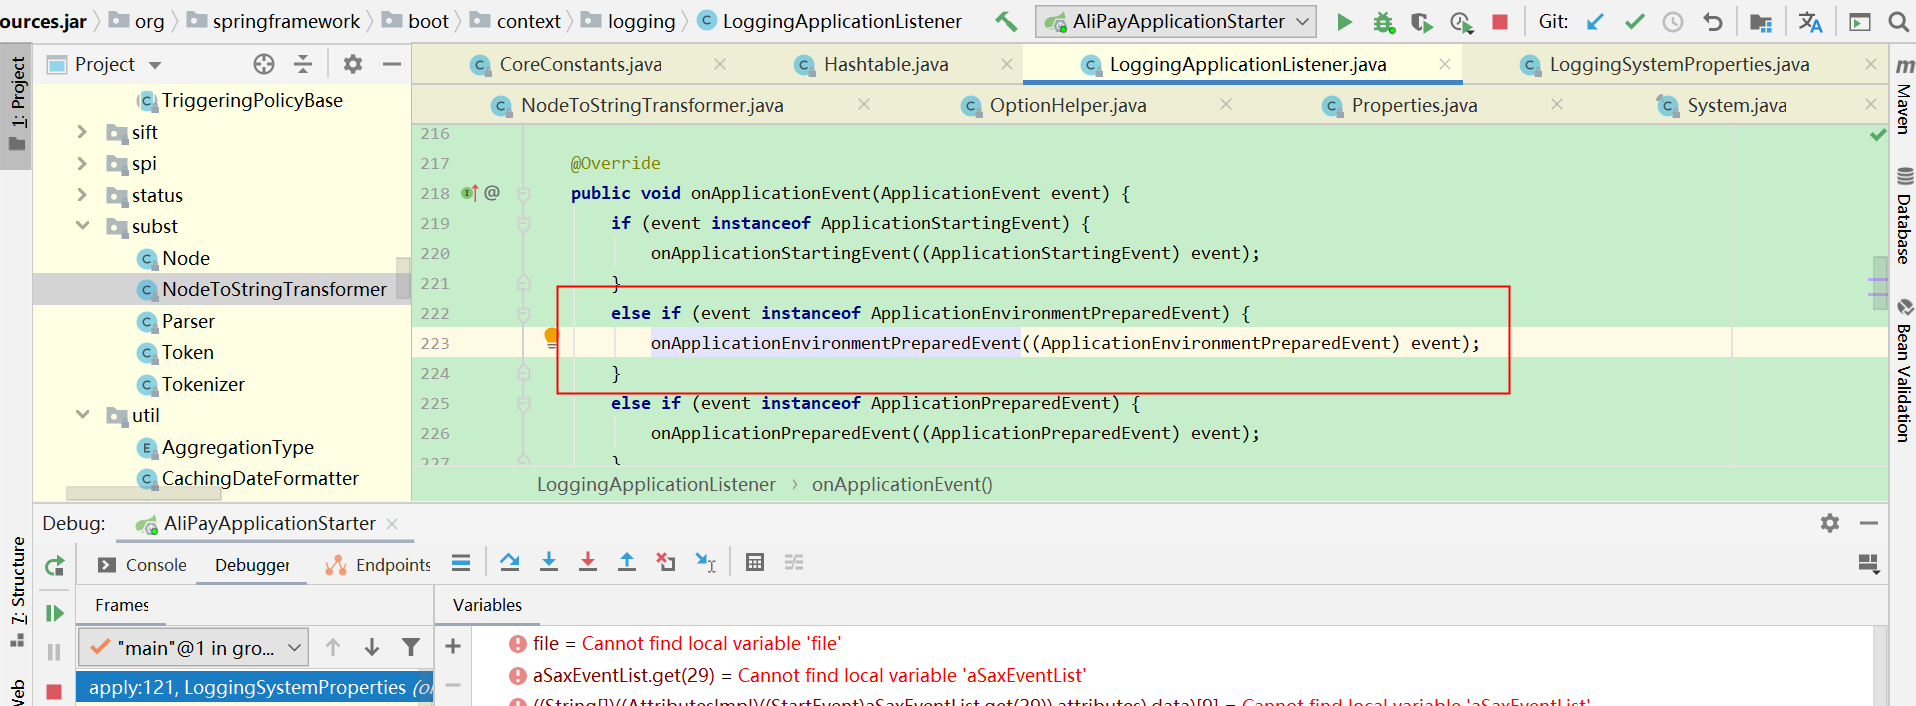
springboot+mybatis+druid+logback启动时出现一个error:load filter error, filter not found : logback,但不影响程序启动。经过查看druid源码,发现是druid过滤器配置错误造成的,druid支持的过滤器类型在duid-filter.properties中如下:druid.filters.default=com.ali
前言我们通过skywalking来查看我们应用的性能,有时看到哪个请求较慢时,我们想看下请求参数。有时候需要打印traceId到我们的日志中,通过elk根绝traceId查询日志详情,面对着这两场景,记录下解决方案。上报请求参数给sky引入pom<dependency><groupId>org.apache.skywalking</groupId><art
1 修改logback配置文件1)在你的logback配置文件中,加上scan="true",用于配合配置中心(spirng-cloud-config )实现手动降级开关;logback会自动扫描配置文件的变更并更新,默认一分钟扫描一次,可以修改扫描周期;如果更改后的配置文件有语法错误,则会回退到之前的配置文件;2)在你的logback配置文件中,引入异步非阻塞队列的logback实现AsyncA
八大基础排序和基础的数据结构冒泡排序思路:俩俩交换,大的放在后面,第一次排序后最大值已在数组末尾。因为俩俩交换,需要n-1趟排序(比如10个数,需要9趟排序)代码实现要点:两个for循环,外层循环控制排序的趟数,内层循环控制比较的次数。每趟过后,比较的次数都应该要减1选择排序思路:找到数组中最大的元素,与数组最后一位元素交换。当只有一个数时,则不需要选择了,因此需要n-1趟排序...
一、文档地址logstash插件grok地址:https://www.elastic.co/guide/en/logstash/7.6/plugins-filters-grok.html正则在线调试:http://grokdebug.herokuapp.com/官方预定义的 grok 表达式:https://github.com/logstash-plugins/logstash-pa...
java.lang.NoClassDefFoundError: ch/qos/logback/core/joran/spi/JoranException
报错信息Caused by: java.lang.IllegalStateException: Could not initialize Logback logging from classpath:logback-spring.xmlat org.springframework.boot.logging.logback.LogbackLoggingSystem.loadConfigur...
1、在apollo配置中心添加logback-config.properties配置文件2、项目的application.yml配置文件配置如下,主要是eagerLoad.enabled: true这个配置app:id: SX-sale-app-soaapollo:bootstrap:enabled: true#将Apollo配置加载提到初始化日志系...
首先继承 logback 中的 ch.qos.logback.core.UnsynchronizedAppenderBase 类public class MongoDBAppender extends UnsynchronizedAppenderBase<ILoggingEvent> {@Overrideprotected void append(ILoggin...
springboot logback从配置中心读取环境ScenDemoApplication.javapackage com.wq.image;import com.ctrip.framework.apollo.Config;import com.ctrip.framework.apollo.ConfigService;import com.ctrip.framework.apollo...
一、前言这篇文章https://www.jianshu.com/p/9be945a1c318中我详细描述了Spring Boot中如何配置logback日志。在最近的项目中,有这样一个需求:日志信息要使用日志搜集模块进行收集并存入mongodb数据库,所以在日志配置文件中我们必须传入mongodb的配置信息。二、解决问题官网描述根据官网的描述可以得到这样的信息:log...
1、创建一个maven工程2、添加所需的jar包我是在maven工程下pom.xml》dependencies》add 搜索添加的这里版本不能搞错,slf4j1.8和logback-classic不搭的如下面的错误信息,就是slf4j的版本问题了SLF4J: No SLF4J providers were found.SLF4J: Defaulting to no-operation (N
看了很多网上的其他博客,感觉这配置上的坑好多,一天下来踩了很多坑,我写这篇博客就是为了防止大家继续掉坑里用的。废话不多说,我们进入正题。(java环境自己之前配置好,这我就不讲了)1.logstash的安装:wget https://download.elastic.co/logstash/logstash/logstash-2.2.0.tar.gztart zxvf logs
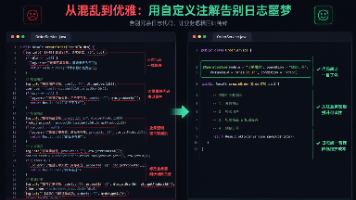
操作日志和业务代码耦合太深?本文拆解注解 + SpEL 的核心原理,手把手带你接入两个开源项目,让你的日志代码从此清爽
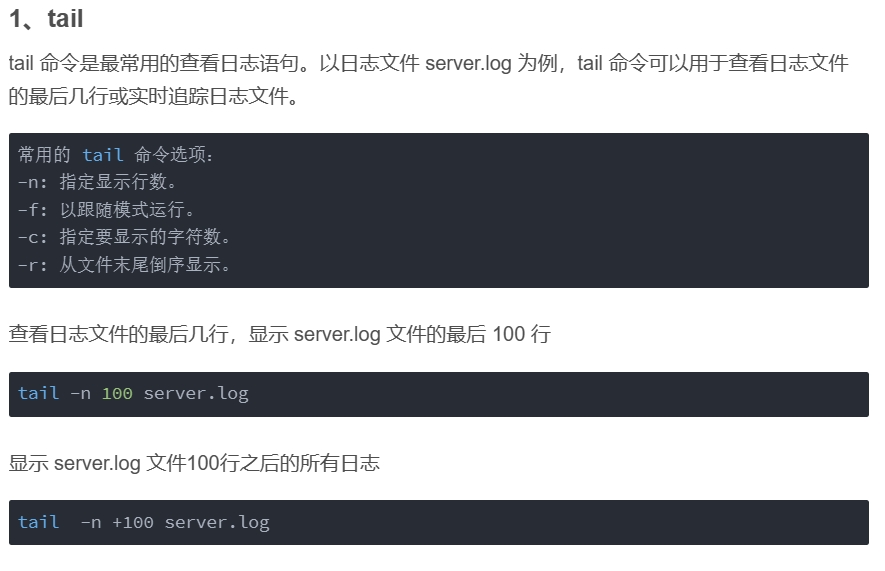
Linux查看log日志
logging.file和logging.path【java 日志 logback、log4j】
logback的基本使用就不说了,说说写这片文章的背景,之前做过一个分布式离线调度平台,简单来讲就是跑定时任务的,但是支持的任务类型有多种,不仅仅是Java定时任务,每个任务在跑的时候都会产生一些日志,这些日志要展现在页面给用户看,以便查看任务运行时的一些信息,方便排错,一般的我们可能会想到吧日志采集上来存到es里面,然后页面直接查询es,但是这样会增加依赖,于是就想到把日志存在机器上,页面访问的
spring 单元测试为 logback 添加环境变量
参考博客NO.1 Spring Boot干货系列:(七)默认日志logback配置解析 【作者:嘟嘟MD】NO.2 Java日志框架SLF4J和log4j以及logback的联系和区别NO.3 SLF4J和Logback和Log4j和Logging的区别与联系 1. 为什么需要日志对于程序的运行状态进行监控和行为分析当程序运行出错时,快速定位问题的位置2. 日志能做...
一.加入janino依赖&amp;amp;lt;dependency&amp;amp;gt;&amp;amp;lt;groupId&amp;amp;gt;org.codehaus.janino&amp;amp;lt;/groupId&amp;amp;gt;&amp;amp;lt;arti
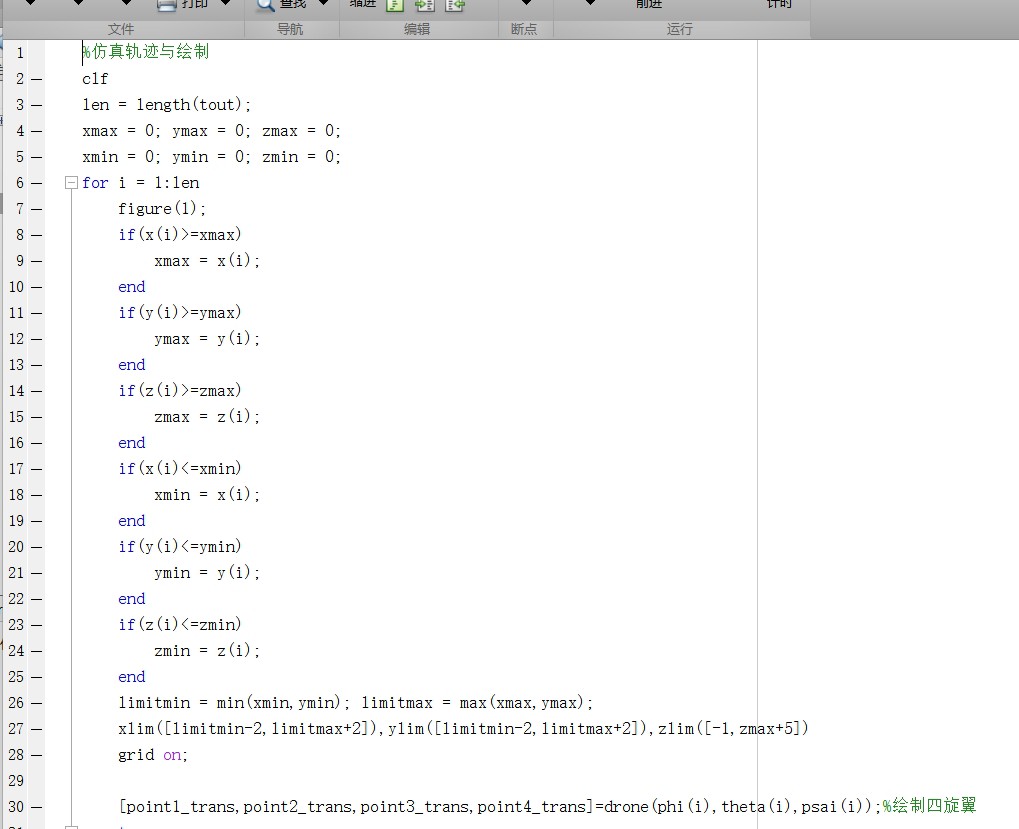
通过这次仿真,我们看到了PID控制在四旋翼无人机轨迹跟踪中的高效应用。PID控制凭借其简单的结构和良好的控制效果,仍然在无人机控制中占据重要地位。然而,随着无人机任务复杂度的增加,单纯依赖PID控制可能难以应对复杂的动态环境和多目标优化问题。未来可以尝试引入改进型控制算法,如模糊PID、滑模控制或基于模型预测控制(MPC)的方法,进一步提升控制性能。无人机的飞行控制是一门既有技术深度又充满创意的学
SLF4J(Simple Logging Facade for Java)是一个Java日志门面框架,提供统一的日志接口。
虽然对于oom尤其是线上oom这样的问题大家都唯恐避之不及,但是既然遇到了,也不妨当做是提升自己的一次机会。背景:生产应用从上午开始陆续开始报出cms老年代的使用率超过95%的告警从图上可以看到在短短的一个钟内老年代频繁地进行gc,内存高点一直在100%左右徘徊。定位过程:1、第一反应是先咨询了运维同事,发现监控平台上并没有集成内存...
jstack 分析 logback 的 坑,零点超时
本项目围绕大功率H桥电机驱动板电路设计展开,基于STM32F10x系列微控制器,采用IR2103S驱动芯片与N-MOS管构建H桥电路,实现对大功率直流电机的高效驱动与精准控制。代码体系涵盖底层核心驱动、硬件外设控制、通信交互等多个层面,共计75个文件,形成了一套完整的电机控制解决方案,可满足电机转速调节、转向控制、状态监测等核心需求,适用于工业自动化、智能设备等对电机控制精度和功率有较高要求的场景
在深度学习项目的完整生命周期中,模型的训练仅仅是第一步。如何将训练好的模型高效、稳定地部署到实际的生产环境中,是决定其最终价值的关键环节。基于PyTorch的模型部署,是指将研究人员或工程师在PyTorch框架下开发并训练成功的模型,转换成一种可以脱离研发环境、在特定硬件和软件平台上进行推理服务的形态。这一过程的核心目标在于实现低延迟、高吞吐量的预测服务,同时保证服务的稳定性和资源利用效率。
通过容器化部署与性能优化,Tomcat不仅能实现高效资源管控,更能突破传统虚拟化环境的局限,为微服务架构提供更敏捷的部署与更稳定的服务能力。例如,通过监控Tomcat线程池利用率设置扩缩策略,资源模板中定义CPU阈值与Pod数量的弹性范围,确保服务在流量突增时快速响应。通过Docker技术,将Tomcat与应用打包为标准化容器镜像,实现环境一致性。例如,基于Alpine Linux的轻量化镜像可减
logback
——logback
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 天工造物局









 DAMO开发者矩阵

 AtomGit开源社区




 码道开发者社区
 亚马逊云科技技术品牌专区
