登录社区云,与社区用户共同成长
邀请您加入社区
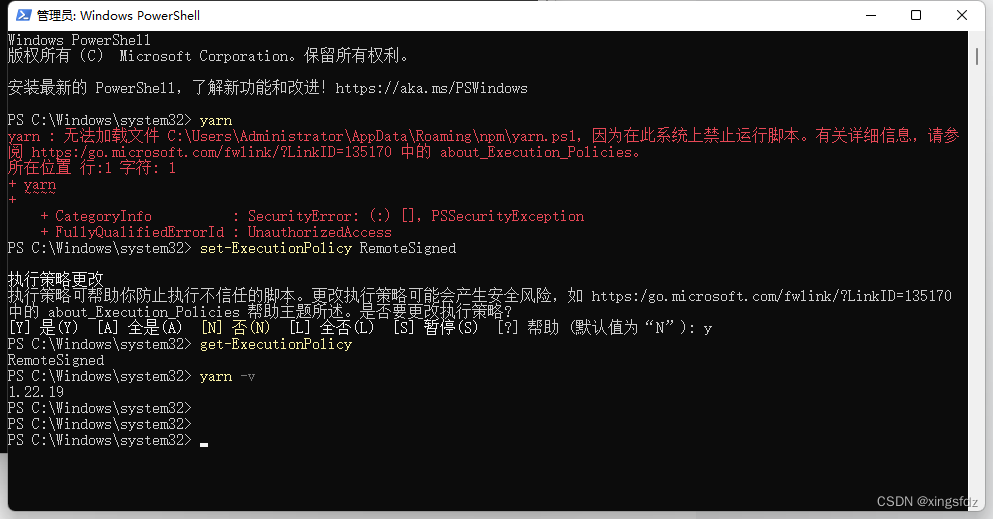
【代码】windows系统上的终端或powershell 提示禁止使用脚本解决方法。
在现实情况中,用户代码错误不断,进程奔溃,机器故障等等。使用hadoop的好处之一就是可以它能处理这类故障并成功完成任务。需要考虑的实体失败任务为:任务(job),Application Master,NodeManager和ResourceManager。1.任务失败1.1 可能存在以下情况:MapTask或者ReduceTask中由于代码原因抛出异常,jvm在关闭之前,会通知mrAppMast
运行spark on yarn时,Hadoop 8088UI界面上所有可以点击的链接均无法打开:可能存在的几种情况:第一:配置存在问题。第二:jobhistory没有启动。第三:本机的host文件没有配置别名。如果是配置存在问题,请参考如下配置:core-site.xml文件<configuration><!-- hadoop默认访问nameNode元数据...
spark在yarn上运行报错:Exception in thread "main" org.apache.spark.SparkException: Yarn application has already ended! It might have been killed or unable to launch application master. at org.ap
1、hive.metastore.schema.verification这个参数的属性设置为false,在hive-site.xml文件中修改。否则hiveserver启动失败。2、如果报这样的错:Exception in thread "main" java.sql.SQLException: Could not open client transport with JDBC Uri:
flink终止提交给yarn的任务
在当今的前端开发中,由于项目规模的不断增长和多团队协同,Monorepo成为了越来越流行的开发模式。Monorepo指的是将多个相关项目或者模块打包在一起的软件开发模式,它可以让开发人员更好地组织管理代码,减少重复的代码,提高可复用性和开发效率。在前端开发中,使用yarn monorepo能够更好地管理依赖和代码的复用,符合现代Web应用程序开发的趋势。
pysparkon yarn
配置环境变量,在/etc/profile文件中添加以下内容并重新加载配置文件(source /etc/profile)进入spark/conf配置目录新建spark-env.sh文件(vim spark-env.sh)并加入以下内容。将下载好的压缩包传入虚拟机的安装路径,本文章为/soft目录。进入spark安装目录输入以下内容成功返回pi的值则配置成功。
报错: info Visit https://yarnpkg.com/en/docs/cli/runfor documentation about this command.的解决方法
1、安装PythonPython下载路径:Download Python | Python.org官网比较现在比较慢,我用的是Windows64,Python3.8,如果有需要,可以留言留下邮箱发你Install Now是默认安装,建议不要选择这个;Customize installation是自定义安装,选择安装的路径,建议选择这个;勾选Add Python 3.X to PATH:加入系统变量
flink 任务处于 created 状态
介绍当前支持三种集群管理器:Spark独立集群管理器(Standalone),一种简单的Spark集群管理器,很容易建立集群,基于Spark自己的Master-Worker集群Apache Mesos,一种能够运行Haoop MapReduce和服务应用的集群管理器Hadoop YARN,Spark可以和Hadoop集成,利用Yarn进行资源调度如果在集群中仅有Spark程序,那么可以使用Spar
Yarn 报错:error An unexpected error occurred: "https://registry.yarnpkg.com/-/user/org.couchdb.user:alisone: connect ETIMEDOUT 104.16.26.35:443"原因分析解决方案原因分析在使用 yarn publish 命令发布 Generator 时报错,错误信息:error
一:对yarn的理解1.关于yarn的组成 大约分成主要的四个。 Resourcemanager,Nodemanager,Applicationmaster,container 2.Resourcemanager(RM)的理解 RM是全局资源管理器,负责整个系统的资源管理和分配。 主要由两个组件组成:调度器和应用程序管理器(ASM) 调度器:根据容量,队列...
问题描述1.虽然目前大多数平台内置Application在提交时,只配置了–num-executors和–executor-memory参数,但是其他APP的开发者可能会配置–executor-cores参数。举个例子:./spark-submit –master yarn-client –executor-cores 4 –num-executors 6–executor-memory...
flinkOnYarn并配置prometheus+grafana监控告警
修改PLAYWRIGHT_CDN_MIRRORS添加淘宝镜像。
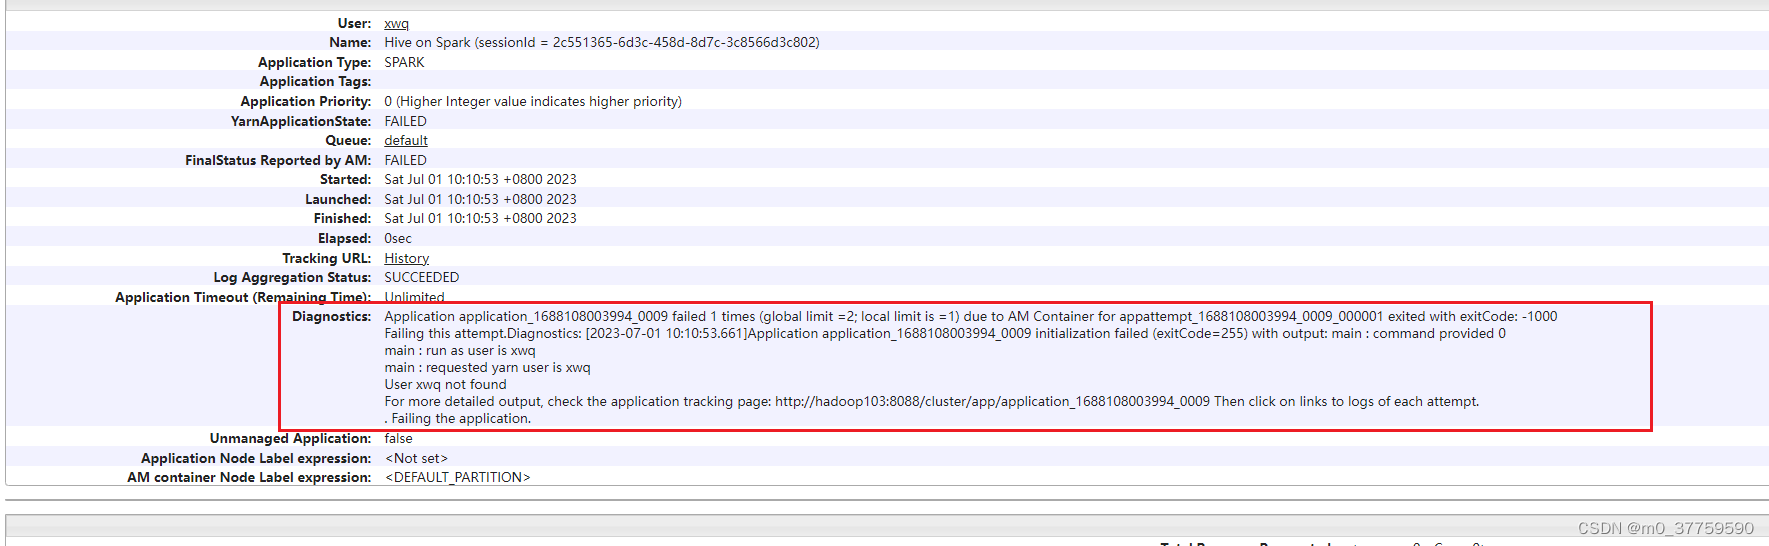
hive中的datagrip和beeline客户端的权限问题使用ranger和kerberos配置了hadoop和hive,今天想用来测试其权限测试xwq用户:1.首先添加xwq用户权限,命令如下:useraddxwq -G hadoopecho xwq | passwd --stdin xwqecho 'xwqALL=(ALL)NOPASSWD: NOPASSWD: ALL' >>
flink application yarn ha
原因:没启动yarn,直接start-all.sh。
抢占是 YARN 在资源紧张时的机制,用于重新分配低优先级任务的资源给更高优先级的任务。configured capacity=5%,表示队列的初始容量百分比,即avation队列在最开始可以使用132G*5%=6.75G,75*5%=3.75cores。: 这是当前等待资源的最高优先级请求的优先级值。通常,当 YARN 没有立即分配到符合要求的资源时,容器会被延迟,直到合适的资源可用。confi
说明是网络问题,请求超时了,需要更换源镜像并且扩大请求次数和时间。
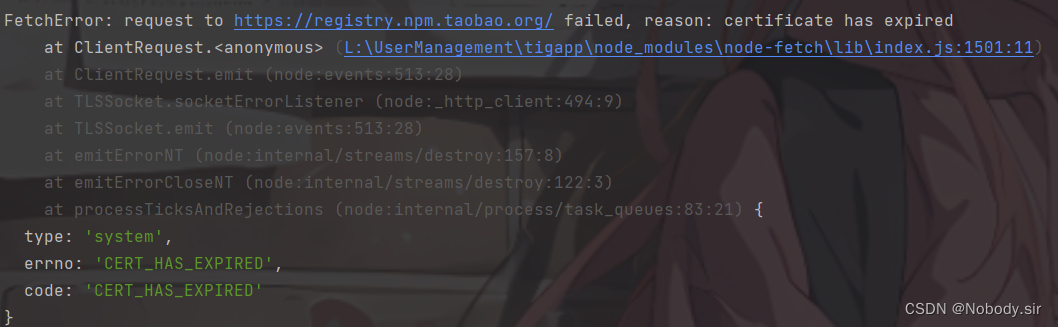
使用Ant Design Pro 创建项目,引入Umi UI 后发生 FetchError: request to https://registry.npm.taobao.org/ failed, reason: certificate has expiredat ClientRequest.错误
error An unexpected error occurred: “https://registry.npmmirror.com/moment: tunneling socket could n
淘宝镜像证书过期问题
Flink启动yarn session报错:Permission denied: user=root,access=WRITE,inode="/user":why:supergroup:drwxr-xr-x
一开始umi-plugin-react一直安装不上,各种卸载package-lock.json删除啊,重装都不行,最后把node版本从16.18升级到18.10才安装好了。网上说是 nodeJs V17 版本发布了 OpenSSL3.0 对算法和秘钥大小增加了更为严格的限制,所以会报错。最后把这句代码加到package.json里的运行命令里就好用了。试了网上的几种方法都不行。艾玛浪费我半天时间…
【代码】yarn 安装 卸载降级升级 以及常用指令。
env.development、.env.production中的常量命名须以"VITE_"开头,这里定义的常量为VITE_APP_PROXY_BASE_API,值分别为"/proxyCustomerApi-dev"、"/proxyCustomerApi-pro"用以区分开发环境和生产环境,值可自定义为"/+自己想定义的内容"接下来处理生产环境(线上模式)下的跨域报错问题,由于刚刚前端的配置中已经
TypeError: prettier.resolveConfig.sync is not a function 解决方案:尝试使用eslint-plugin-prettier ^4.2.1 和 prettier ^2.8.8 进行搭配
yarn 提高资源利用率
saprk on yarn 提交脚本后 yarn web页面自动跳转spark运行页面
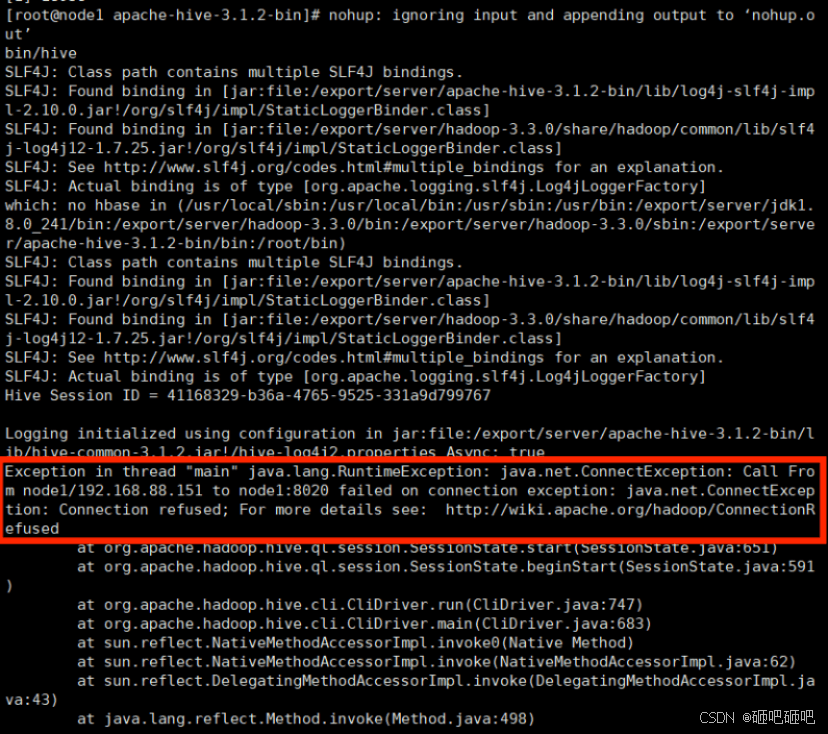
可能是服务器找不到Driver导致的,在服务器的host配置你Driver电脑的映射可能解决问题,这里我是云服务器,没在一个局域网且没有公网ip所以放弃远程提交改用命令行提交。技术力有限,如果有更好的结局方案请留言,不胜感激。spark on yarn 读取hdfs拒绝连接。
yarn报错 error An unexpected error occurred: “https://registry.yarnpkg.com… connect ETIMEDOUT 104.16.19.35:443”
RemoteSigned 表示成功。最后查看下版本看是否正常。
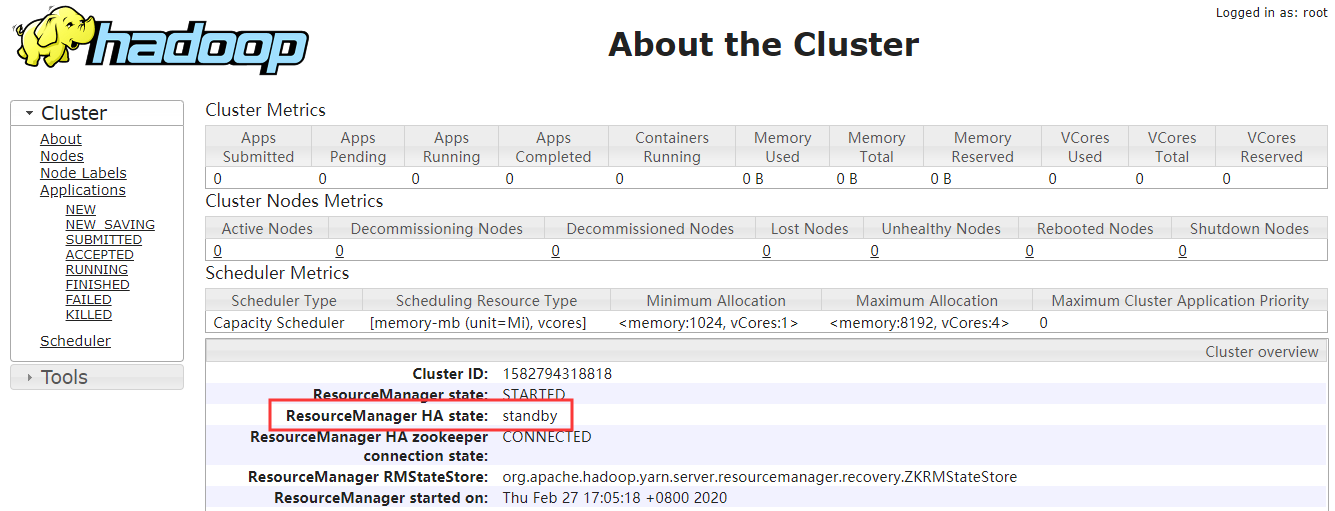
hadoop HA 高可用 yarn两个ResourceManager状态都为standb
记述了连线环境下安装npm 包的方法,同时解决了如下问题:npm ERR! code EAI_AGAINnpm ERR! syscall getaddrinfonpm ERR! errno EAI_AGAINnpm ERR! request to https://registry.yarnpkg.com/esbuild-linux-64 failed, reason: getaddrinfo EA
设置全局npm缓存依然无效,每次yarn install命令都需要重新下载依赖文件,解决方法如下:使用npm安装yarn后在jenkinsfile中执行yarn install 命令时设置以下参数指定全局缓存文件位置yarn install --prefer-offline --modules-folder /usr/local/n/versions/node/14.16.0/node_globa
这里到项目路径里面查看一下打包好的jar包打包之后的jar包如果是这两个,然后提交jar包的时候提交的flink-1.0-SNAPSHOT-jar-with-dependencies.jar 这个jar包,那么就会报上面的错误,这里应该是jar包里面的依赖出现了问题我的解决措施是,直接重新创建了一个项目然后是项目的整体pom.xml文件<?xml version="1.0" encoding
flink on yarn加载第三方jar包。
flink on yarn 模式,缺少资源,出现任务堵塞现象:1.报错信息如下:Application is added to the scheduler and is not yet activated. (Resource request: <memory:94208, vCores:48> exceeds maximum AM resource allowed).Applicat
Flink在cdh6.2上的搭建下载flink相关的csd和parcel地址:https://archive.cloudera.com/csa/1.0.0.0/csd/,https://archive.cloudera.com/csa/1.0.0.0/parcels/将FLINK-1.9.0-csa1.0.0.0-cdh6.3.0.jar 放在/opt/cloudera/csd下重启cm-serv
直接贴图解决方法,node升级到支持globalThis的版本(v12或更高版本)
目前有很多Vue+Prettier+Husky钩子的整合应用,基本都是基于.git与所需钩子的项目在同一目录下使用的,husky钩子会自动根据当前目录的.huskyrc的配置自动执行,而当碰到.git与所需提交目录不在同一层级下,就会出现husky钩子无法正常执行的情况。为了解决这个问题,各种百度谷歌,都没有能够直接看懂的方案,没办法,这时候只能自食其力了。通过阅读husky官方文档,发现husk
# genmuluchuangjian .yarnrc/www/wwwroot # vi .yarnrcregistry: https://registry.npm.taobao.orgENTRYCLI_CDNURL: https://cdn.npm.taobao.org/dist/sentry-clisentrycli_cdnurl: https://cdn.npm.taobao.org/dis
背景计划将之前部署好的flink1.10升级到1.11.2。主要流程及踩坑1.从官方下载flink1.11.2的压缩包,选择与业务程序中导入的maven依赖scala版本一致即可(本人选用的是2.11)。flink压缩包官方下载链接2.修改对应的配置文件(yarn模式下只需配置flink-conf.yaml, 如果是使用flink自己的资源调度则简单配置masters、workers文件即可)。f
接上篇,hdfs集群启动后仅仅是一个分布式文件系统而已,并不具备计算的能力,因此引出yarn,记录一下yarn HA的搭建过程。首先需要注意一点,Yarn与HDFS属于两个不同的集群,一个负责文件存储,一个负责作业调度,二者之间没有必然关系,也不一定说Yarn的某些节点必须必须要放在datanaode上。通常会把nodemanager和datanode放在一起是因为要“计算向数据移动”,尽可能..
问题线上hadoop有个hivesql执行较耗时,1hour 8min;收到运维预警定位查找job history 页面http://node:8088/cluster/app/application_xxxx_xxhttp://node:8088/proxy/application_xxxx_xxhttp://node:19888/jobhistory/jo...
yarn rest api :yarn rest apisparkstreaming消息延迟监控处理:http://ip:8088/proxy/yarn _application_id/metrics/json
yarn
——yarn
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 乐奇 Rokid 开放社区




 天工造物局