登录社区云,与社区用户共同成长
邀请您加入社区
解决Ranger无法连接双主Mysql的问题一、问题描述报错信息ERROR 1418 (HY000): This function has none of DETERMINISTIC, NO SQL, or READS SQL DATA in its declaration and binary logging is enabled (you *might* want to use the les
说明:适用于Kylin V10系统,ARM64架构,已完全适配使用有需求私聊
这是一个学习文档看看这个文档好不好用public static void main{}[外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传(img-1h9otV8t-1619284681699)(https://cdn.nlark.com/yuque/__mermaid_v3/c0bfd0479dcf29d7cc961774486a0da6.svg#lake_card_v2=eyJ
版本下载地址:https://docs.cloudera.com/HDPDocuments/新版本下载需要认证:github:https://github.com/apache/ambari官方安装服务https://github.com/hortonworks/hdp_ambari_definitions-releaseapi:https://github...
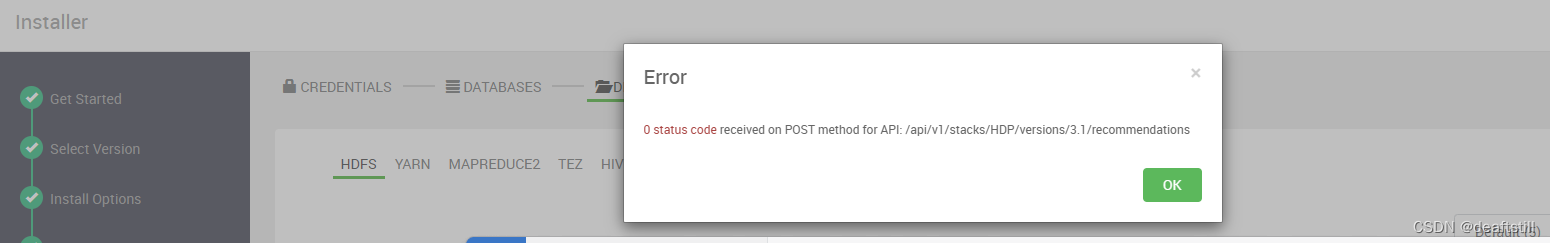
使用ambari部署大数据组件时报了0 status code received on POST method for APl: /api/v1/stacks/HDP/versions/3.1/recommendations错误。目前看这是会超时,但不知道是什么原因造成的,端口通的,都做了免密。
Apache Ambari项目旨在通过开发用于配置,管理和监控Apache Hadoop集群的软件来简化Hadoop管理.Ambari提供了一个由RESTful API支持的直观,易用的Hadoop管理Web Ul。Ambari使系统管理员能够:提供Hadoop集群Ambari提供了跨任意数量的主机安装Hadoop服务的分步向导Ambari处理集群的Hadoop服务配置管理Hadoop集群。
phoenix-hbase4.15及5.X版本后,phoenix-hbase安装包中就不带phoenix-queryserver,phoenix-queryserver需要单独安装。本文将从手动安装跟Ambari安装两种方式出发适配phoenix-hbase高版本。
文章目录零. 方案选择一. 2.4.8版本安装二. spark2版本升级2.0 升级前提2.1 版本升级相关脚本三. spark2升级后遇到的问题及解决方案
由于任务都是在内网执行,无法贴图,只描述下具体步骤:检查磁盘空间,查看是否空间不足。我的是vg00-lv-root这个空间满了,集群日志无法写入,导致数据库无法启动;检查数据库服务是否正常。由于上述原因我把hdfs-audit.log日志清理了一部分,重新启动pg,成功。至此,重新启动ambari,可以正常登录了。...
写在前面ambari+hdp 安装集群的时候密码修改太简单,出于安全考虑,做各用户的密码修改。1 mysql 用户管理表字段CREATE TABLE `user` (`Host` char(60) COLLATE utf8_bin NOT NULL DEFAULT '',`User` char(32) COLLATE utf8_bin NOT NULL DEFAULT '',`Select_pri
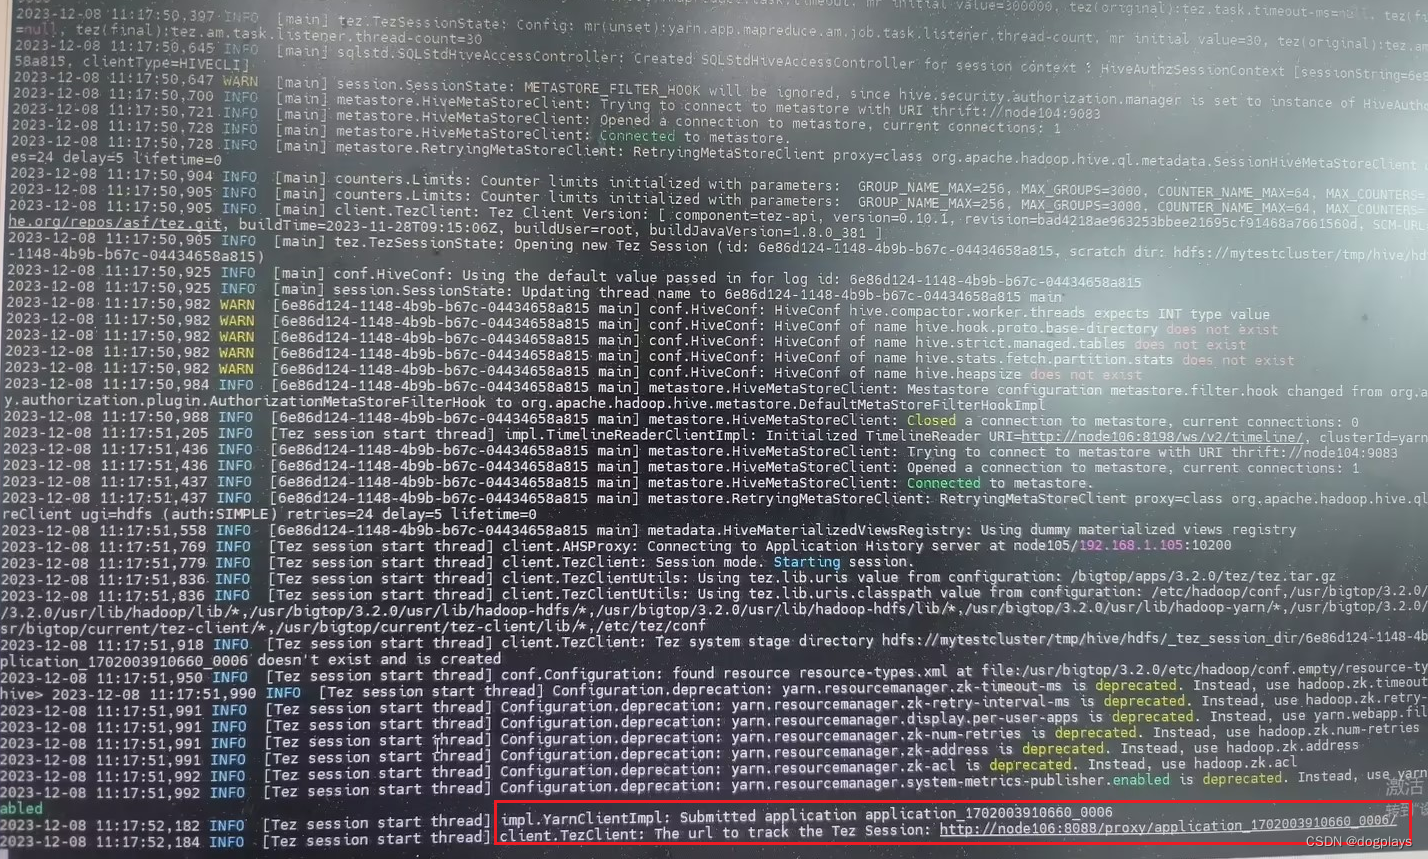
使用TEZ作为Hive默认执行引擎时,需要在调用Hive CLI的时候启动YARN应用,预分配资源,这需要花一些时间,而使用MapReduce作为执行引擎时是在执行语句的时候才会去启用YARN应用。所以说,hive on tez使用./bin/hive后一直卡住是假象,待预分配资源任务结束后,即可输入hive sql正常执行。hive on tez使用./bin/hive启动后一直卡住,无法进入命
vmtoolsd:2730]当我们修改完后可以打开master虚拟机执行以下命令,看当前问题是否被解决,或者说修正到哪一步了,要明白你做的这一步操作都解决了哪些问题。不要担心内核变少会有啥影响,因为你本身内核太多,内存太少这样平均分 配下来,每个内核的运行内存就特少,自然会影响性能。这是正常的系统启动日志,表示按照我们的配置关闭了NMI watchdog,不是真正的错误!
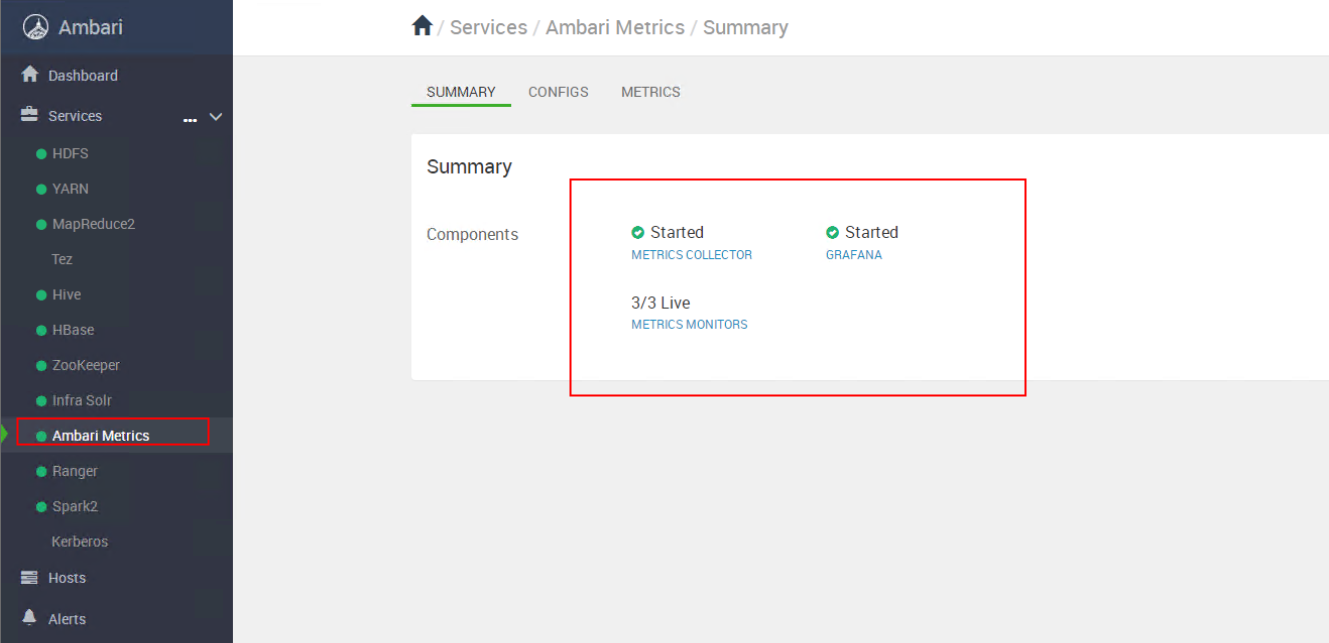
Ambari Metrics, Metrics Collector 启动报错如下:stderr:stdout:根据上面 的日志分析是AMS 自带的HBase 问题,所以解决方法想到了 删除数据让服务自动重建数据库。
在添加hive组件之前需要做的事情,先在master这个虚拟机里面创建好hive先进入虚拟机里面进入mysql然后输入这个命令看看有没有自己创建的hive数据库有的话会显示下面这个样子没有的同学使用以下命令可以在MySQL中创建hive数据库(本人给的hive数据库密码是hive)
hive 启动失败
gradle 使用 私服提速
点击卡片“大数据实战演练”,选择“设为星标”或“置顶”回复“资料”可领取独家整理的大数据学习资料!回复“Ambari知识库”可领取独家整理的Ambari学习资料!大家好,我是create17,见字如面。今天给大家分享:Ambari集成服务时,如何限制服务组件A与组件B不能部署在同一节点?关键字:Ambari集成服务如何限制组件不在同一节点。希望我接下来的分享给大家带来一些帮助和启发????一、问题
ambari2.7.5集群中安装 ranger2.1.0 策略没有自动创建,例如hadoop
regionserver、phoenix、client选择和datanode一样即可,下一步。选择+号增加一个HBase主节点,注意不要和metrics服务放在同一个节点上,下一步。三部分重启过后可能会有一两个警告,没关系,过一会系统会自行调节,随后警告解除。安装、启动、测试,当所有节点Successfully以后,下一步。打开ambari web界面选择操作----->添加服务。接下来默认配置下
ambari集成flink详情可参考:Ambari 2.7.5安装Flink1.13.2_不饿同学的博客-CSDN博客_ambari安装flink这里说一下安装过程遇到的问题:1、安装时报错:Error: Error: Unable to run the custom hook script ['/usr/bin/python', '/var/lib/ambari-agent/cache/stac
文章目录1.问题2.解决1.问题Ambari-Agent心跳丢失:后台日志:tail -f /var/log/ambari-agent/ambari-agent.logINFO 2021-07-19 16:57:37,124 main.py:481 - Connecting to Ambari server at https://manager.insight.com:8440 (10.180.2
hive on tez,在执行任务的时候报错,这种情况原因是container资源被抢占或者是资源不足。而task最大的失败次数默认是4,am自己失败的最大重试次数默认是2次。分析:task_1442391298043_123239_1_01_000000,失败了4次,失败的原因是container被高优先级的任务抢占了。而task最大的失败次数默认是4。当集群上的任务比较多时,比较容易出现这个问
1、创建证书目录root@hadoop01[/etc/ambari-server]#mkdir /etc/ambari-server/certsroot@hadoop01[/etc/ambari-server]#cd /etc/ambari-server/certs/root@hadoop01[/etc/ambari-server/certs]#export AMBARI_SERVER...
java.io.FileNotFoundException: File does not exist: /user/adminat sun.reflect.NativeConstructorAccessorImpl.newInstance0(Native Method)at sun.reflect.NativeConstructorAccessorImpl.newInstance(Nat...
ambari集群整体迁移,修改ip地址
基于3台虚拟机服务器如何安装ambari,并通过ambari安装各大数据组件
零基础入门HDP集群安装,使用ambari进行安装大数据集群组件,实操从零学习掌握集群安装,从安装centos系统到hadoop集群的安装,细节清晰
Ambari二次开发之集成Flink安装教程
过去一年里,我一直在探索如何构建一套真正适配当前数据需求的一体化大数据平台。在这条路上,我选择了作为基础,逐步集成了存储、计算、调度、分析、监控等能力,最终形成了较为完整的大数据生态体系。。尤其是在实时场景日益增多、批流融合需求变强的背景下,湖仓格式的选型和落地变得尤为重要。本文,我将分享目前在 Ambari 上构建了哪些组件,面临什么样的架构瓶颈,以及我为什么开始认真考虑湖仓格式的引入与选型。
点击卡片“大数据实战演练”,选择“设为星标”或“置顶”回复“资料”可领取独家整理的大数据学习资料!回复“Ambari知识库”可领取独家整理的Ambari学习资料!一、企业级大数据平台 EDP以前,我们可以通过 Apache Ambari + HDP 的形式部署 Hadoop 各组件。但自从 hortonworks 与 cloudera 公司合并后,hdp 就闭源了,不再更新。在这种背景下,大家迫切
1.1 部署 docker1.2 部署 docker-compose创建网络1.3 版本说明组件版本操作系统ambari2.7.4HDP3.1.4HDP-GPL3.1.4HDP-UTILS1.1.0.22JDK如下安装只做测试。二 、镜像构建启动2.1 系统镜像构建系统镜像构建2.2 安装包源镜像构建源镜像构建。
回顾从前,已经在大数据领域混了5年了,经手了不少大数据集群搭建方案,自己也做过许多大数据平台的运维工作,在这里进行阶段性的总结,主要是 原生Hadoop、CDH、Ambari集群搭建对比。
从头开发一个大数据管理平台-Mybari(一)背景功能分析技术选型功能特色时间安排未来演进下一篇背景因为众所周知的原因,cloudera和hortonworks两家巨头决定不再继续卷下去了,要开始联手割用户的韭菜了。于是就带来了一个问题,还要不要继续使用hdp或者cdh呢?cdh依然有着100个节点的限制,hdp也不再更新。开源大数据组件的新特性使用不上,还得提心吊胆的怕接收到对方的律师函,真是够
本文是讲如何在centos7.4(64位) 安装ambari+hdp,如果在装有原生hadoop等集群的机器上安装,需要先将集群服务停掉,然后将不需要的环境变量注释掉即可,如果不注释掉,后面虽然可以安装成功,但是在启动某些服务的时候可能会有异常,比如最后提到的hive启动异常。本文适合系统: RedHat7、CentOS7、Oracle Linux7(都是64位)注意:centos7中文系统有bu
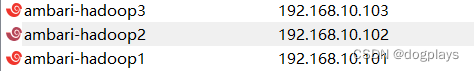
大数据AMBARI2.6.2.2+HDP2.6.5.0安装实战centos7版(新)最近有点空,把ambari+hdp安装部署操作实战分享给大牛们,拿走不谢!1、虚拟机准备我准备的是3台:centos-hadoop1、centos-hadoop2、centos-hadoop3并且配置好对应主机的网络IP、主机名称、关闭防火墙。systemctl stop firewalld.service2、安装
一.、版本介绍 使用的版本为ambari版本2.6.0.0,HDP版本2.6.3.0-235,HDP-UTILS-1.1.0.21及jdk1.8,mysql5.7,mysql-connector-java-5.1.45,另外系统内存和磁盘容量都要大一些。二、环境准备磁盘检查~/bin/runRemoteCmd.sh “df -h” all2.修改字符集vim /etc/locale.c...
一、在线编译安装1.1. 安装独立maven1.1.1. 下载Mavenwget http://mirrors.tuna.tsinghua.edu.cn/apache/maven/maven-3/3.5.2/binaries/apache-maven-3.5.2-bin.tar.gz 1.1.2. 解压安装Maventar -xzvf apache-maven-3....
前言本文适合已经初步了解 Ambari 的读者。对 Ambari 的基础知识,以及 Ambari 的安装步骤还不清楚的读者,可以先阅读基础篇文章《Ambari——大数据平台的搭建利器》。Ambari 的现状目前 Apache Ambari 的最高版本是 2.0.1,最高的 Stack 版本是 HDP 2.2。未来不久将会发布 Ambari 2.1 以及 HDP 2.3(本文也将以 Ambari
这时候按住Alt键调出修复工具,用填充命令把那些直径3mm以下的孔洞全部堵上,别小看这些细节,它们能让后续的网格数量减少30%。当模拟低温加热工况时,PTC加热膜的功率分配需要按模组位置加权,靠近出口的分配系数应该降低15%左右。最后导出报告时,用Journal脚本自动生成对比曲线,把不同工况的温度分布谱图拼成九宫格,甲方最爱这种一目了然的呈现方式。模型如何搭建,几何清理网格划分,重要分析参数如何
像阴极侧过氧比控制这种快变过程,滑模控制确实能打,但温度这种大惯性环节得配合预测控制才有奇效。咱的终极方案是拿滑模当先锋部队处理突变,后面跟着模型预测控制的大部队稳场子,这套组合拳实测比纯滑模系统效率高了15个百分点。看到那个Switch模块没?质子交换膜燃料电池PEMFC Matlab/simulink滑模控制模型,过氧比控制,温度控制,阴,阳极气压控制。质子交换膜燃料电池PEMFC Matla
基于深度学习的面部表情识别含图片和视频的面部表情识别,含详细的代码运行说明文档。在当今数字化时代,面部表情识别作为人工智能领域的一个重要研究方向,具有广泛的应用前景,如人机交互、情感分析、安防监控等。今天,咱们就来深入探讨一下基于深度学习实现含图片和视频的面部表情识别,并且附上详细的代码运行说明。
降低门槛:无需手动修改数十个 XML 配置文件。提升效率:从几天的手工部署缩短到小时级别。运维友好:Web 界面统一管理配置、监控、告警、升级。适合企业:多节点、多服务、多版本的大数据平台标准化交付。
Ambari = 大数据集群的“安装管家 + 监控中心 + 配置面板”适合那些不想手动折腾一大堆配置文件的人有了它,你可以在几小时内搭建好一个几十台机器的大数据平台,而不是花几周时间所以,如果你将来想玩大数据,又不想被繁琐的安装配置劝退,Ambari就是你最好的小伙伴!🎉。
注意:Ambari 会自动帮你检查依赖,比如选了 HBase,它会提醒你必须装 ZooKeeper。你想装一个游戏(软件),不需要自己去找安装包、解决各种依赖问题,商店会自动帮你下载、安装好。老师(Server)说:“所有同学(Agent)安装 JDK”,工人就去装。你的电脑(Linux)会先去一个“软件仓库”看看有哪些软件。手动每台机器配 IP、装 JDK、改配置文件、解决版本冲突…配置好 Yu
Ambari 大数据环境搭建利器
本文档整理Ambari集群全量核心组件、附属工具及安全服务,按业务模块分类,清晰说明各服务、角色的定位与核心功能,适用于集群运维、学习查阅、台账备案。
🧠 思维升级:理解自动化运维的思想,未来无论是做开发还是做架构,都能事半功倍。🔭 前沿视野:大数据是 AI 的“燃料”,Ambari 是大数据领域的“智能管家”,提前接触不吃亏。🚀 实战入门:即便现在不深入,知道有这样一个工具,以后做项目时就能快速搭建环境,省下大量时间。一句话记住 Ambari:让 Hadoop 集群的搭建和管理,像用手机 App 一样简单。
Ambari 极大地降低了大数据平台的搭建和维护难度。无论是学习还是生产环境,它都是一个值得掌握的利器。配合本文提供的模拟器,即使没有真实集群,也能快速理解其核心思想。希望这篇文章能帮助你迈入大数据运维的大门。
ambari
——ambari
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 乐奇 Rokid 开放社区








 天工造物局








 亚马逊云科技技术品牌专区