


- @weixin_47723732


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本文介绍了一个社区低碳治理数据分析与预测系统的完整开发流程。项目通过1200条居民行为数据,采用随机森林算法构建预测模型,分析影响低碳行为意愿的关键因素(如环保价值认同、情绪体验等),并开发了包含数据管理、可视化分析、动态大屏和在线预测功能的Web系统。系统实现了从数据处理、模型训练到应用落地的全链路解决方案,为社区低碳宣传提供分层支持策略。技术栈涵盖Pandas、Scikit-learn、Fla
本项目构建了一套美食视频数据分析系统,通过双路径采集B站美食分区2万条视频数据及5519条评论,实现从数据采集、清洗存储到多维分析的完整链路。系统采用Python+Flask技术栈,结合MySQL、TF-IDF、LDA等算法,对视频的创作者表现、发布时间规律、内容特征及用户评论进行深度挖掘。可视化大屏通过ECharts展示播放趋势、互动指标等核心数据,Web系统支持多维度查询与主题切换。项目兼具教
基于Hadoop的心脏病风险预测系统设计与实现的主要研究内容分为以下几个内容。本研究设计并实现了一个基于Hadoop平台的心脏病风险智能预测系统。研究数据采用美国CDC行为风险因素监测系统(BRFSS)发布的公开数据集,包含40万份健康调查记录,涉及生理指标、行为习惯和人口特征三大类数据特征。数据预处理:包括异常值清洗、缺失值填补和特征标准化分布式存储:基于HDFS构建数据仓库自动化管道:采用Fl
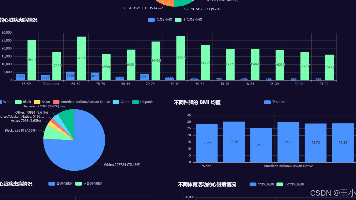
本研究以开源的淘宝用户行为数据为基础,展开分布式集群的大数据分析,旨在通过高效的数据处理和分析提高电商系统的决策支持能力。所用数据覆盖了从11月18日至12月18日的一个月时间,共计约100万条用户行为记录,每条记录详细记录了用户的每一次行为。研究首先涉及将这些大规模数据上传到Hadoop的HDFS(分布式文件系统)中,利用Hadoop的Flume组件自动加载数据至Hive数据库,为后续的大规模数

另一方面也反映出,对于好看的动漫,观众是很愿意分享的。

本研究基于机器学习方法对西安市二手房价格进行预测分析,采用链家网数据构建全流程技术方案。通过requests+lxml实现数据采集,结合特征工程处理中文文本特征(如梯户比例解析、抵押信息分类等)。使用CatBoost、XGBoost等多模型对比,其中CatBoost表现最优(R²=0.86)。可视化分析显示区域、楼层、装修等因素对价格影响显著。项目创新性地实现了数据采集-治理-建模-可视化全链路,
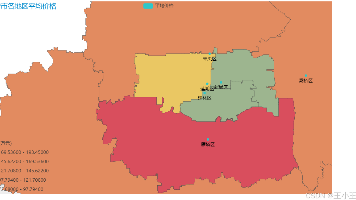
餐饮大数据分析系统项目摘要 本项目构建了一个从数据采集到可视化的一体化餐饮数据分析系统。通过爬取"豆果美食"网站的菜谱数据,运用Python进行数据清洗(包括评分单位换算、文本规范化等),并建立MySQL数据库存储结构化数据。系统采用Hadoop生态技术(Flume、Hive)实现大数据处理,通过Sqoop将分析结果导回MySQL。最终使用Pyecharts生成交互式可视化大屏
第三库安装requests库安装这里总结了三种方法1.通过anaconda终端包,安装。这里要注意的是,必须你的编译环境是用的anaconda,不然你安装了也没有用。安装的时候,用 pip install 模块名,回车即可当然这里有时候会出现安装不上的原因,可以多试几次,这个属于正常的情况,有时候网速和机器使用都会有影响。我这里推荐一个清华镜像网址,把这个输入到那个终端即可,回车,然后输入pip
本项目构建了一套完整的电影数据分析与评分预测系统,涵盖数据采集、清洗、可视化建模全流程。通过爬取豆瓣电影数据,设计档期特征工程,采用多模型对比(随机森林最优,R²≈0.87)实现评分预测,并结合文本挖掘分析影评语义。系统提供数据看板、预测接口等功能,创新性地将结构化数据与文本分析结合,为电影产业提供决策支持。未来拟扩展多源数据与多模态特征,优化模型性能。
大模型应用开发与智能对话系统摘要 当前大模型应用开发主要基于知识库与智能体(Agent)架构,采用LangChain、LangGraph等框架实现复杂任务编排和多智能体协作。关键技术包括: RAG增强:结合向量数据库(Chroma/Milvus)实现知识检索增强 Agent架构:支持工具调用、多步推理和动态决策 高并发优化:异步处理、连接池和缓存机制保障性能 典型应用案例包括: FastAPI+L
