


- @weixin_38023225


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
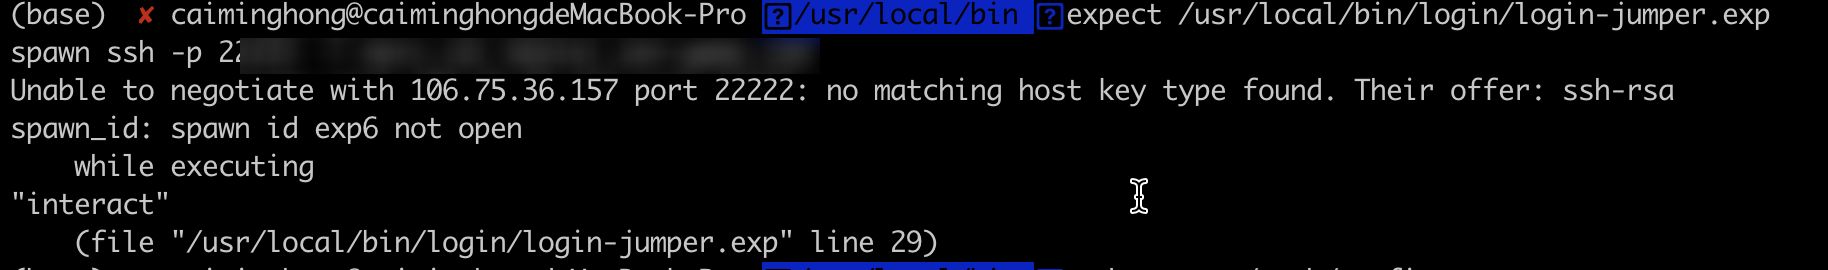
1.问题描述Mac 上iterm2 脚本连接堡垒机报错。
1.问题DBeaver连接hive仓库,表中文注释乱码创建表的时候,comment说明字段包含中文,表成功创建成功之后,desc的时候中文说明显示乱码.如下图所示:2.问题分析我们知道hive的元数据是由mysql管理的,所以这是mysql的元数据的问题.下面我们就修改一下字符编码3.解决方案修改hive数据库表字段(1)修改表字段注解和表注解alter t...
1 安装地址1.1 Hive官网地址http://hive.apache.org/1.2 文档查看地址https://cwiki.apache.org/confluence/display/Hive/GettingStarted1.3 下载地址http://archive.apache.org/dist/hive/1.4 github地址https://github...
1 安装地址1.1 Hive官网地址http://hive.apache.org/1.2 文档查看地址https://cwiki.apache.org/confluence/display/Hive/GettingStarted1.3 下载地址http://archive.apache.org/dist/hive/1.4 github地址https://github...
准备工作1.主机域名配置#第一台服务器上执行echo "172.31.30.81ptx-bigdata1" >> /etc/hostsecho "172.31.27.167ptx-bigdata2" >> /etc/hostsecho "172.31.31.127 ptx-bigdata3" >> /etc/hostsecho "172.31.28.41 ptx
1.下载JDBC驱动程序(Linux64)参考:下载链接驱动程序2.安装用于Linux的JDBC驱动程序1)下载完成后,将.zip文件的内容提取到所需的位置。2)在提取.zip文件内容的位置中,找到NQjc.jar文件。该文件包含可通过将NQjc.jar文件添加到类路径中来在Java环境中注册的驱动程序参考:安装用于Linux的JDBC驱动程序sudo cp NQjc.ja...
1、环境准备1)timedatectl查看时间各种状态:[ptxbd@ptx-bigdata2 etc]$ timedatectlLocal time: Thu 2020-03-12 13:00:55 UTCUniversal time: Thu 2020-03-12 13:00:55 UTCRTC time: Thu 2020-03-12 13:0...
1 案例需求业务系统使用log4j生成日志,日志内容不断增加,需要把追加到日志文件中的数据实时采集到HDFS2 需求分析根据需求,首先定义以下3大要素采集源,即Source--监控文件内容更新:exec "tail -F file"下沉目标,即Sink--HDFS文件系统:hdfs sinkSource与Sink之间的传递通道--Channel,可用FileChannel也...
问题在集群主机点启动HDFS集群和YARN集群之后,查看各个节点启动情况:主节点全部启动成功,从节点启动失败[root@master-node ~]# jps6432 Jps5427 NameNode5811 ResourceManager5531 DataNode5917 NodeManager[root@slave-node1 ~]# jps2244 Jps...