登录社区云,与社区用户共同成长
邀请您加入社区
LoRA 精读:用低秩旁路适配大模型,冻结底座只训少量参数,实现高效多任务微调与部署合并。
参数高效微调(Parameter-Efficient Fine-Tuning, PEFT)是当前大规模模型训练中的关键技术,其中LoRA(Low-Rank Adaptation)通过低秩矩阵分解显著减少可训练参数数量。其核心原理是在预训练模型的特定层注入可训练的适配器,仅更新少量参数即可实现接近全参数微调的效果。在跨模态检索任务中,结合对比学习(Contrastive Learning)能有效提升
视频检索作为多模态理解的核心任务,其技术演进正从传统特征工程转向深度学习范式。基于Transformer的预训练模型虽具备强大表征能力,但全参数微调存在计算成本高、易遗忘通用特征等痛点。LoRA(低秩适配)技术通过矩阵分解实现参数高效更新,仅需调整0.1%-1%的参数量;对比学习则通过构建正负样本对,保持模型语义对齐能力。这两种技术的结合,既能降低训练资源消耗,又能提升跨模态检索效果。在视频搜索、
AIGC(人工智能生成内容)正深刻改变内容创作领域,其核心原理在于利用深度学习模型学习数据分布并生成新的文本、图像、音频与视频。这项技术的核心价值在于大幅降低专业内容生产的门槛与成本,使个人或小团队也能高效产出高质量的数字媒体作品。在应用场景上,AIGC已广泛应用于短视频制作、动画预览、数字营销和原创IP开发等领域。本文聚焦于如何整合Stable Diffusion、LoRA、GPT-SoVITS
赛博丹炉训练 LoRA 时遇到 RuntimeError: Missing key(s) in state_dict for UNet2DConditionModel,底部退出码 return non-zero exit status 1 只是误导。把 Codex 接入 TaoToken 后,先改 ~/.codex/config.toml 里的 Base URL 为 https://taotoke
本文介绍了如何在星图GPU平台上自动化部署ms-swift微调框架镜像,以简化大语言模型的个性化训练流程。该平台支持一键部署,用户可快速搭建环境,利用ms-swift的LoRA技术,仅需消费级显卡即可高效完成模型微调,典型应用于快速构建智能客服或领域知识问答系统。
本文介绍了如何在星图GPU平台上自动化部署ms-swift镜像,高效开展大语言模型轻量微调。基于该平台,开发者可一键启动LoRA与QLoRA对比实验,典型应用于中文指令微调(如Alpaca数据集上的Qwen2.5-7B模型优化),显著降低显存占用并提升训练效率。
本文介绍了如何在星图GPU平台上自动化部署lora-scripts模型训练工具,并利用其进行小数据微调。通过该工具,用户仅需准备少量样本(如50条方言语音),即可快速训练出具备特定识别能力的AI模型,例如打造一个方言关键词识别器,有效降低模型定制门槛。
借助lora-scripts工具,可通过少量公开军事图片训练专属AI模型,精准生成符合我国军队制式的高清图像。该方案在消费级显卡上即可完成,实现低门槛、高合规的国防教育视觉内容生产,已成功应用于边防、军种场景的沉浸式宣传。
掌握LoRA训练中的关键参数配置,从batch_size与梯度累积的平衡,到学习率、rank和epochs的精细调整,结合真实案例揭示如何在有限算力下高效训练高质量模型。通过数据准备、配置优化与监控验证的完整流程,帮助开发者避开常见陷阱,实现稳定落地。
通过lora-scripts训练LoRA模型后,利用HTML前端技术构建动态对比页面,实现滑动、悬停等交互效果,直观展现微调前后图像差异。该方法降低理解门槛,提升团队沟通效率,让非技术人员也能快速 grasp 模型价值。
利用lora-scripts通过增量训练和检查点恢复,实现LoRA模型的高效迭代。在保留原有能力的同时平滑融入新数据,适用于图像生成与领域微调,显著降低算力消耗并避免灾难性遗忘。
只需50张图片和消费级显卡,利用LoRA技术与lora-scripts工具,普通人也能快速定制专属AI绘画风格。通过低秩微调,节省显存、加速训练,避免过拟合,实现高效风格迁移。配合合理参数设置与数据准备,可轻松生成赛博朋克、古风山水等独特视觉效果。
面对百度搜索不到lora-scripts等前沿AI工具的困境,可通过谷歌学术镜像网站精准定位相关学术论文与技术资料。结合LoRA低秩微调原理与lora-scripts自动化训练框架,掌握从数据标注、配置修改到一键训练的全流程,降低大模型微调门槛,提升个性化生成式AI的落地效率。
LoRA虽轻量,但易因高rank、长epoch或数据单一导致过拟合。实际训练应优先控制秩大小,合理设置学习率与训练轮数,并结合翻转增强和人工验证,避免模型死记硬背。关键在于用有限数据找到保真与泛化的平衡。
通过LoRA技术和lora-scripts工具,普通创作者也能用几十张照片在消费级显卡上训练出个性化的数字IP。整个流程自动化程度高,只需准备高质量图像、精准描述文本,并合理配置参数即可快速生成可复用的轻量模型,适用于虚拟偶像、品牌代言等多种场景。
借助lora-scripts框架,博物馆可利用少量高清图像训练专属AI模型,实现文物的高精度三维图像生成与破损补全。该方法大幅降低技术门槛与成本,让中小型文博机构也能高效完成数字化重建,并支持风格迁移、AR展示与文创开发,推动文化遗产的智能焕新。
只需50到200张照片,借助lora-scripts自动化流程,普通用户也能在消费级显卡上快速训练出专属人物LoRA模型。从图像预处理、自动打标到模型导出全程覆盖,结合CLIP标注与低秩微调技术,实现高效个性化生成。
利用lora-scripts和LoRA技术,仅需50张高质量照片即可在消费级显卡上训练出高还原度的人物AI模型。从数据准备、自动标注到YAML配置驱动训练,全流程自动化,支持图像与文本模型微调,实现个性化的数字身份构建。
基于lora-scripts和少量真实文书样本,利用LoRA技术在消费级显卡上高效微调大模型,实现法律文书的自动化生成。该方法无需全量参数训练,仅需百条数据即可让通用模型具备专业写作能力,显著提升基层司法工作效率。
通过lora-scripts工具,无需编程基础也能快速训练专属LoRA模型。从数据准备、自动标注到配置训练和结果验证,全流程简化,显著降低AIGC微调门槛。实测在几小时内完成赛博朋克风格模型训练,并可在WebUI中稳定生成高质量图像,为个人创作者和中小企业提供了高效实用的AI定制化路径。
通过lora-scripts工具,档案馆可将少量老照片转化为生动的历史场景。该方法利用LoRA微调技术,在低资源条件下精准还原特定时代的视觉风格,无需编程基础即可完成模型训练与生成,已成功应用于石库门建筑复现等文化项目。
在消费级GPU上训练LoRA模型时,batch_size的选择直接影响显存占用与训练稳定性。通过梯度累积和混合精度等技术,可在低显存条件下实现高效微调。结合不同显存容量的实战配置建议,帮助用户在有限资源下平衡训练效果与硬件限制。
利用LoRA技术和lora-scripts工具,仅需50张高质量图片和消费级显卡,即可训练出精准还原人物特征的专属模型。整个流程无需编程,通过配置文件驱动,涵盖数据准备、标注、训练到部署的完整工作流,显著降低个性化AI生成的门槛。
与其依赖外部LUT调色包,不如用lora-scripts训练属于自己的视觉风格模型。通过低秩适配技术,普通人也能在消费级显卡上打造个性化的AI生成风格,实现从数据标注到部署的全流程掌控,真正让AI理解并复现个人审美。
在LoRA训练中,loss曲线的走势是判断模型状态的关键。真正的最佳保存时机往往出现在loss进入平台期前的最后一次显著下降点,而非最低值。单纯依赖自动化保存会积累冗余checkpoint,结合人工观察loss趋势与抽样生成测试,才能在拟合与泛化之间找到平衡,选出泛化性最好的模型。
LoRA虽轻量,但高分辨率、大batch和优化器状态仍易导致显存溢出。关键在于优化激活值与优化器占用,通过混合精度、梯度检查点、梯度累积等手段可有效降低显存压力。合理设置rank、分辨率和优化器类型,配合高质量数据,能在消费级显卡上稳定训练出高性能LoRA模型。
通过LoRA技术和lora-scripts工具,只需少量图片即可训练出品牌专属的AI角色模型,实现低成本、高效率的视觉内容生成。整个流程无需深厚技术背景,支持多场景应用与快速迭代,让企业轻松构建可复用的数字形象资产。
通过LoRA微调与LUT调色的结合,创作者可高效生成风格统一、具备电影质感的AI图像。利用lora-scripts实现自动化训练,再用专业色彩查找表强化后期,形成低成本、可复现的批量生产流程,特别适用于赛博朋克等强风格化项目。
本文深入探讨了LoRA与QLoRA技术在大语言模型轴承故障诊断中的高效微调策略。通过低秩自适应和4-bit量化技术,显著降低计算资源消耗,提升模型在工业场景中的实用性。实战案例显示,该方法在CWRU数据集上实现12.6%的准确率提升,特别适用于小样本场景,为工业设备故障预测提供了创新解决方案。
适合人群:会一点 Python,想亲手体验“微调大模型”是怎么回事,但手上只有一张消费级显卡或免费云端 GPU 的同学。
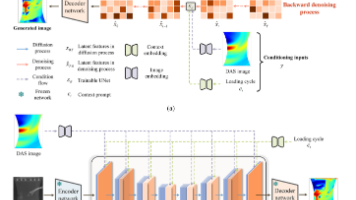
一种基于微调条件扩散模型(DI-CDM)的新型结构健康监测损伤成像框架。针对复合材料结构在疲劳载荷下分层损伤监测的难题,该方法创新性地将超声导波稀疏阵列的DAS波束成像与X射线图像相结合,通过LoRA微调预训练扩散模型,实现了高分辨率损伤成像。实验验证采用NASA公开复合材料数据集,结果表明DI-CDM在交并比(IoU)指标上达到传统DAS方法的3倍,能有效追踪分层扩展过程。该框架突破了现有方法在
在AI内容生成领域,Stable Diffusion等扩散模型通过文本提示词生成高质量图像已成为核心技术。其原理是基于潜在空间去噪,将随机噪声逐步转化为目标图像。这项技术的价值在于极大降低了视觉内容创作的门槛,使个性化、风格化图像的批量生产成为可能。应用场景已从艺术创作扩展至电商、游戏、影视等行业的素材生成。然而,当目标从单张图片升级为具备连续叙事的AI短剧时,核心挑战便从艺术生成转向了工程化的一
使用lora-scripts等工具训练人脸LoRA模型虽便捷,但存在严重数据隐私泄露风险。模型可能通过反演攻击还原面部特征,未经同意的数据采集和随意共享权重文件会加剧这一问题。开发者需强化数据合规意识,遵循知情同意、数据最小化等原则,防范身份滥用与deepfake风险。
利用lora-scripts在消费级显卡上高效训练个性化LoRA模型,并通过Web前端实现动态加载与实时风格生成,打通从数据到在线服务的完整链路。该方案已应用于插画、动漫、医疗等多个领域,显著提升创作效率与风格一致性。
通过lora-scripts工具,结合小样本图片与LoRA微调技术,实现家电品牌风格的自动化卖点图生成。利用消费级显卡即可完成训练,支持多模态内容输出与风格叠加,显著提升电商详情页的生产效率与视觉一致性。
通过lora-scripts工具,零基础也能在本地设备上完成古风水墨画风的LoRA模型训练,并部署到WebUI实现艺术创作。从数据准备、参数配置到生成优化,全流程详解让AI真正理解东方美学,轻松复现山水意境与笔墨神韵。
掌握如何将训练好的LoRA模型集成到Stable Diffusion WebUI中,实现个性化风格生成。从safetensors文件的生成原理到复制路径、加载语法和强度调节,完整演示从训练到应用的关键步骤,并分享提升效果的实用技巧。
仅需50张图和一块消费级显卡,通过LoRA与lora-scripts工具链,快速训练专属古风水墨画风格模型。无需全量微调,低秩适配技术让个人也能在几小时内完成风格定制,并无缝集成至WebUI生成高质量图像,实现东方美学的AI再现。
通过lora-scripts工具链,结合Stable Diffusion与LoRA技术,实现游戏角色的高效多姿态图像生成。仅需少量清晰图片和简单配置,即可在消费级显卡上完成训练,显著提升美术生产效率,降低外包成本,让IP形象延展进入自动化时代。
通过lora-scripts工具,食品企业可利用少量图片快速训练专属AI模型,批量生成符合品牌调性的高质量美食图像。该方法大幅降低拍摄成本,提升设计效率,支持多场景灵活应用,实现视觉内容的高效工业化生产。
通过LoRA技术和lora-scripts工具,普通人也能用少量图片训练出个性化的AI绘画模型。从数据准备、标注到训练参数调优,全流程可本地运行,低显存设备亦能胜任。小模型如乐高般灵活组合,让AI真正理解你的审美偏好。
通过lora-scripts与TensorBoard结合,实现LoRA微调过程中Loss的实时可视化。从数据准备、配置文件设置到启动训练和监控曲线,完整演示如何在本地快速搭建可复现的高效训练工作流,并提供常见问题诊断与工程最佳实践。
通过lora-scripts工具,普通人也能用少量图片训练出个性化的logo生成AI。整个流程从数据准备、标注优化到模型训练和部署,均被封装为可配置的自动化流水线,显著降低技术门槛。关键在于高质量数据与精准prompt描述,配合消费级显卡即可在几十分钟内完成模型训练,实现品牌风格的一键复现。
深入解析LoRA微调中学习率与batch size的协同作用,结合lora-scripts实战经验,提供针对显存限制、小数据集和生成效果不佳等问题的系统性调参策略,帮助在消费级显卡上稳定训练高质量模型。
利用LoRA技术与lora-scripts工具,可在少量标注数据和单卡GPU上高效微调大模型,实现医学影像描述的自动初稿生成。该方案显著降低AI落地门槛,提升报告撰写效率与规范性,同时保留医生终审权,适合临床团队快速部署。
LoRA训练常因环境配置、路径错误或显存不足而失败。掌握依赖管理、路径验证和显存优化技巧,能快速定位问题。数据质量与参数设置同样关键,避免训练结果失真。微调大模型时需使用PyTorch原生格式,而非推理专用的GGUF模型。
pytorch_lora_weights.safetensors 是基于LoRA技术与安全张量格式的轻量级模型扩展,仅保存低秩适配矩阵,实现高效、安全的模型微调与风格定制。它支持即插即用、多任务并行和动态加载,广泛应用于图像生成与垂直领域推理,显著降低AI定制门槛。
训练轮次epochs设置不合理会导致模型过拟合或欠拟合,影响生成质量。数据少时轮次不足学不会特征,数据多时过多轮次则死记硬背。lora-scripts虽简化流程,仍需根据数据量动态调整epochs,并结合loss曲线、试推效果和学习率协同判断,找到最佳checkpoint。
训练LoRA模型时Loss不降、震荡或NaN?这并非偶然问题,而是数据、配置或流程隐患的直接反映。从学习率设置到图像校验,从模型注入失败到过拟合陷阱,本文结合实战经验梳理四大典型Loss异常模式,并提供可立即执行的解决方案。掌握这些细节,让你在几百步内判断训练健康度,避免数十小时算力浪费。
LoRA
——LoRA
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 DAMO开发者矩阵

 火山引擎视频云技术社区


 乐奇 Rokid 开放社区


 2048 AI社区
 AtomGit AI 社区