登录社区云,与社区用户共同成长
邀请您加入社区
当代学术与工程体系存在显著的领域割裂问题:人工智能脱离物理具身逻辑、生命科学多停留在单点症状归因、基础物理过度依赖无实体数学抽象、社会经济评价脱离民生真实体验、教育与审美缺乏底层物质生化依据。为解决分科碎片化、表象化、玄学化的研究缺陷,本文建立大一统跨域系统思维框架。
帧不出进程、一行拿到、按色彩标签转对、转换回到 swscale 快路径——十年前那个「先渲染成图再用 CLI 拼」的作坊,到这一步可以歇了。你在 Rust 里做 ML,抽帧不该还要绕出去。(UniformN 配 4×3 略缩图网格)、(抽 RGB 存 PPM)、(关键帧代理)、(各采样策略对照)。。你现在的 Rust ML 管线,抽帧是走 shell-out、手写解码,还是别的路?欢迎评论区聊聊;
深度生成模型(Deep Generative Model)---生成对抗网络Generative Adversarial Networks(GANs)
1273:【例9.17】货币系统时间限制: 1000 ms内存限制: 65536 KB提交数: 13038通过数: 5442【题目描述】给你一个n种面值的货币系统,求组成面值为m的货币有多少种方案。【输入】第一行为n和m。【输出】一行,方案数。【输入样例】3 10//3种面值组成面值为10的方案1//面值12//面值25//面值5【输出样例】10//
题目题目链接题解动态规划。状态定义:dp[i][j]表示前i个砝码是否能称出重量为j的物品。状态转移:对于第i个砝码,选和不选两种情况;对于选又可以分为放在左边和放在右边。看样例,存在加和减的情况,也就是放在左边和右边的情况。我们规定放在左边用加表示,放在右边用减表示。那么第i个砝码的全部情况为第i个砝码不放、放左边或放右边。对于重量为j的物品,如果不放第i个砝码,则dp[i][j] |= dp[
将免疫概念及其理论应用于遗传算法,在保留原算法优良特性的前提下,力图有选择、有目的地利用待求问题中的一些特征信息或知识来抑制其优化过程中出现的退化现象,这种算法称为免疫算法(Immune Algorithm) IA。人工免疫算法是一种具有生成+检测 (generate and test)的迭代过程的群智能搜索算法。从理论上分析,迭代过程中,在保留上一代最佳个体的前提下,免疫算法是全局收敛的。摘自百
1292:宠物小精灵之收服时间限制: 1000 ms内存限制: 65536 KB提交数: 6298通过数: 3921【题目描述】宠物小精灵是一部讲述小智和他的搭档皮卡丘一起冒险的故事。一天,小智和皮卡丘来到了小精灵狩猎场,里面有很多珍贵的野生宠物小精灵。小智也想收服其中的一些小精灵。然而,野生的小精灵并不那么容易被收服。对于每一个野生小精灵而言,小智可能需要使用很多个精灵球才能收服它,而在收服过程
文章目录1.一元二次方程1.一元二次方程ax2+bx+c=0, a≠0ax^2+bx+c=0, \ a\neq0ax2+bx+c=0, a=0Δ=b2−4ac\Delta =b^2-4acΔ=b2−4acifΔ≥0 thenif \Delta \ge 0\ thenifΔ≥0 thenx1=−b+b2−4ac2a\quad \displaystyle x
试题 算法训练 数字游戏资源限制时间限制:1.0s内存限制:256.0MB问题描述给定一个1~N的排列a[i],每次将相邻两个数相加,得到新序列,再对新序列重复这样的操作,显然每次得到的序列都比上一次的序列长度少1,最终只剩一个数字。 例如: 3 1 2 4 4 3 6 7 9 16 现在如果知道N和最后得到的数字sum,请求出最初序列a[i],为1~N的一个排列。若有多种答案,则输出
1274:【例9.18】合并石子时间限制: 1000 ms内存限制: 65536 KB提交数: 9589通过数: 6136【题目描述】在一个操场上一排地摆放着N堆石子。现要将石子有次序地合并成一堆。规定每次只能选相邻的2堆石子合并成新的一堆,并将新的一堆石子数记为该次合并的得分。计算出将N堆石子合并成一堆的最小得分。【输入】第一行为一个正整数N (2≤N≤100);以下N行,每行一个正整数,小于1
到Apark Spark官网上下载Spark文件,无论是windows系统,还是MAC系统,亦或者Linux系统,都可以下载这个文件(独立于系统)。
import numpy as npdata = np.array([1,2,3])print(data.max())print(np.sqrt(data))#print(data.sqrt)import pandas as pddf=pd.DataFrame(data)d1=df.values#方法1#d2=df.as_matrix()d3=np.array(df)#方法2
用自已的话整理一下概率图模型里面的一些图理论读论文的时候先遇到的可分解图,那首先给出分解的定义:以上定义的1,3条都好理解,那么第2条的理解是,A集合B集中的节点之间的路径一定要通过S集中的节点,用图的条件独立性可以说,在S已知的条件下,A与B条件独立,A与B里面包含的节点是没有之间相连的。下面再看一下可分解图的概念总结一下就是一个无向图如果本身是完全图(也就是节点之间都是相互连接的)或者不是完全
在输入数学公式的时候,需要在数学公式的前后加入$符号,将需要输入的公式加入到$中间。行内公式$行内公式$行间公式?行间公式?角标(上下标)上标 ^下标 _名称数学表达式markdown公式上标aba^bab$a^b$下标aba_bab$a_b$分数\frac{ }{ } : 第一个{ }写分子,第二个{ }写分母。名称数学表达式markdown公式分数3+8a5b+6\frac{3+8a}{5b
切比雪夫不等式与大数定律是概率论的核心基础理论,二者紧密关联,共同揭示了随机现象的统计规律性。
已知一颗二叉树的遍历结果,对应的不同的二叉树有多少种?二叉树的数量与卡特兰数的关系是什么?
网上看到一篇关于这个论文的博客,居然还要花钱订阅,这就不能忍了,中国人不能欺负中国人。所以自己写博客,论文其实很好懂论文地址Learning Student Networks in the Wild (thecvf.com)代码地址GitHub - huawei-noah/Efficient-Computing: Efficient-Computing整体流程主要问题使用未标记的数据完成知识蒸馏,
NDCGNormalized Discounted Cummulative Gain累积增益CG,CG表示每个推荐结果相关性的分数的累加,CGk=∑i=1kr(i)CG_k=\sum_{i=1}^kr(i)CGk=i=1∑kr(i)其中relirel_ireli是位置iii的推荐结果的相关性,kkk是推荐列表的大小.如果我们考虑到位置对推荐的影响,比如,相关性高的应该尽量排在推荐列表的前面。
输入公式时,希腊字母再求助于mathpix,很浪费自己的点,其实也没什么难的,只要记住markdown语法,很容易书写的。仅作为书写时的参考。希腊字母大写Markdown小写MarkdownAAα\alphaBBβ\betaΓ\Gammaγ\gammaΔ\Deltaδ\deltaEEϵ\epsilonε..
本文系统介绍了有根树和有序树这两种重要的数据结构。有根树通过指定根节点建立层次结构,具有路径唯一性等特点,适用于文件系统、组织架构等场景。有序树在保持父子关系基础上强调子树顺序,在表达式解析、数据库索引中发挥关键作用。文章详细阐述了两种树的概念、特性、实现方法及核心操作,并通过文件管理系统案例展示了实际应用。最后指出这两种数据结构在人工智能、大数据等领域具有广阔前景,建议读者通过实践加深理解并探索
数据结构,蓝桥杯,acwing,数论
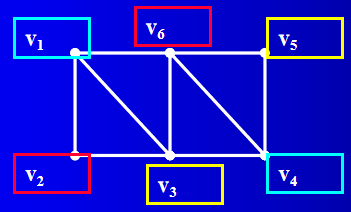
一、图的边着色(一)、相关概念定义1 给定图 G=(V,E)G=(V,E)G=(V,E),称映射 π:E→{1,2,3,...,k}\pi : E \to \{1, 2, 3, ..., k\}π:E→{1,2,3,...,k} 为 GGG 的一个 kkk 边着色,简称边着色,称 {1,2,3,...,k}\{1, 2, 3, ..., k\}{1,2,3,...,k} 为色集。若 π\piπ 为
写文章,做笔记都要用到markdown语法写出数学公式
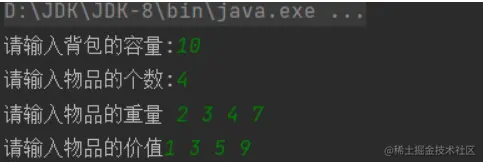
背包问题是一种组合优化的NP完全问题。问题可以描述为给定一组物品,每种物品都有自己的重量和价格,在限定的总重量内,我们如何选择,才能使得物品的总价格最高。
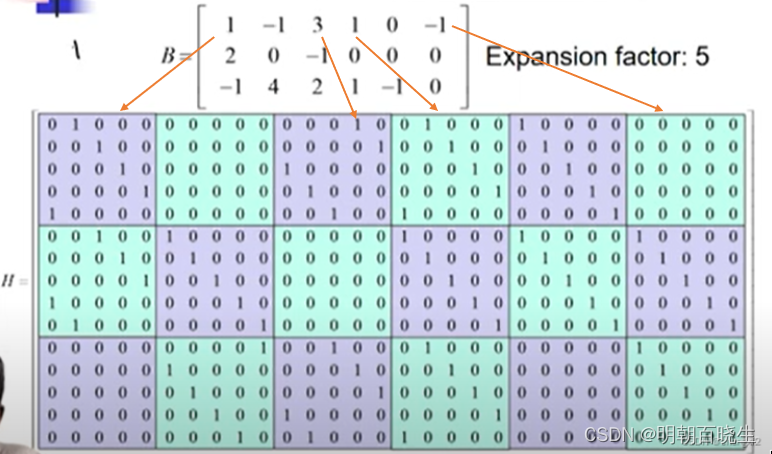
前言下面LDPC 介绍主要参考印度NPTEL,具体可以到外网阅读一下原文,分为8篇博客介绍完毕hello and welcome to this course on LDPC and polar codes in 5g .most of us use cellular phones and smartphones maybe many of usare using 4G cellular phon
A组,当然是 很 蓝 的 啦答案是n*m+3,无法节省步数先手必败无论先手怎么下,必定可以转化为xxxooooo然后,如果先手下第一行,后手就可以下第二行中间两个xxxxoxxo必败如果先手下第二行,则后手必定可以把第二行转化为oxxx或xxxoxxxo 或 xxxooxxx xxxo必败有种不好的预感啊,“必败”水,代码:#include<cstdio>#define LL long
3446. 骰子点数之和问题#include<bits/stdc++.h>using namespace std;vector<double>dp(100000);double probability(int n, int k){//返回n个骰子同时扔后点数之和为k的概率if(k<n) return 0;else return (double)dp[k]/pow(6,
1 什么是随机游走random walk?随机游走是由一系列随机步骤组成的随机过程。随机游走SN=每个连续随机步骤Xi的和。也就是说在N次游走时的位置SN是由第一次、第二次…第N-1次游走之后再加上此次游走之后的位置得到的。也可以写成:这意味着,下一个状态SN只依赖于当前状态SN-1与过渡XN,这也是马尔可夫链的主要性质。2 随机游走与布朗运动的区别是什么?随机游走的步长可以是固定的,也可以是变化
前置:文章中用到的数据链接:https://pan.baidu.com/s/1rKLM45dq_xIKxcI54Nq0qg提取码:c298公式:样本标准差公式年化收益波动率公式年化收益波动率公式可以转换为【标准差的平方*250,再取平方根】计算过程(jupyter notebook):import pandas as pdimport mathdf = pd.read_csv('temptemp.
#mermaid-svg-DRCWXUtjV0dqOc7d .label{font-family:'trebuchet ms', verdana, arial;font-family:var(--mermaid-font-family);fill:#333;color:#333}#mermaid-svg-DRCWXUtjV0dqOc7d .label text{fill:#333}#mermaid
leetcode解题报告
存在漏洞的版本:仅影响Apache HTTP Server 2.4.49版本推荐环境:GitHub - blasty/CVE-2021-41773: CVE-2021-41773 playground下载后:docker-compose build && docker-compose up如果遇到:则进入容器,修改vim /etc/apache2/apache2.conf最后一行加
题目内容完成两个多项式的相加操作:已知有两个多项式Pm(x)、Qm(x),设计算法实现Pm(x)+Qm(x)运算,而且对加法运算不重新开辟存储空间。要求用链式存储结构实现。例如:Pm(x)=5x^3+2x=1,Qm(x)=3x^3+x^2-2x-3,其计算输出结果为:8x^3+1x^2-2。算法分析本设计使用单链表实现。两个多项式相加算法的实现,首先是将两个多项式分别用链表进行存放。可以设置两个指
[](互联网面试八股文 - 知乎)
导语首先声明,本文基本转载于陈开江先生的《Bandit 算法与推荐系统》一文,加上笔者自己的结合目前推荐项目的理解。不准确之处,愿诸君指正。拜谢。推荐系统中经常会遇到EE问题和冷启动问题,在笔者项目过程中,无可厚非的遇到了冷启动问题。对于这两个问题,前者涉及到了平衡准确和多样,后者涉及到了产品推荐算法和运营。bandit算法就是为解决这两个问题的一种在线学习算法。一:什么是bandits算法1.1
多速率多传感器数据融合估计(一)对于多速率多传感器数据融合问题此处给出三种方法:1.状态分块线性模型的建立2.分布式无反馈数据融合算法3.分布式有反馈数据融合算法分两章阐述。问题描述设同步多速率系统的动态模型如下所示:Ci‾(k)=[Ci((k−1)Mi+1)Ini,1,Ci((k−1)Mi+2)Ini,2,…,Ci(kMi)Ini,Mi]\overline{C_i}(k)=[...
(有任何问题欢迎留言或私聊 &amp;amp;amp;amp;amp;&amp;amp;amp;amp;amp; 欢迎交流讨论哦markdown使用LaTex输入数学公式类Markdown数学符号&amp;amp;amp;amp;amp;公式CSDN-MarkDown编辑器使用手册(4)— 数学公式上下标:代码:$dp_{i}$$dp_{ar_{i}
卡尔曼滤波把不准的运动模型和不准的传感器合成当前最可信的状态,并同时给出不确定度。每拍先预测再更新:预测用模型前推并把协方差P撑大;更新用测量纠偏。增益K由P与测量噪声R算出,不是超参;要调的是过程噪声Q和R。P是此刻有多不确定,Q是模型每走一步还要再添多少不确定。机器人中常见于GPS与IMU融合、动态障碍跟踪。
<think>我们只需要根据内容生成摘要,控制在150字以内。先理解文章主题:介绍统计学中六种估计方法(MLE、MAP、LSE、BLUE、贝叶斯估计、KDE)的核心思想、数学形式及区别。摘要需概括主要内容和本质。 写一个简短的摘要,不超过150字中文。先草稿: 本文介绍统计学中六种基本估计方法:最大似然估计、最大后验估计、最小二乘估计、最优线性无偏估计、贝叶斯估计和核密度估计。它们基于不同推断哲学
本文总结了随机变量的数字特征,重点介绍了数学期望和方差的定义、性质及其计算方法。数学期望分为离散型和连续型两种情况定义,提出了随机变量函数的期望计算公式(换元公式),并详细推导了期望的线性性等6个重要性质。对常见分布(0-1、二项、泊松、几何、均匀、指数、正态)的期望值给出了具体计算过程。
本文介绍了C-R不等式(Rao-Cramer不等式)在参数估计中的应用。首先定义了Rao-Cramer正则分布族的五个条件,并通过Poisson分布和正态分布的例子验证其满足这些条件。然后给出了Rao-Cramer不等式的主要结论:对于Rao-Cramer正则分布族,任何无偏估计量的方差存在一个下界(C-R下界)。文章还讨论了该不等式的适用条件和特殊情况,指出均匀分布族不属于正则分布族,因此不等式
摘要: AB实验的核心是通过统计学方法从噪声数据中识别真实效应。P值衡量策略无效假设下观测结果的概率,小于0.05通常认为统计显著。置信区间提供效应量的不确定性范围,与P值互为补充。T检验是互联网AB实验的主力方法,适用于方差未知的场景,通过t统计量评估组间差异。工业界普遍采用T检验(尤其是Welch's变体),因其对样本量和方差假设更稳健。Z检验因需已知总体方差,在实际业务中基本被弃用。大样本下
摘要:伯努利分布是描述两种互斥结果的离散概率分布,核心参数为成功概率p。其概率质量函数(PMF)直接给出0-1结果的概率,方差在p=0.5时最大。作为二项分布的基础,广泛应用于质量控制、用户行为分析等领域。使用时需满足结果唯一性、概率稳定性和独立性三个条件。通过Python的scipy.stats模块可进行概率计算和随机模拟。
在数理统计学中,似然函数是一种关于统计模型中的参数的函数,表示模型参数中的似然性。给定输出x时,关于参数θ的似然函数L(θ|x)(在数值上)等于给定参数θ后变量X的概率:离散:连续此处并非条件概率密度函数。似然函数的主要用法在于比较它相对取值,虽然这个数值本身不具备任何含义。
第一部分:概率与统计基础第1节:基础概念:随机变量、概率分布、大数定律与中心极限定理
153 页,针对图 3-4-3,提出了一个问题:“点A到W上的一个点的距离有无穷多个。现在,我们最关心的是其中最短的那个,怎么找?请参阅 3.6 节。”并且,在 3.6 节,使用最小二乘法,找到了点A为终点的向量在W上的投影向量,那么这两个向量的距离就是“最短的那个”。但是,书中没有证明此结论。本文中将在介绍柯西—施瓦茨不等式的基础上,证明此上述结论。
(完)
朴素贝叶斯是一种基于贝叶斯定理的简单概率分类算法。它假设特征之间相互独立,这是其“朴素”的由来。例如,若有100封邮件,其中60封是非垃圾邮件,那么非垃圾邮件的先验概率。比如在非垃圾邮件类别中,单词“优惠”出现了10次,非垃圾邮件有60封,那么。对于所有类别都是相同的,在比较不同类别后验概率大小时可以忽略。为类别变量(如垃圾邮件和非垃圾邮件类别),为特征向量(如邮件中的单词出现情况)。在分类问题中
介绍了两种独立性检验方式——卡方独立性检验和 Fisher 精确检验,并进行了 Python 实现。
有一种有效计算条件概率的方法被称为贝叶斯准则
概率论
——概率论
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 DAMO开发者矩阵
 乐奇 Rokid 开放社区





 天工造物局