登录社区云,与社区用户共同成长
邀请您加入社区
摘要:一家快速发展的箱包企业在业务规模扩张后,原有的金蝶KIS系统已无法满足需求。2024年底企业启动金蝶云星空升级项目,并借助轻易云平台实现与管易、领星等系统的深度对接。通过数据集成,实现了订单处理时间从2天缩短至1小时,库存准确率提升至98%,财务核算效率提升7倍,解决了多系统数据孤岛问题。该案例展示了数字化升级如何有效提升企业管理效率,为同类企业转型提供了重要参考。
六自由度机械臂的模型预测控制是一个充满挑战和机遇的领域。通过合理建立机械臂模型,并精心设计MPC控制器,我们能够让机械臂在复杂任务中展现出高精度和高灵活性。当然,实际应用中还需要考虑更多因素,如模型误差、外部干扰等,但MPC的基本框架为我们提供了一个很好的起点。希望通过以上的介绍和代码示例,能让大家对六自由度机械臂的MPC有更深入的理解和兴趣,一起在这个领域探索更多的可能性。六自由度机械臂模型预测
在整个slam导航过程中,没有实体机器人的情况下,机器人本体建模是整个slam导航实现的最基础的内容;本节将利用rviz集成urdf讲解在机器人系统仿真过程中urdf语法的使用,以及如何利用这些语法进行简单的机器人本体设计。......
目前机器人学科的主流方向是通过扩大真实世界中的数据收集来尝试实现通用具身智能,但是和其他的基础模型,比如初版的 StableDiffusion 相比,即使是 pi 的数据都会少七八个数量级。因此获取足够的数据对于提升机器人的性能至关重要,但在当前实践中,针对新场景和新任务获取数据是一个从头开始不断重复的手动过程。研究者的愿景是完全在生成的虚拟世界中训练机器人,而核心在于找到精确控制语义组成和场景外
方法压缩比精度损失适用场景ONNX1x无跨平台部署量化2-4x<1%移动端/边缘剪枝2-5x1-3%模型压缩蒸馏5-10x2-5%大模型→小模型。
机器视觉,集成调试,人工智能
集成学习通过组合多个弱学习器显著提升模型精度,是机器学习分类与回归任务中的核心技术。Bagging通过自助采样降低方差,Boosting通过逐步拟合残差降低偏差,二者在不同数据场景下各具优势。MATLAB统计与机器学习工具箱将底层算法封装为fitcensemble和fitrensemble接口,用户无需手写随机森林或AdaBoost,即可快速完成模型训练,并借助交叉验证、超参数搜索、袋外误差分析等
集成学习通过组合多个基模型提升预测稳定性,随机森林作为Bagging思想的代表,利用双重随机性构建决策树并投票汇总,有效降低过拟合风险。在表格型数据、特征重要性分析等场景中,随机森林展现出强大的工程价值,尤其适合金融风控、客户流失预测等任务。掌握数据预处理、特征工程、参数调优及部署监控等实操要点,能显著提升模型性能与业务解释性。
集成学习通过组合多个基模型提升预测稳定性,随机森林作为Bagging代表,利用样本随机与特征随机降低方差。其技术价值在于对结构化数据鲁棒性强、调参成本低,广泛应用于用户流失预测、风控建模等场景。在scikit-learn中,通过交叉验证与网格搜索优化超参数,结合特征重要性分析可解释模型决策。本文围绕随机森林模型训练,详解数据预处理、超参数调优、过拟合排查及模型持久化等核心环节,提供可复用的工程实践
随机森林是一种基于bagging和特征随机采样的集成学习算法,通过构建多棵决策树并聚合结果来降低方差,对超参数不敏感且不易过拟合,是结构化数据建模的可靠基线。在工程实践中,随机森林模型代码需要覆盖数据预处理、特征工程、交叉验证、超参搜索和模型持久化等环节,确保训练与推理的一致性。该技术广泛应用于分类与回归任务,尤其适合中小规模数据集的快速验证。本文围绕一份可复用的随机森林模型代码,详细拆解其模块设
集成学习通过组合多个基学习器提升模型泛化能力,随机森林作为bagging与特征随机采样的代表,在表格数据上长期作为强基线。其核心原理是构建多棵决策树,通过投票或平均降低方差,对缺失值和异常值有一定容忍度。工程实践中,特征工程与超参数调优直接影响模型性能,而模型持久化与解释性分析是落地关键。在分类与回归任务中,随机森林广泛应用于金融风控、客户流失预测、销量预估等场景。本文围绕一份工程化随机森林模型代
一个成熟的AI Agent远不止提示词工程,而是一个集成Workflow、Tools、MCP、RAG、Memory与上下文工程的完整系统。它需具备理解业务、调用工具、规划任务、执行流程与持续迭代的能力。通过合理分工:用Workflow控制确定性流程,用Agent实现动态决策,以Tools连接真实业务,结合Memory与知识检索增强推理,最终构建可审计、可治理、可优化的智能应用。适合开发者在实际项目
2026年11月27-29日,全国多地将集中举办十余场国际学术会议,涵盖人工智能、智能控制、医学图像、网络安全、智能制造、能源互联网等领域。西安、广州、杭州、重庆、深圳等城市相继迎来多场高水平学术盛会,部分会议已开启终轮截稿,参会者可获参会证明及邀请函,欢迎学者踊跃投稿参会。
Google Sleep 框架用 wake/sleep 两阶段把上下文写进权重。本文以中文机制拆解为骨架,在关键位置逐字并列英文原文与官方英文原图,附核心术语、关键数字中英口径对照表,并列出复现性、算力代价与二手解析分歧。
AgentRouter 为开发者提供免费、高性价比的 AI API 接口服务,注册即送 175 刀乐额度。需使用注册满三个月以上的 GitHub 账号,通过 https://agentrouter.org/register?aff=eVJ9 注册,支持高效路由与低延迟调用,适用于 Agent 应用、智能客服等场景。名额限时开放,速领!
服务器繁忙是 DeepSeek 发展过程中面临的挑战,但也是其不断进步的动力。相信通过采取以上措施,DeepSeek 能够有效解决服务器繁忙问题,为用户提供更加稳定、高效、安全的服务,在人工智能领域再创辉煌!
solidworks在操作多个文件时,是避免不了来回切换的,在学习这个命令前我一直是用鼠标选择要显示的零件视图,很是不方便。具体操作方法是点击窗口按钮,然后选择下面的零件1或2。今天学会了一个新的技能就是按住CTRL+TAB按键就能快速的选择要显示的视图,可以节约很多时间了。
【代码】机器学习6:集成学习:集成学习思想、随机森林算法、Adaboost算法、GBDT、XGBoost。
本文深入解析XGBoost算法在机器学习竞赛中的优势,包括其高效计算、自动特征处理和强大的正则化设计。通过目标函数推导、树结构参数化表示和贪心建树算法详解,揭示XGBoost的核心原理。实战部分以Kaggle房价预测为例,展示数据预处理、模型调参和特征重要性分析的全流程,帮助读者掌握这一Boosting算法的应用技巧。
多个弱学习器组合成一个更强大的学习器,解决单一预测,进步一得到更好性能。# 导包from sklearn.ensemble import RandomForestClassifier# 随即森丽分类# 定义随机森立函数# 数据读取# 数据基本处理# 确定特征和标签# print(x)# print(y)# 空值处理(填充)print(x)# 处理字符类型 数据# 数据划分x, y,str
随着网络通讯的发展, PLC程序远程上下载、调试的技术已经非常成熟和稳定,该技术能帮助工程师远程进行设备维护,排除故障,使工程师不在忙于路途来回奔波,极大缩短了排故时间,提升了生产效率。(有兴趣交流,可联系。如上图,和网口连接的远程PLC地址为192.168.2.142,网口IP随便设置为该网段的一个IP,和这些PLC不冲突即可。2 点击“下一步”,因为AB系列 PLC的编程口是通过GRM的网口连
导航简介AdaBoost.M1算法步骤Python应用举例AdaBoost.M1算法原理的进一步推导一 简介之前文章的思路是建立并列的一系列树构成“投票委员会”提高结果的准确性,集成学习的另一个策略是将一系列具有顺序相关的弱模型组成一个强模型,而不会有过拟合的问题。从弱模型到强模型的常见集成学习法有提升法(Boosting)和梯度提升树(Gradient Boosted Decision Tree
从本节开始将介绍集成学习的思想,本节将介绍统计机器学习中用来衡量模型的重要指标——偏差与方差。
假定已经训练出一组学习器,那么,可以由这组学习器的输出结果作为样本,再以此训练出一个学习器,这就形成了二级级联形式。将投票视为一级,则基于投票法的算法(如,AdaBoost)也是级联。
集成学习meta Algorithmbaggingboosting算法复现meta Algorithm众人拾柴火更旺🔥,三个臭皮匠顶个诸葛亮这也是集成学习的一个比较关键的点。在深度学习出来之前,集成学习则是扮演着一个老大哥的角色。将多个弱学习(只比随机的结果好一点即可 例如判断硬币的正反面大于百分之五十。)进行组合起来达到一个强学习器的效果。其中比较著名的两种方法 bagging 和 adabo
1.LightGBM和xgBoost、GBDT的区别xgboost与LightGBM的区别切分算法(切分点的选取):XGBoost通过对所有特征都按照特征的数值进行预排序选取最好的分割点;LightGBM通过直方图算法寻找最优的分割点LightGBM占用的内存更低,只保存特征离散化后的值,而这个值一般用8位整型存储就足够了,内存消耗可以降低为原来的1/8LightGBM直接支持类别特征决策树生长策
引言主要讲了集成学习(Ensemble)集成学习的框架集成学习体现了一个团队合作的思想。(这里我改了一下李宏毅老师的例子,改成了LOL)。假设你有很多分类器,每个分类器扮演不同的角色,比如在LOL中,有的分类器是ADC,有的是TOP。这些分类器应该具有一定的差异性。把这些角色都集合在一起,形成配合,比如SUP控制,TOP抗,ADC输出。在Ensemble中有很多不同的方法,先来看...
集成学习是一大类模型融合策略和方法的统称,其中包含多种集成学习的思想。主要有Bagging与Boosting,当然还有Stacking。BoostingBoosting的过程很类似于人类学习的过程,我们会对错误的地方反复巩固学习,是不是每个人都有一本错题集反复练习。以后学习的时候,我们就针对翻过的错误加强学习,以减少类似的错误发生。如此反复,直到犯错误的次数减少到很低的程度。所以Boost...
【机器学习】集成学习总结
本篇博文主要总结关于Adaboost的相关内容。设训练数据集T={(x1,y1), (x2,y2)…(xN,yN)}初始化训练数据的权值分布 :对于m=1,2,…M:使用具有权值分布Dm的训练数据集学习,得 到基本分类器Gm(x)表示第m次生成的基本分类器,这个基本分类器可以是逻辑回归,可以是SVM等等都可以。计算Gm(x)在训练数据集上的分类误差率 计算Gm(x)的系数显然误差率越小,
大数据毕业设计:电影推荐系统 数据分析 可视化大屏 爬虫 集成学习 Stacking模型融合多种机器学习算法 KNNWithZScore推荐算法 (建议收藏)✅
这是一个专为科研人员设计的论文润色助手,能够以大模型的专业知识来补充用户输入的文字,修正用户语言的语病,逻辑错误,并提供中英双语的论文版本。qwen agent的官方demo由gradio实现,因此我们在本地或者云端部署agent时,也应该了解一些gradio的简单知识:radio是一个用于简化机器学习模型部署的Python库。它的目标是让用户可以轻松地构建交互性的界面,用于与机器学习模型进行交互
代码规范化解决方案Eslint + PrettierEslint 是一个插件化的 javascript 代码检测工具 , 用于代码格式检测,不符合Eslint规则的代码会被检测到发出警告、报错。通过 .eslintrc.js 文件可以进行自定义的Eslint规则配置...rules: {'no-console': process.env.NODE_ENV === 'production' ? 'w
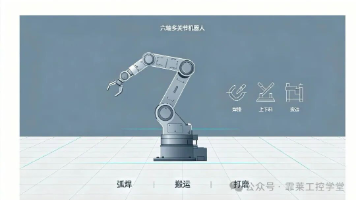
智能制造发展推动工业机器人岗位需求增长。主流机型包括六轴多关节、SCARA、协作机器人和桁架机械手,各自适配不同场景与行业。新人应优先掌握六轴机器人,因其应用广泛、岗位需求高;后续可拓展SCARA、协作机器人等。薪资取决于技能全面性,而非单一机型。建议聚焦通用性强的机型,避免盲目钻研冷门设备。理清结构差异,建立系统认知,可有效降低入行试错成本。
OpenCode 是一款基于 VS Code 内核开发的开源轻量级代码编辑器,它继承了 VS Code 的优秀特性,并在此基础上进行了创新和优化。其具备跨平台的特性,能够在 macOS、Linux、Windows 等多种主流操作系统上稳定运行,为不同系统的开发者提供了统一且高效的编程环境。凭借代码高亮、智能补全、Git 集成、终端内置、插件扩展等丰富且实用的核心功能,OpenCode 成为了众多开
面经分享,持续更新中
该博客主要收集集成电路设计中遇到的问题
1.更新策略选择①optimization-based和多步方法IGSM:成功率高;转移性低。(可能“过拟合”or陷入局部最优)②单步方法FGSM: 成功率低;转移性高。所以用: MI-FGSM:2.集成方式选择MI-FGSM还不够,得利用集成网络来进一步提高成功率。利用的方式有3种待测试:①输入softmax的logits②softmax输出的prediciton③计算得到的...
但是在运行的时候,尤其是在输入问题的逻辑性变强之后就会出现报错:httpcore.ReadTimeout: timed out问题。可以看到在创建模型调用的时候,并没有设置对应的超时时间,简单的处理方法可以在其中加入timeout参数值,并设置一个比较大的值。不少小伙伴在使用gradio构建自己的AI应用时,玩玩采取的是大家熟系的方式创建调用模型。简单通过加入timeout参数无法解决,可能是通过
body的代码是API中的API测试示例,如图11所示,可根据实际情况进行修改,完成后,点击send。就是API中的回调地址中的标准格式,右键复制,如图10所示粘贴到图9中的②即可;四、Postman调试。2、Postman地址。
内容来自CodeWave智能开发平台社区进行了OAuth2认证集成&单点登录SSO解决方案直播后平台优质开发者的实践分享gitee 类似github 创建应用不需要审核,相比于微博还需要审核应用。生产环境访问地址: http://ainews-qa.app.codewave.163.com登录方式:OAuth2认证Gitee 对接文档参考 : https://gitee.com/api/v5/oa
缓冲区可以按照任何粒度或地址对齐的6种分配模式进行分配缓冲区可以由用户插入(非重叠)缓冲区可以通过地址或句柄来解除分配缓冲区可以通过地址或句柄在内存空间中搜索缓冲区支持有效载荷,可以由用户分配,随机生成,读取和比较。实现快速缓冲区搜索算法除了这些功能之外,YAMM还提供调试功能(例如,内存镜像存储,使用情况统计),并且很容易将其与现有验证环境集成。
集成学习
——集成学习
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 快递鸟社区

 地瓜机器人开发者社区


 北京朝阳AI社区



 乐奇 Rokid 开放社区







 DAMO开发者矩阵

 openEuler 社区



 天工造物局