


- @weixin_60200880


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
pandas常用技巧(agg函数+transform函数),agg函数的使用的方法是:agg(新列名=("原列名", "统计函数"))
在读表格的这一部分的时候,首先会观察p值,确定是否有任何项的p值大于设置的显著性水平𝛼。很明显,对模型来说理想的状态是拒绝原假设、接受备择假设,因此在我们规定的显著性水平𝛼(0.05)下,如果有任意项的p值大于𝛼,则说明当前项的系数没能通过显著性检验,模型对当前项的系数没有足够的信心。相对的,01和03号模型的AIC较高,这两个模型都通过系数的单变量检验,但在残差的白噪声混成检验中出现问题,
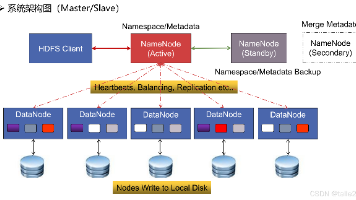
HDFS采用主从架构,NameNode管理元数据,DataNode存储数据块。文件按128MB分块存储,默认3副本保证容错。NameNode通过fsimage和edits日志管理元数据,JournalNode集群确保edits高可用。读写操作通过客户端与DataNode建立管道传输,实现高效数据存取。HDFS提供安全模式保护机制,并通过HA高可用(Active/Standby NameNode)和
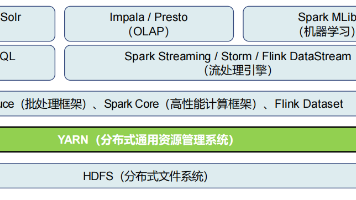
YARN是一个分布式资源管理系统,采用主从架构(ResourceManager和NodeManager),支持多种计算框架(如MapReduce、Spark)。其高可用性通过ZooKeeper实现主备切换和元数据同步。YARN提供三种资源调度策略:FIFO(先进先出)、Capacity(预设队列资源比例)和Fair(动态公平分配)。Capacity调度器允许队列弹性使用空闲资源,而Fair调度器默
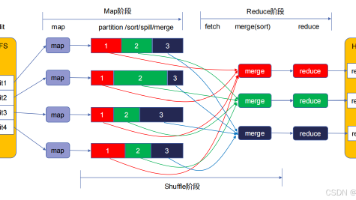
摘要:MapReduce是一种用于大规模数据并行处理的编程模型,它将计算任务分为Map和Reduce两个阶段,通过移动计算而非数据实现并行处理。MapReduce适用于离线批处理场景。其工作原理包括数据切分、Map任务处理、Shuffle阶段和Reduce任务汇总。典型应用如WordCount词频统计,通过哈希取模确保相同Key分发到同一Reduce节点。但MapReduce因大量磁盘I/O和网络
大白话介绍了Spark的核心概念和运行机制。首先概述了Spark作为高效分布式计算框架的优势,重点阐述了RDD(弹性分布式数据集)的特性及其转换/动作算子分类。文章详细分析了RDD的两种依赖关系(窄依赖和宽依赖)及其对性能的影响,并深入讲解了Spark程序架构和三种运行模式(Local、Standalone、Yarn)。最后通过词频统计示例,说明了Spark从逻辑查询计划到物理查询计划的转换过程,

Hive中的分区和分桶是优化查询性能的两大核心技术。分区通过按业务维度(如日期、地区)划分数据目录,实现快速过滤;分桶则基于列值的哈希将数据均匀分布到固定数量的文件中,优化JOIN、采样等操作。分区适用于低/中基数字段,分桶适合高基数字段。实际应用中常先分区后分桶,形成多维优化结构。分区裁剪减少I/O,分桶提升计算效率,二者配合可避免全表扫描。但需注意避免过度分区导致小文件问题,以及分桶列选择不当
Hive SQL提供了四种排序方式:order by(全局排序,单reducer)、cluster by(分区排序,同一字段)、distribute by + sort by(分区和排序分离)以及sort by(局部排序)。order by适用于小数据量全局排序,需注意strict模式下需用limit限制;cluster by实现分区内升序排序;distribute by负责分区,sort by负
本文介绍了Hive中行转列和列转行的常用函数及实现方法。行转列部分讲解了concat、concat_ws字符串拼接函数,以及collect_list、collect_set聚合函数,并通过实例展示了多行转单列的实现过程。列转行部分重点解析了explode函数和lateral view侧视图的使用,详细说明了如何将单列数据转换为多行数据。文章提供了完整的SQL示例代码和运行结果图示,帮助读者理解Hi
本文介绍了两种Hive解析JSON数据的方法:get_json_object和json_tuple。get_json_object每次只能提取JSON中的一个字段值,而json_tuple可以一次提取多个字段值,属于UDTF函数。文章通过示例展示了如何从包含设备名称、类型、信号强度和时间等字段的JSON数据中提取信息,并最终转换为Hive表的列格式。两种方法都能有效解析JSON字符串,其中json