- @weixin_52392194


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
链路追踪是监控分布式系统性能的重要手段。它通过记录请求在各个服务之间的传递过程,帮助开发者了解系统的运行状态,定位性能瓶颈,并提高系统的可观测性。链路追踪的核心思想是将一个请求的整个生命周期可视化,提供一个完整的视图,以便开发者能够轻松跟踪和排查问题。在分布式系统中,每个请求可能会经过多个服务,每个服务的处理时间都可能对最终的响应时间产生影响。链路追踪通过对请求的标识符进行跟踪,能够将这些时间数据
MVC(Model-View-Controller)和MTV(Model-Template-View)是两种常见的设计架构,广泛应用于Web开发中。MVC架构将应用程序分为三部分:模型(Model)、视图(View)和控制器(Controller)。模型负责数据和业务逻辑,视图处理用户界面,控制器负责接收用户输入并调用模型和视图的协调。在MVC架构中,控制器是核心,它负责处理用户的请求,将请求传递

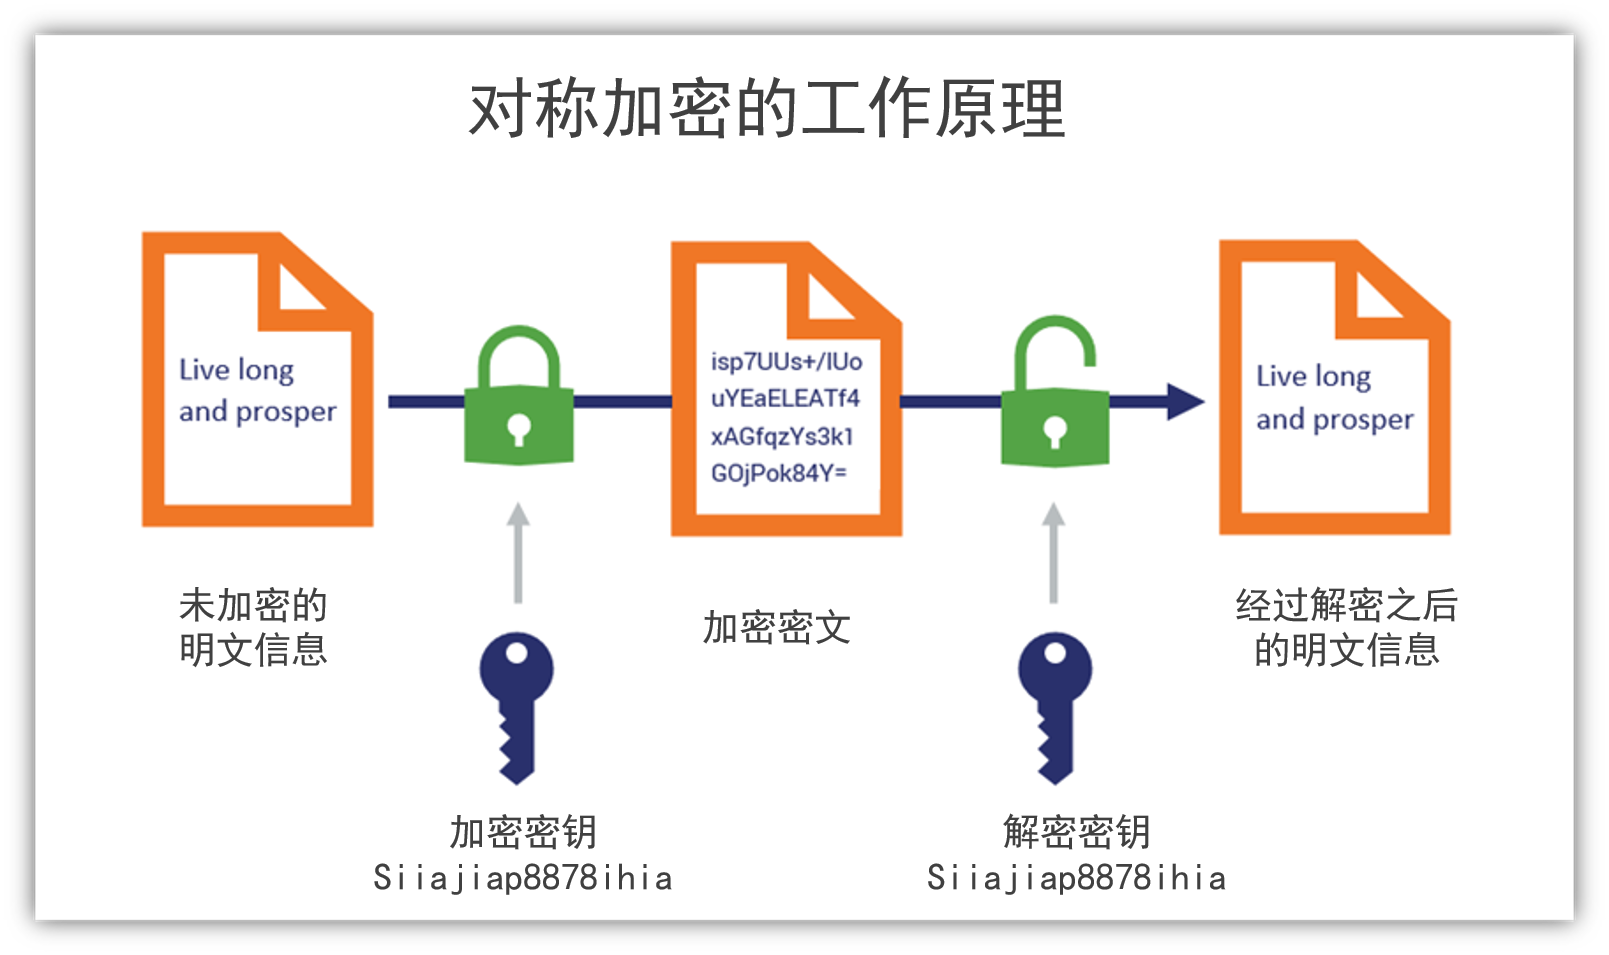
以上示例展示了 DES 和 AES 对称加密算法的基本使用方法,以及如何在 Python 和 JavaScript 中实现这些算法。此外,还涵盖了一些拓展用法,例如加盐、密钥衍生、修改加密算法参数等。这些方法为实际应用中的加密需求提供了丰富的解决方案。
RSA(Rivest-Shamir-Adleman)是一种广泛使用的非对称加密算法。它利用了大数因数分解的困难性来确保加密的安全性。RSA 算法的关键特征在于它使用一对密钥:公钥和私钥。公钥用于加密数据,而私钥用于解密数据。
ARIMA的主要目标是通过建模时间序列的趋势、周期性和随机波动来进行预测,尤其适合处理非平稳的时间序列数据。SARIMA在ARIMA模型的基础上,增加了季节性自回归、季节性差分和季节性滑动平均成分,用来处理数据中的周期性波动。在处理时间序列数据时,传统的统计方法如ARIMA和SARIMA虽然有效,但它们对数据的线性假设限制了它们在更复杂的非线性数据中的表现。长短期记忆网络(LSTM)是一种特殊的递
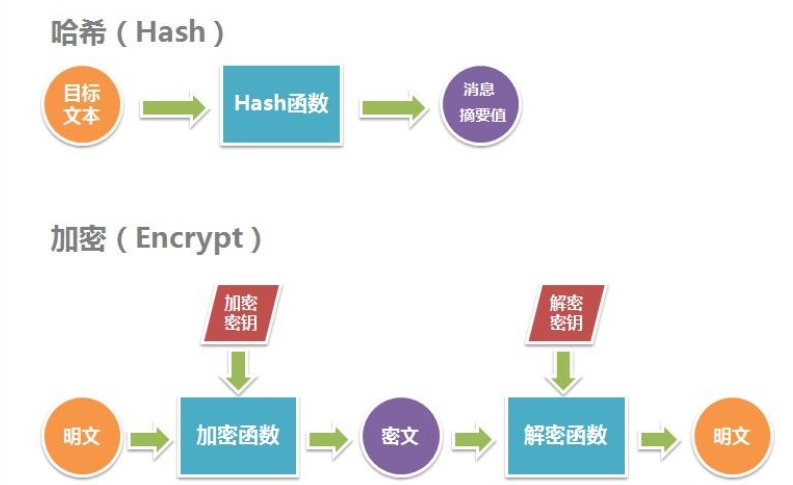
Python 爬虫中的哈希算法基础:SHA1、SHA256、SHA512、MD5 和 HMAC
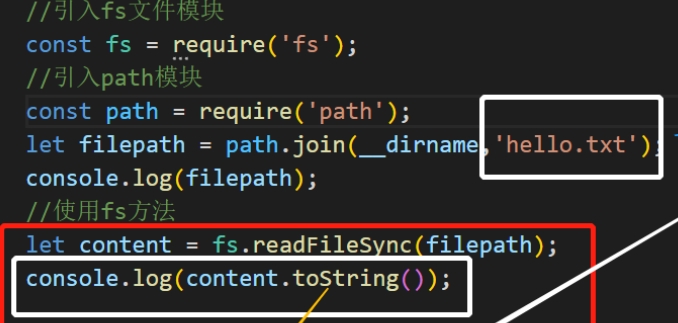
async关键字用于定义异步函数,异步函数会自动返回一个 Promise 对象。通过使用async函数,可以将异步操作的代码写成类似于同步代码的形式,从而提高代码的可读性。// 定义 async 函数try {console.log('文件内容:', data);console.error('文件读取失败:', err);readFile();在这个例子中,readFile函数被定义为async函
通过以上内容,你可以深入了解 Scrapy-Redis 的分布式结构、环境搭建、源码优化、Redis 队列机制、调度器功能、优先级管理、管道处理以及分布式爬虫的部署与实战。调度器的主要职责是从 Redis 中获取请求并将其分发给爬虫实例,同时将响应结果放回 Redis 中,以便后续处理。: 爬取的数据可以存储在 Redis 中,或者通过 Scrapy 的管道将数据存储到其他数据库中。类是 Scra

Gerapy 是一个基于 Scrapy 的爬虫框架,专注于爬虫项目的管理和集群部署。下面将详细介绍如何搭建 Gerapy 环境,并进行初步配置。Gerapy 可以通过 pip 安装。安装完成后,可以使用gerapy命令来检查是否安装成功。安装完 Gerapy 后,你可以创建一个新的 Gerapy 项目。这将创建一个名为myproject的新目录,其中包含了 Gerapy 所需的基本目录结构和配置文
Feapder 是一个高效的 Python 爬虫框架,专为处理大规模数据抓取而设计。它提供了简单的 API 和强大的功能,支持任务调度、异步处理、分布式爬取等特性。与 Scrapy 等传统框架相比,Feapder 更注重大规模数据采集的效率和灵活性,适合需要处理亿级数据的企业级应用。Feapder 的核心包括爬虫管理、任务调度、数据存储和中间件处理。它的设计理念是高性能和高可扩展性,使得用户能够轻