- @zyplanke


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
SpringBoot各配置加载顺序、生效覆盖关系(生效优先级关系)。并在本地基础上,与Nacos配置中心一起,观测Nacos配置与本地配置加载顺序、生效覆盖关系bootstrap.yamlbootstrap.propertiesbootstrap-{profile}.yamlbootstrap-{profile}.propertiesapplication.yamlapplication.prop
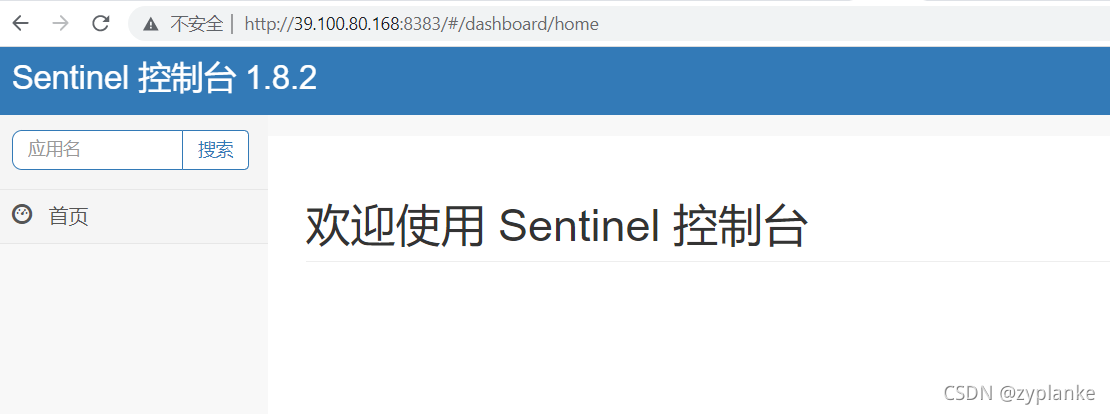
在Sentinel控制台中,对payment服务新增一条流量规则,如下:另:若QPS阈值为0,则相当于全部按失败处理。在控制台定义规则后,会自动把规则传输给应用程序(这里即payment应用程序)。规则的存放和执行都是在应用程序端完成。控制台只接收应用程序的报告,本身不存放这些规则(仅在内存中暂存)。这时在调用payment使用时,则sentinel会执行此流控规则。超过此规则的会按规则定义返回失
一、背景由于elasticsearch(简称ES)的HTTP访问,默认不需要密码。意味着谁都可以访问,谁都可以修改,这样非常不安全。因此需要增加一些安全机制。 对于ES 1.x的低版本可以使用http.basic, 但对于ES 2.x及以上,则应该使用search-guard。它作为ES的插件。elasticsearch(ES) 6.8.3 版本, 对应的 search-guard为:25.5。

本文介绍了Kubernetes中Ingress的概念与实现方式。Ingress作为L7层的HTTP/HTTPS路由机制,可以基于URL路径、Host头等内容进行流量分发,为多个Service提供统一入口。文章详细演示了如何安装Nginx Ingress Controller,包括清单文件修改、外部负载均衡器模拟配置等步骤。并通过两个示例展示了单Host多路径和多Host两种Ingress规则配置方

vLLM是一种用于大规模语言模型(LLM)推理的框架,旨在提高模型的吞吐量和降低延迟。vLLM通过优化内存管理和调度策略,显著提升了模型在高并发场景下的性能。vLLM利用了一种名为PagedAttention的注意力机制,该机制借鉴了虚拟内存和分页技术,以减少缓存内存(KV Cache)的浪费,并允许在请求之间灵活共享KV缓存。这种设计使得vLLM在保持与现有系统相同延迟水平的情况下,能够将吞吐量
vLLM是一种用于大规模语言模型(LLM)推理的框架,旨在提高模型的吞吐量和降低延迟。vLLM通过优化内存管理和调度策略,显著提升了模型在高并发场景下的性能。vLLM利用了一种名为PagedAttention的注意力机制,该机制借鉴了虚拟内存和分页技术,以减少缓存内存(KV Cache)的浪费,并允许在请求之间灵活共享KV缓存。这种设计使得vLLM在保持与现有系统相同延迟水平的情况下,能够将吞吐量
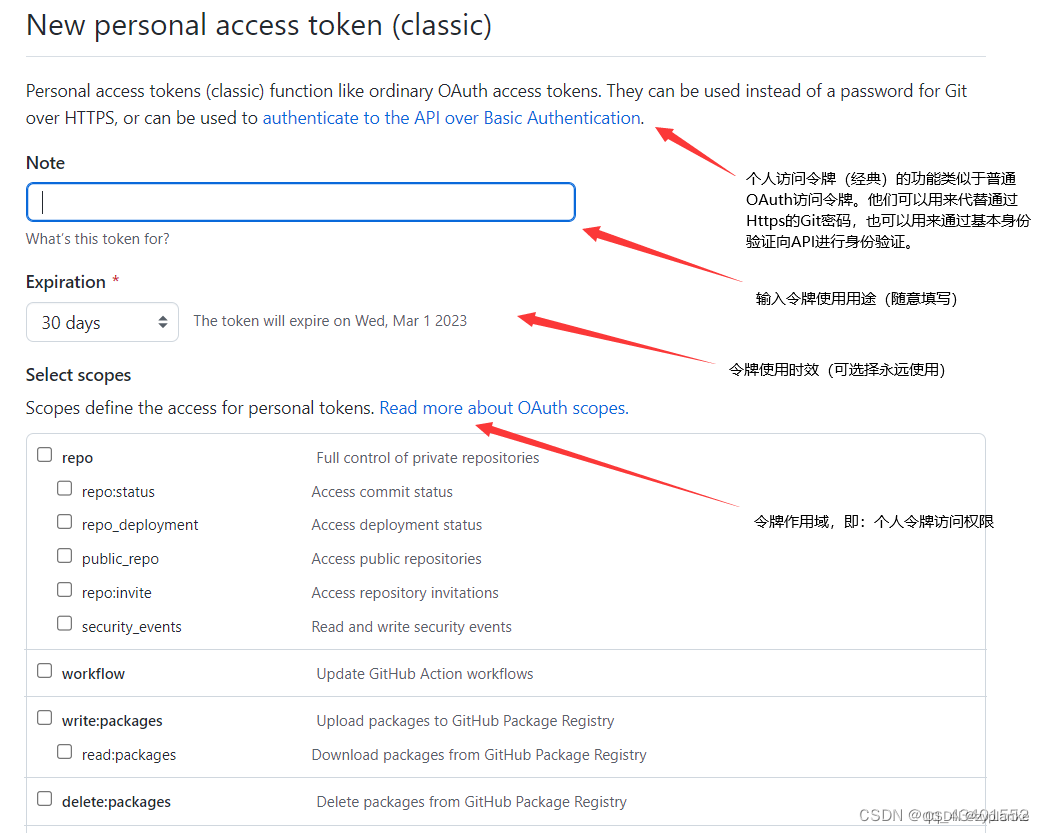
登录GitHub,在GitHub右上角点击个人资料头像,点击Settings →。如果在与远端仓进行交互操作过程中,自动弹出需要账户/密码,可按图所示进行操作。在界面上选择点击【Generate new token】,填写如下界面。将该配置文件中remote的地址进行修改。根据需要进行勾选,通常需要将repo及子项进行勾选。如果为已经clone过的本地仓,则打开本地仓下的。除了直接修改配置文件,也
本文假设已经掌握SQL基本语法和数据库基础概念。包括表空间、数据库、模式、表、索引、关闭自动提交AUTOCOMMIT

Node.js v18.x或更高,Node.js官方是在Ubuntu 20.04, Debian 10, RHEL8,CentOS8等高版操作系统上编译得到,所需glibc≥2.28。所以下载Node.js后也需要glibc版本≥2.28才能使用,否则报GLIBC_2.27' not found错误。而CentOS 7.x等操作系统自带的glibc版本为2.17。贸然升级glibc,很可能导致操作

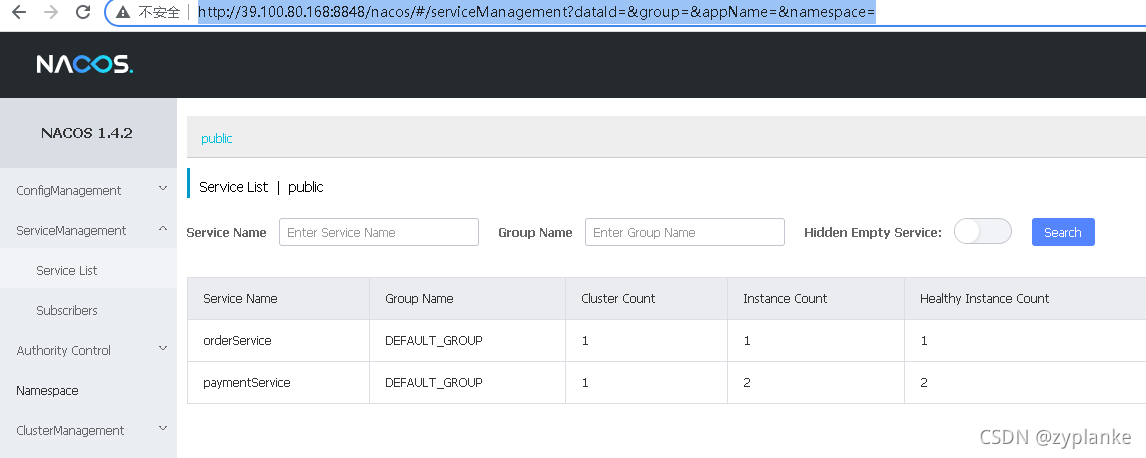
服务提供方:payment服务消费方:order服务(需要调用payment服务)以上均在一个project工程,但分属不同的模块modulenacos服务端已经安装完毕并启动。