


- @JEREMY_GYJ


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
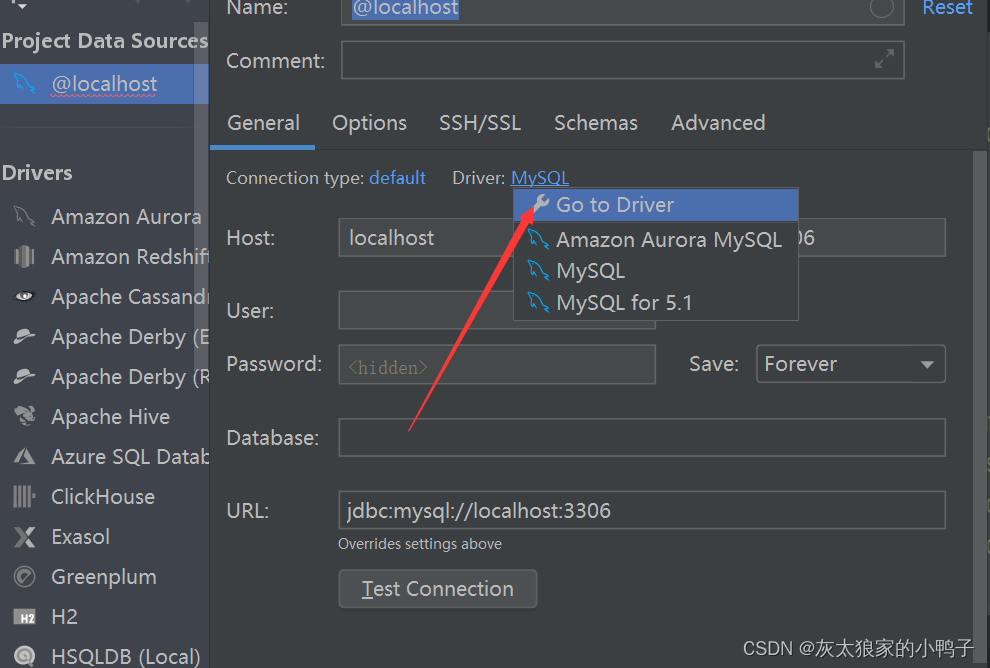
解决:1. 手动加入jar包2.选择自己maven仓库中存在mysql-connector3. 选择完毕后,确定使用:4. 进行测试连接
【代码】SpringBoot中Druid数据库连接池的配置。

NearMiss 是 Mani 等人根据数据分布特征,基于 KNN 算法提出的欠采样方案, 对多数类样本利用随机欠采样来达到数据平衡。根据不同数据采样的距离,可以分为三类: NearMiss-1、 NearMiss-2 和 NearMiss-3。NearMiss-1 对于每个多数类样本,选择与少数类样本最近的k 个并计算这k 个少数类样本的平均距离,保留平均距离最小的多数类样本;NearMiss-
【代码】pytorch中的torch.zeros_like(x)
自监督学习:词向量的实现:Skip-gram的实现

其中 NTotal 是总组成残基的长度(例如,如果长度为 L 的蛋白质片段残基为 31 且 k = 0、1、2、3、4 和 5,则NTotal = L - k - 1 将是分别为 30、29、28、27、26 和 25)。其中 L 表示蛋白质序列片段 P 中来自中心位点的上游残基或下游残基的数量,如果ai是蛋白质序列片段 P 中的第 j 个位置残基,则 xi,j = 1,否则 xi,j = 0。N

解决:这时如果安全组已经开放了37199端口,那肯定是服务器防火墙没有开该端口。查看防火墙开放的端口,发现37199没有开放。

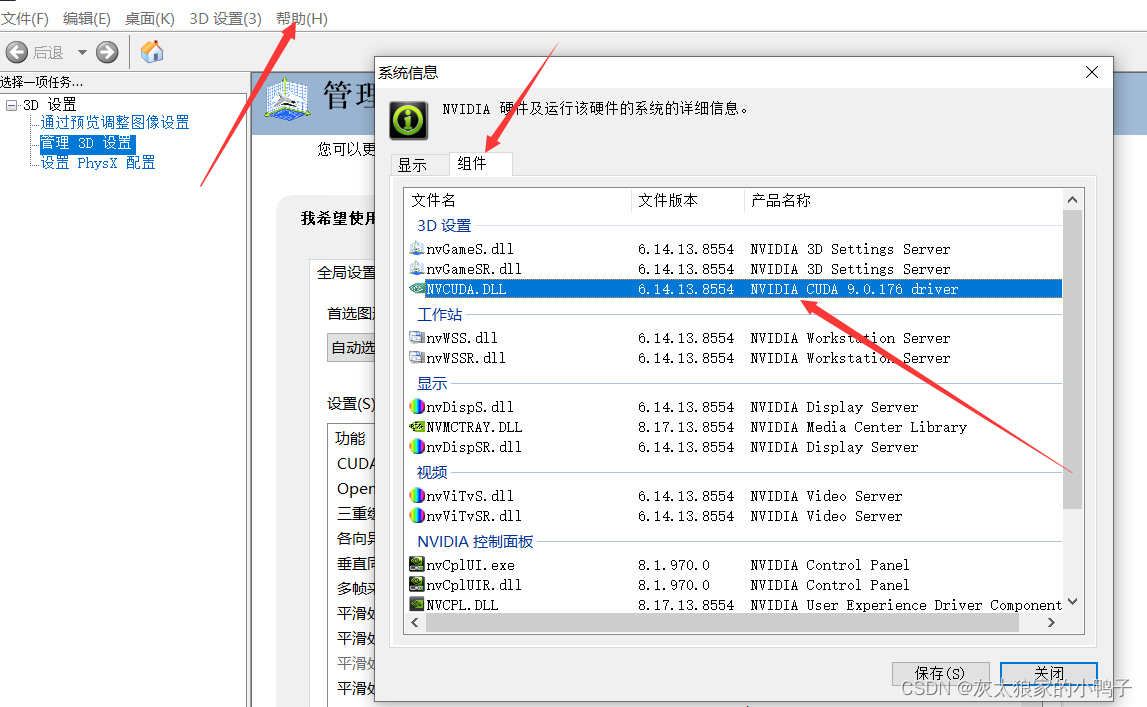
先鼠标右键查看对应的CUDA的版本:根据本机的CUDA、cuDNN版本确定python及TensorFlow版本。如下表所示:tensorflow_gpu版本Python 版本cuDNNCUDAtensorflow_gpu-2.4.03.6-3.88.011.0tensorflow_gpu-2.3.03.5-3.87.610.1tensorflow_gpu-2.2.03.5-3.87.610.1
只有特征值,没有目标值(聚类:划分类别)。对于一份没有标签的数据, 有监督算法就会无从下手, 聚类算法能够将数据进行大致的划分, 最终让每一个数据点都有一个固定的类别。算法分类:聚类k-means,降维算法;异常检测、可视化。
