- @lady_mumu


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
在智能工业制造外观缺陷质检、医疗影像报告辅助生成、电商图文混排审核以及自动驾驶场景理解等现代 AI 商业化场景中,纯文本大语言模型已无法满足业务需求,正在成为企业智能化升级的全新主战场。本文深入剖析基于的端到端生产级系统落地实战。
在构建高吞吐数据流预处理管道、高频在线推理请求分发网关或分布式强化学习(RL)经验收集池时,多进程之间的是最基础的核心架构。然而,传统的 Python 进程间通信(如)在底层依赖于操作系统的是现代高性能操作系统与金融高频交易领域皇冠上的明珠。通过在 POSIX 共享内存中利用底层 CPU 硬件提供的,我们能够实现本文深入剖析基于 C++ / ctypes 绑定的多进程无锁环形队列实战。
在大模型与深度学习训练工程中,是将 GPU 显存占用减半、矩阵乘法算力翻倍(打满 Tensor Core)的核心底层基石。然而,许多开发者在从传统的单精度(FP32)切换到低精度浮点数时,经常被各种诡异的NaNGradScaler本文从出发,深度解构 FP16、BF16 与 FP8 的数值物理极限与溢出防御实战。
np.load()操作系统内核提供的mmap是解决超大规模异构数据按需加载的终极底层武器。通过mmap,Python 进程能够将磁盘上的 TB 级二进制大文件!本文深入剖析基于mmap与np.memmap的高性能大张量缓存引擎实战。
在人工智能与自然语言处理开源生态(如 HuggingFace Datasets、ModelScope 或 GitHub)中,发布一个高质量的数据集绝非仅仅是将一个train.json压缩包上传了事。由微软、斯坦福大学等联合提出的,已成为全球顶级学术共同体与工业界发布数据集的。本文详解 Datasheets for Datasets 的核心架构,并提供一份标准的 HuggingFaceREADME.
在人工智能与自然语言处理学术界,撰写一篇能够被 ACL、EMNLP、NeurIPS、ICLR 等顶级国际会议或权威 IEEE/ACM Trans 期刊录用的高水平论文,本质上是一场**“严密科学论证、数据因果归因、排版视觉美学与学术伦理诚信”的综合工程实践**。。为了帮助青年学者和算法工程师建立无懈可击的顶会写作标准,本文对第三周的科研写作方法论进行全景提炼复盘。
微调阶段:无脑选择;量化导出:生产环境首选;高并发部署:通用大盘选vLLM,长前缀与 Agent 场景选SGLang。遵循这一套经过实战检验的工具链决策树,团队能够在算力成本与响应延迟之间取得极致的商业平衡。
在现代人工智能算法工程化与企业级 MLOps 体系中,“模型开发”仅仅是万里长征的第一步。当算法从单机研究走向时,任何一个工程链条的脆弱都会导致数十万元算力账单的蒸发或严重的线上安全生产事故。回顾过去一周(Week 3)我们在“实验管理工程”专栏中的系统化建设,我们构建了一套。本文对第三周的实验管理与可观测性基建方法论进行全景提炼复盘。
在以数据为中心的人工智能(Data-Centric AI)工程实践中,许多团队往往在模型训练遇到瓶颈时陷入“盲目调参、更换复杂架构”的泥潭。。回顾过去一周(Week 3)我们在“数据质量管线”专栏中的深入钻研,我们从等多维视角,沉淀了一套。本文对第三周的数据质量治理方法论进行全景提炼复盘。
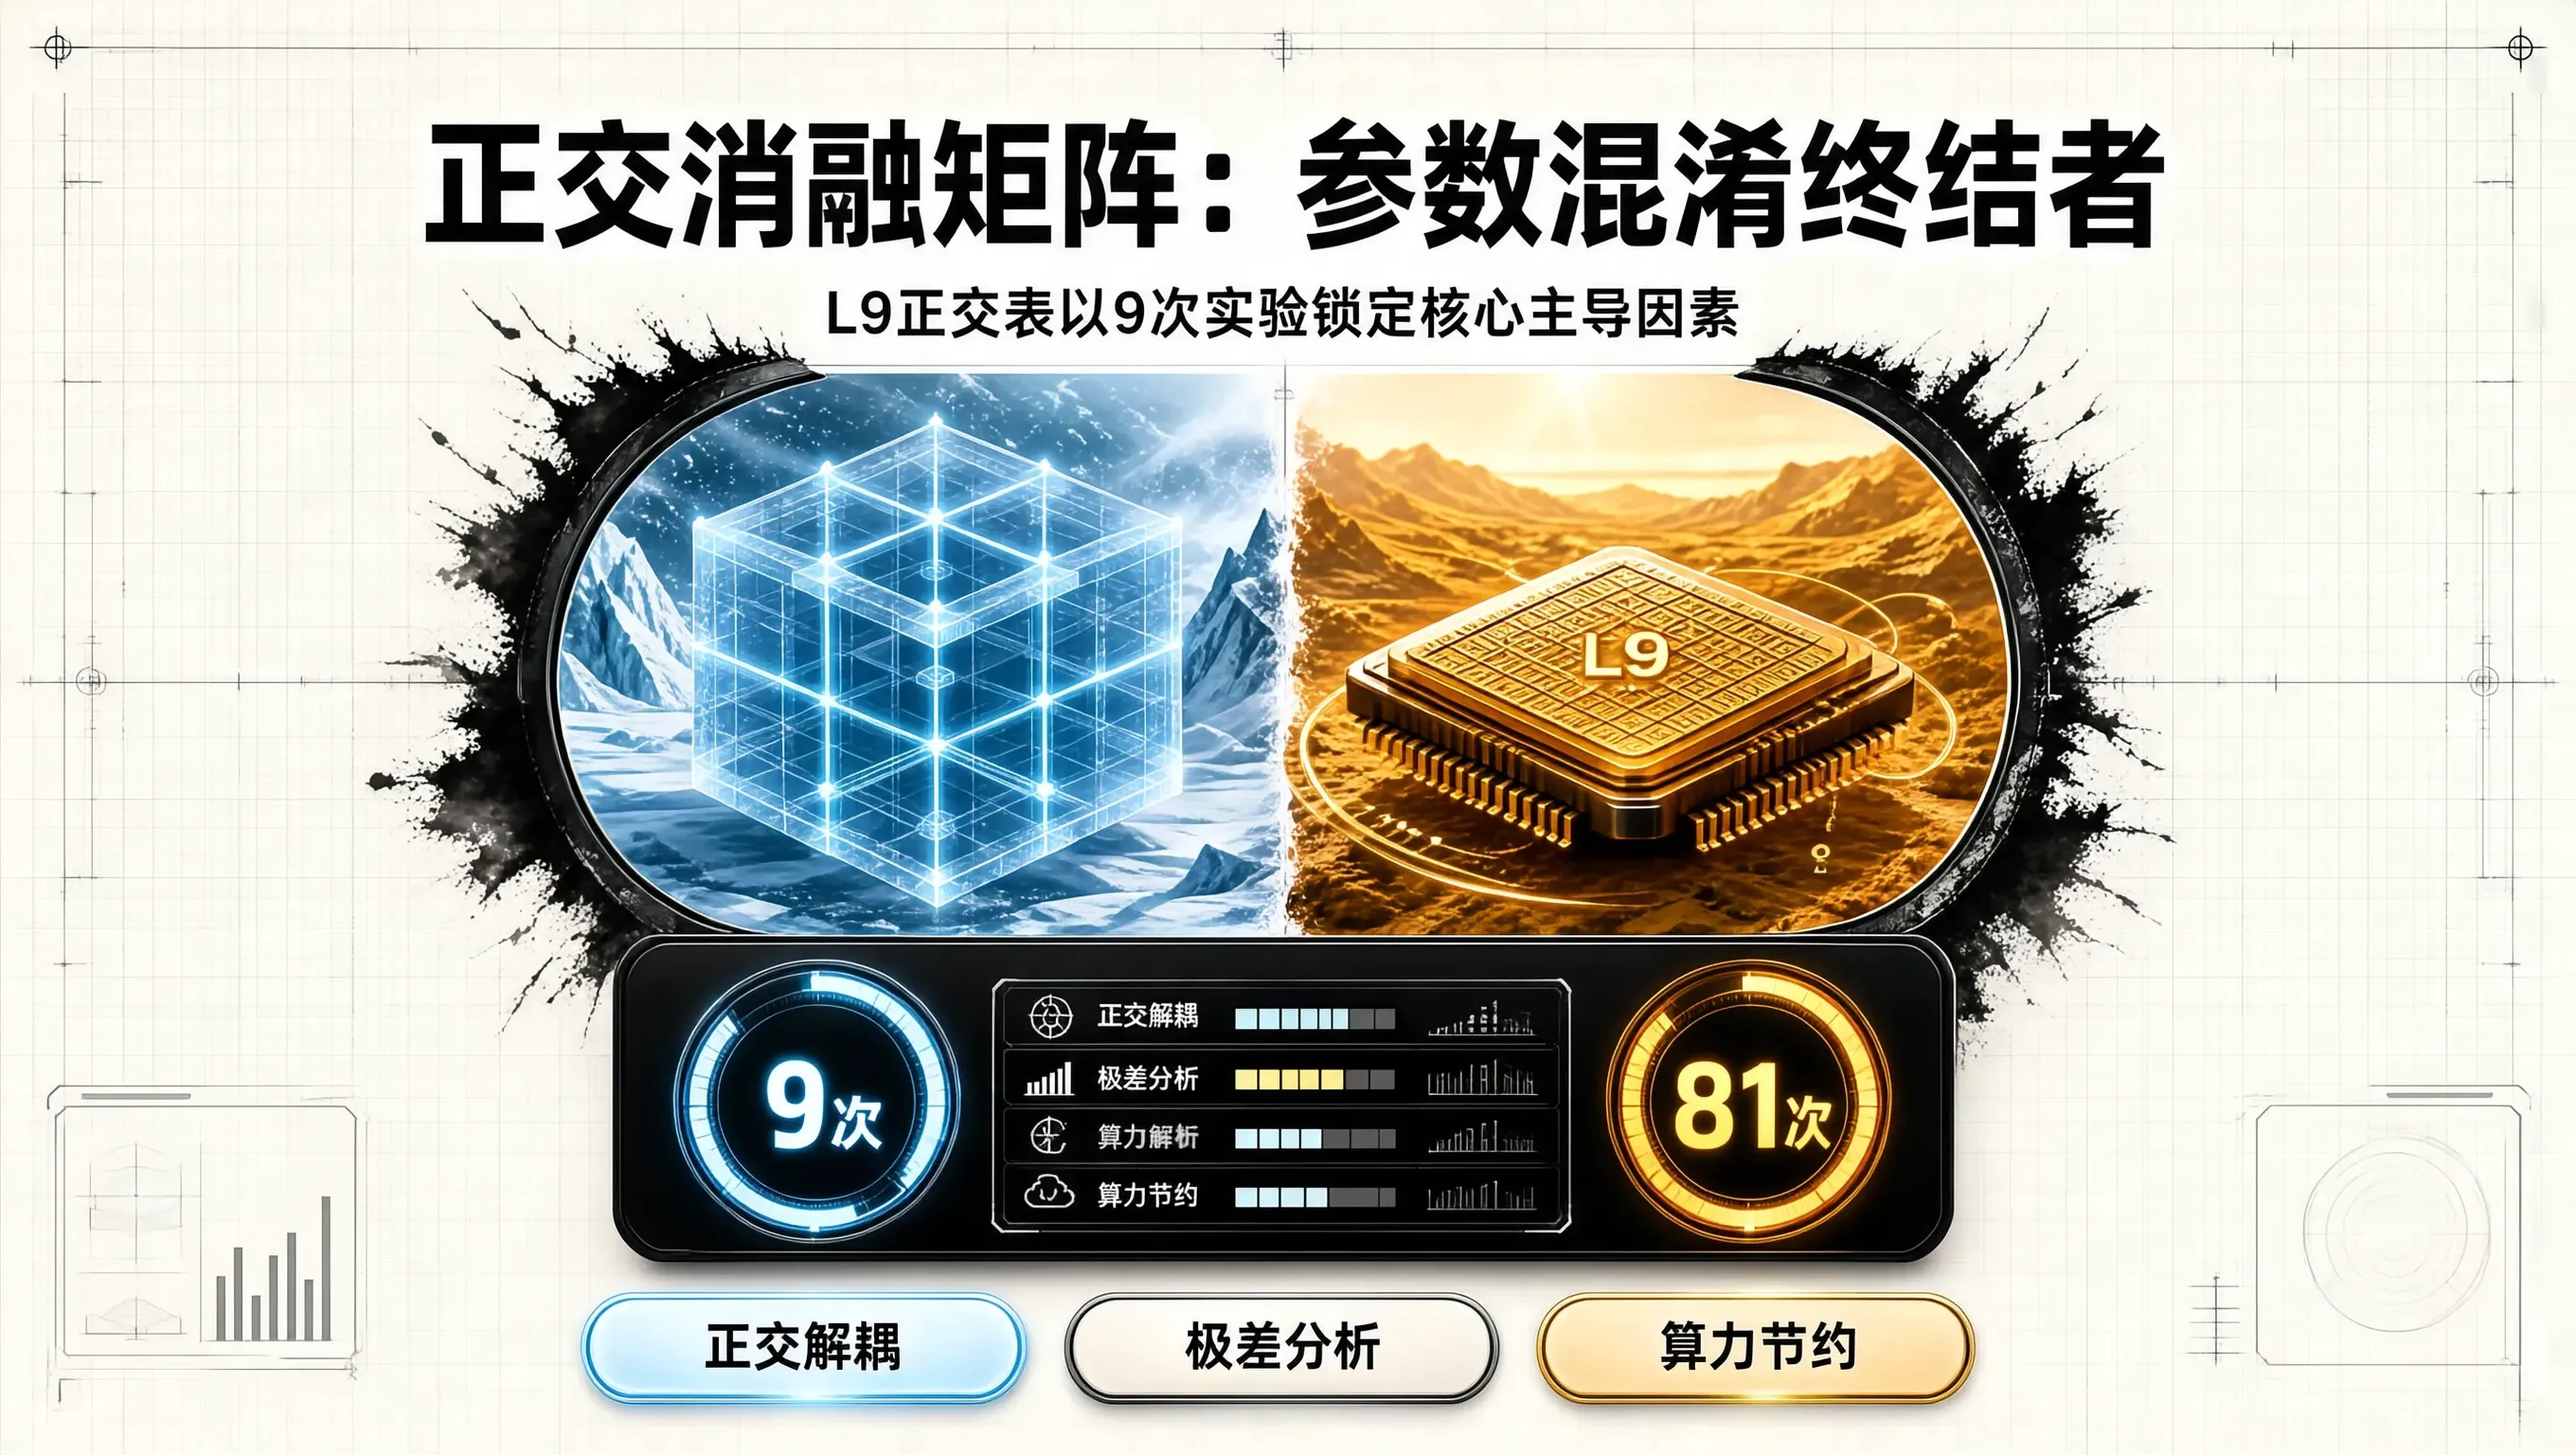
在深度学习消融实验(Ablation Study)中,最棘手的情况往往是**“多因素相互耦合(Factorial Confounding)”**:如果要对所有可能的组合进行全因子网格遍历(Full Factorial Grid Search),需要执行 $3^4 = 81$ 次全量训练,这需要耗费数十万 GPU 算力小时,在科研预算上是完全不可承受的。而如果只随意消融其中 2 个变体,又无法证明不