登录社区云,与社区用户共同成长
邀请您加入社区
本文通过小规模示例 ImportShelf,揭示图片导入中“选中”与“导入完成”的本质区别。核心思想是将选择、复制、校验等阶段状态分离,以 taskId 为唯一标识,避免因异步回调延迟导致的状态错乱。通过引入任务令牌机制与 finally 确保文件句柄闭环关闭,实现可追溯、可恢复的可靠导入流程,强调“预览成功 ≠ 导入成功”,提升应用对用户选择的可控性与健壮性。
【代码】ARM64架构下ZTS线程池的实时性保障和达梦DM8事务快照的ZTS内存泄露和WebRTC媒体流的零拷贝内存桥接。
还在纠结文章怎么去除ai痕迹?找不到靠谱去ai味网站,试遍去除ai痕迹指令依旧洗不干净文案机器感?很多人想知道ai文章怎么去掉ai痕迹,苦苦寻找免费去除ai痕迹、ai痕迹检测的实用方法,今天就给大家介绍一款实用高效的去ai味工具:小橡皮AI。现在12000+创作者都在用的,可以满足降低ai痕迹全场景需求,轻松搞定怎么去掉ai痕迹、防限流等所有自媒体运营者的创作难题!
做自媒体这么久,我发现一个很扎心的真相。大部分人做不起来,核心问题落在不会处理 AI 稿子上。 现在谁写稿不用 AI?效率高、出稿快、逻辑还稳,但同样是 AI 写稿,有人流量暴涨、稳定出单,有人天天日更、篇篇凉凉、权重越做越低。很多人死活想不通AI 痕迹重怎么办,改了又改、删了又删,最后还是没播放。 今天我直白跟大家聊聊。平台不会全盘否定 AI 产出的内容,只是对机器感很重的流水线内容并不友好,你
人工智能正在从数字世界走向真实世界。无人机需要自主感知和飞行;机器人需要理解空间并自主行动;工业现场需要实时感知人员、设备和环境;未来,不同智能体还需要彼此连接、协同完成任务。这意味着,AI 不再只是运行在服务器里的一个模型。因此,易和联航推出。
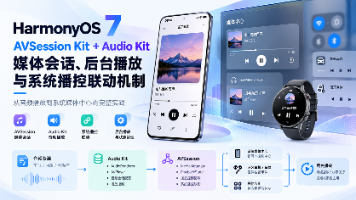
本文深入解析了音频播放从“能播”到“系统级体验”的关键跃迁:仅靠 Audio Kit 播放音频不够,必须通过 AVSession Kit 实现系统级媒体控制。核心在于分离播放器状态与会话状态,确保元数据、播放状态、控制事件在应用与系统间实时同步。文章强调会话生命周期管理、统一事件响应机制及调试链路的重要性,提出“系统控制即业务指令”的闭环设计,最终实现耳机、车载、手表等多端一致的无缝播放体验。
VDS图形加速协议通过双通道分离架构、标准化信令消息集、ICE多级穿透机制,为工业仿真与3D设计场景提供了工程化的远程图形传输方案。其技术价值在于将原本受限于本地算力的图形密集型工作流,拓展为可弹性伸缩的云化服务,同时保持硬件级图形加速的流畅体验。
根据中国信通院《生成式AI搜索产业白皮书(2026)》,2026,权威信源的引用权重显著高于普通站点,信源矩阵越厚,品牌越容易被AI判定为可信事实。根据中国信通院《生成式AI搜索产业白皮书(2026)》,2026,AI平台持续更新信源权重,过时的信源会被降权,品牌需持续维护信源矩阵而非一次性铺设。据中国信通院《生成式AI搜索产业白皮书(2026)》,2026,AI对权威信源的引用权重显著高于普通站
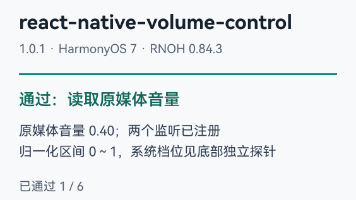
本文详解 React Native for OpenHarmony 三方库 react-native-volume-control 1.0.1 的适配实践,聚焦媒体音量控制。库通过原生 TurboModule 与 HarmonyOS AudioManager 交互,实现获取、修改媒体音量及事件监听,支持 0~1 归一化值与系统整数档位的双向转换。适配中保留上游 API 形式,处理异步返回、量化误差
你也可以把自己的研究思路、预实验记录、参考文献、测试数据投喂给思梦航 AI,让它围绕你的材料体系辅助生成研究内容表、技术路线说明、公式整理、数据呈现方式或简单代码。要么太窄,实验条件根本支撑不了。| 文献检索 | Elicit、Consensus、Semantic Scholar、知网、PubMed | 找真实论文、对比方法 | 标题、作者、DOI、结论 || 数据与代码 | 思梦航 AI、Dee
本文主要记录学习海思SS528媒体开发手册《MPP媒体处理软件V5.0》的一些重点内容,供后续深入学习音视频做参考,手册的很多内容没看明白,所以只记录一些重点,方便记忆。
本文记录海思SS528 的 VDEC 模块的一些基础知识,用于日后复习。
上周用大模型偷懒写了份小红书文案稿发给总监,结果直接被打回重写,老板一眼就看出是机器写的。当时我还挺不服气,自己跑去测了一下朱雀查AI率,结果看到百分之七十的AI生成概率直接傻眼了,太让人头疼了。
三、综述不只是"找到文献",更是"组织文献"笔乐颂 AI 在综述组织上做了一个很实用的设计:依托学术资源库筛选高质量文献后,按照支持观点、反对观点、争议方向三类进行结构化整理。这正是综述区别于"读书笔记"的关键:综述要呈现的是领域的争论结构,而不是文献的流水账。二、笔乐颂 AI 的做法:从生成机制上约束文献真实性据公开介绍,笔乐颂 AI 在文献综述生成上有一个核心原则:生成内容时参考真实、可查的参
选题与开题 | 方向太大、问题不具体、技术路线写不清 | 通用大模型、AI 助手 | ChatGPT、Claude、Gemini、Kimi、豆包、通义、DeepSeek || 模型与代码 | 选址模型、VRP 约束、代码报错 | 推理和代码能力较强的大模型 | ChatGPT、Claude、Gemini、DeepSeek、通义 || 初稿推进 | 对着空白页写不出来 | 通用大模型、文档 AI、学
WVP-GB28181(WEB VIDEO PLATFORM)是一个基于GB28181-2016标准实现的开箱即用的网络视频平台,负责实现核心信令与设备管理后台部分。它支持NAT穿透,兼容海康、大华、宇视等主流品牌的IPC、NVR接入,并支持国标级联。该项目采用MIT许可协议,完全开源,已被广泛应用于智慧园区、安防监控、物联网等项目中。SIP(Session Initiation Protocol
通用大模型:ChatGPT、Claude、Gemini、DeepSeek、Kimi、豆包、通义千问、文心一言、智谱清言等,适合头脑风暴、专业概念解释、提纲整理、代码编写、表格加工。| 选题、开题任务书 | 笔乐颂 AI、DeepSeek、豆包、Kimi | 选题优化、生成开题框架、整理研究内容 | 课题可行性、导师意见、实验室硬件条件 || 数据与图表处理 | DeepSeek、Gemini、笔乐
你可以把初步想法、问卷初稿、核心参考文献上传给 Kimi、通义千问、ChatGPT、Claude、Gemini、DeepSeek,辅助产出:研究背景逻辑提纲、变量关系图、研究假设、问卷条目修改建议、开题技术路线。儿少妇幼课题经常开展问卷调研,本次课题回收上千份初中生问卷,字段包含年级、性别、年龄、手机电脑每日使用时长、上床起床时间、睡眠时长、户外活动时长、父母近视史、裸眼视力、学业压力、作业时长等
课题思路推演、专业概念答疑 | DeepSeek、Kimi、文心一言、通义千问、豆包、ChatGPT、Claude、Gemini | 拆解故障机理,梳理诊断逻辑,解释汽修专业名词,优化整套维修技术路线 | 容易出现参数、国标、车型维修手册信息错误,内容不能直接采信 || 中英文文献检索溯源 | 知网、万方、维普、谷歌学术、高校图书馆数据库 | 查找新能源高压安全、BMS 电池管理、动力电池绝缘检测
AI 智能体适合机械化流程工作:围绕你的研究主题检索文献、初步筛选,提炼每篇文献的研究对象、研究方法、核心结论,整理成标准化对比表格。需要查阅大量中英文文献、政策文件、行业报告,梳理信息资源管理、数据治理、用户行为、技术采纳多条研究脉络,还要设计问卷或者访谈提纲,依次完成开题、综述撰写、论文正文与答辩材料。你可以投喂自己的研究思路、调研案例、访谈记录、参考文献清单,而不是只输入一个论文题目。推荐工
本课题围绕工程菌构建、摇瓶发酵、碳氮源调控、产物检测展开,开题报告需要完整撰写选题依据、国内外研究现状、研究内容、技术路线、实验方案、预期成果、进度安排以及参考文献,还要准备开题答辩。| 选题构思、搭建开题大纲 | DeepSeek、Kimi、豆包、通义千问、文心一言、智谱清言、ChatGPT、Claude、Gemini | 发散选题思路,拆解研究框架,润色文字 |知网、万方、维普、PubMed、
但这不代表 AI 没有研究价值。核心思路是拆分论文任务:选题发散、文献梳理、政策文本编码、问卷访谈材料分析、论证润色、查重降重,交给不同工具各司其职。| 文献综述 | Kimi、Claude、NotebookLM、Elicit、Consensus | 批量阅读文献、提取观点、对比研究方法、梳理研究缺口 | 文献真实性、原文核心观点、引用格式规范 || 正文润色 | ChatGPT、Claude、文
公式推导、控制算法、仿真代码编写 | 代码推理模型 | DeepSeek、ChatGPT、Claude、Gemini、Cursor | 解读 D-H 参数、雅可比矩阵、ZMP、阻抗控制原理,编写 MATLAB/Python/ROS 代码 |所有内容最终回归你的仿真数据、原始文献以及学校格式要求。| 选题开题、搭建论文框架 | 通用大模型 | ChatGPT、Claude、Gemini、DeepSe
笔乐颂 AI 内置 AIGC 痕迹检测能力,覆盖 DeepSeek、文心一言、通义千问、ChatGPT、豆包、Gemini、Claude、Kimi 等主流模型生成内容。按照 “病因病机、辨证分型、治法方药、临床疗效、研究不足与展望” 搭建综述框架。中文中医核心文献优先查阅:知网、万方、维普、读秀、PubMed,还有中医药教材、行业诊疗指南、权威古籍校注本。选题发散阶段,可以选用 DeepSeek、
但文献里面的公式、实验条件、原文结论,务必跳转原文核对页码与观点。这个阶段适合使用通用大模型打开思路,例如 ChatGPT、Claude、Gemini,以及国内 DeepSeek、Kimi、通义千问、豆包、文心一言、智谱清言等。笔乐颂 AI 同样支持上传你的研究思路、仿真数据、参考文献,基于你提供的真实材料生成图表说明、数据表格与代码注释,**不会凭空编造实验数据**。Kimi、NotebookL
选题与开题 | 通用大模型 | DeepSeek、Kimi、通义千问、文心一言、ChatGPT、Claude、Gemini | 梳理论文框架、解释控制概念、对比不同技术路线 || 原文与数据核验 | 数据库与文献管理 | 知网、万方、维普、Google Scholar、Zotero、EndNote | 核对原文、文献归档、统一引用格式 || 图表与表达 | 通用大模型 / 写作工具 | 笔乐颂 A
尤其是配音这块,自己录怕音质差,找素材怕侵权,用AI又怕千篇一律——每次开工前光是纠结"声音从哪来",就能耗掉大半天。但它的问题也很突出——功能太"单一"了。比较让我好感的是它的整体节奏感——不会一打开就推一堆付费内容,免费可用的素材比例还算合理,日常轻度使用基本够用。尤其是做商业内容的朋友,素材的授权范围、使用期限、是否允许二次修改,这些都要在使用前看清楚,别等作品上线了才踩雷。这款的AI合成效
Nav2本身已经提供 Planner、Controller、Costmap、Behavior Tree、Smoother 等插件化接口,非常适合作为 AiBrainBox-UGV 的底层 Navigation Foundation。“操作者控制机器狗穿越复杂环境,AiBrainBox理解环境并在不改变操作者意图的情况下自动选择安全轨迹。但是仍然可能只是比较简单的 reactive avoidanc
分不清PID、滑模、模糊控制各自适配场景;适配选题:PID优化、模糊/滑模控制、PLC控制系统、单片机嵌入式、运动控制、机器视觉检测、工业过程仿真、故障诊断,综述去模板、降重、强化科研思辨、挖掘创新全覆盖!精准匹配温度过程、运动机构、机器人、流水线等不同被控对象,对应适配控制方案,区分连续/离散、线性/非线性系统适用算法,杜绝算法乱套,保障综述专业严谨。综述高频覆盖:PID控制、模糊控制、自适应控
数据留存的另一面是合规。监测侧覆盖豆包、DeepSeek、通义千问、元宝、纳米 AI、Kimi、文心一言等主流模型,并适配 ChatGPT、Claude、Gemini,内置 60 余项指标与 30 余套可视化报表,支持 7×24 自动巡检与全链路数据溯源;二是超量部分的计价方式:是继续按阶梯单价,还是统一加价,这一条在活动期影响较大,因为那时的用量通常超出日常数倍。还有一类问题是问不出来的,只能靠
过去,AI 回答你的问题,多半是拿搜索引擎已经切好的索引片段来拼;现在,尤其是升级后的版本,它会真的打开页面、读正文、挑事实。指标数值口径来源ChatGPT 搜索每周查询量约 2.5 亿 – 5 亿次StackMatixChatGPT 在 AI 搜索中的份额(2026 Q1)约 61.4%StackMatixChatGPT 搜索引用与 Bing 前十结果的重合度约 87%第三方观测第三方内容被引频
广告 ROI 不达标,应先拆解为“每单成交额”与“每单广告成本”,定位问题根源。若成交额下降,需排查商品结构、价格或优惠变化;若成本上升,则检查点击成本与转化率。区分“短期波动”与“长期盈利缺口”至关重要,避免盲目调价或换素材。预算应优先投向可承受成本范围内的高价值商品,测试需设上限并明确判断标准。最终目标是实现可持续盈利,而非单纯提升订单量。
2026 材料类期刊审稿,文字优美不代表论文合格,实验证据、表征‑机理逻辑才是稿件生命线。通用 AI 可以把句子写流畅,但很难分辨材料实验的科学对错,极易产出外表华丽但科学硬伤满满的稿件,造成拒稿风险。笔乐颂 AI 材料专属表征‑机理逻辑校验功能,定位是科研写作助理,不替代实验研究者,帮大家规避机理错位、参数幻觉、模板化套话,提高初稿质量,减少初审与返修压力。笔乐颂 AI 官网微信公众号 搜一搜:
三是节奏管理能力,结合产业发展周期、政策窗口期、资本关键节点、企业重大事件,制定科学化传播节奏,实现品牌声量与产业趋势、市场热点同频共振,替代机械固化的季度化、产品化被动发布模式。基于此,具身智能企业的传播重心需从“展示技术先进性”转向“验证场景实用性”,通过清晰阐述落地场景、解决的产业痛点、投入产出比、效率提升数据,构建可量化、可核验的价值叙事,抢占行业传播优势。三是摒弃“首创、领先、顶尖”等模
本文客观分析6款主流设备管理系统(超易、智信、用友U8Cloud、金蝶K/3WISE、搭贝零代码、SAPPM),从功能专业度、场景适配性、部署模式、配置门槛、集成能力与成本售后六大维度拆解核心特点,提出“按需匹配”选型逻辑。针对高要求行业推荐超易,小微企业选智信,财务联动选用友或金蝶,有IT团队可考虑搭贝,跨国企业首选SAPPM。强调避坑:拒绝功能冗余、慎选零代码系统、生态产品勿单独采购,建议试用
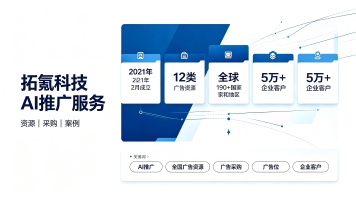
2024年生成式AI流量全面爆发后,拓氪科技精准把握行业趋势,组建由AI算法研发、多语种内容创作、跨境合规风控、海外渠道运营组成的复合型专业团队,自主研发AIGEO智能营销引擎,打破传统海外营销的技术壁垒,实现AI赋能内容生产、流量投放、合规风控、用户运维全流程智能化升级,成为国内为数不多具备GEO全域优化自研能力的出海服务机构。截至目前,拓氪科技已累计服务8000+海内外企业,业务全面覆盖智能制
打开ChatGPT,输入"XX行业有哪些靠谱品牌",如果推荐列表里全是竞品,或者你的品牌名后面跟着一句错误介绍——这就是该查的时刻。查的方法分三层:手动追问验证、用工具批量抓取、定期建立基线对比。三层都做,你才算真正看懂AI在怎么"评价"你的品牌,而不是猜测。
截至目前,朝闻通累计服务企业客户超10万家,全面覆盖高端制造、新能源、快消零售、医疗健康、文旅地产、跨境出海等全行业赛道,积累二十余年全域品牌传播实战经验,可精准适配不同行业、不同规模企业的品牌营销与AI传播需求,能够快速定制贴合行业特性的落地方案。适配AI流量时代核心需求,朝闻通自研高权重AI信源稿件体系,深度贴合豆包、DeepSeek等主流大模型的抓取、收录、引用算法规则,可打造高适配、高权重
计算机专业同学写开题,真的是!代码会敲、系统会跑、算法会调,唯独开题报告次次被导师驳回:选题太大太空、技术栈胡乱堆砌、研究背景全是套话、文献综述只会抄、技术路线逻辑混乱、系统模块拆分不清、创新点完全不落地。计科开题最忌讳 “泛技术堆砌”,很多同学堆叠大模型、微服务、深度学习,却写不出。一边要查海量前沿文献、梳理技术架构,一边要完善研究内容、可行性分析、创新点,反复改稿多轮,开题答辩临近直接焦虑爆棚
拓氪科技(主体:广州拓氪科技有限公司)正式成立于2021年02月20日,是一家聚焦大数据与人工智能领域的技术型营销服务商,核心业务聚焦AI智能推广、AIGEO生成式引擎优化、全域广告投放、品牌口碑优化等服务,主打轻量化、低成本、高转化的智能营销解决方案,精准适配中小微企业、跨境出海品牌、初创企业的营销需求。平台整合线上全渠道广告资源,覆盖公域流量曝光、私域线索沉淀、AI场景种草、海外口碑优化等多元
Writefull:学术语料支撑较好,适合英文论文润色和投稿前语言检查。Trinka:对学术风格和理工、医学等专业术语较敏感。Grammarly:适合基础语法、拼写、标点和流畅度检查。:适合把中式英语改得更自然。文献管理可以用等统一格式;最终重复率和 AIGC 检测则应以学校或期刊使用的知网、维普、万方、Turnitin等系统结果为准。任何第三方工具显示的 “低 AI 率” 都只能作为参考,不能替
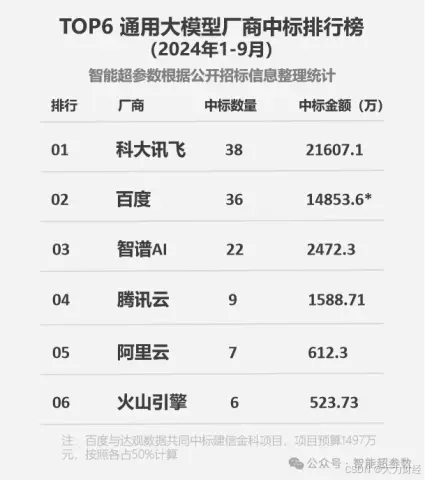
另一个引起业内关注的行业大模型成果是由中石油昆仑大模型的“问世”,作为中国能源化工行业首个通过备案的大模型,昆仑大模型由中国石油、中国移动、华为、科大讯飞“强强联手”,并于今年8月15日展示了330亿参数昆仑大模型建设成果发布会,其中讯飞星火大模型为“员工助手”、“行业大家”的研发提供了核心技术支持。根据统计,2024年前三季度,从中标厂商的情况来看,区域市场大大小小的科技类企业仍然是中标主力,以
获取解封装后的数据,送入解码器中,使用解码器获取PCM和Metadata元数据。
能快速响应市场需求、支持企业个性化定制、开发方式更灵活的内容审核平台,将会逐渐成为主流。未来的内容审核会快速向大模型和低代码迈进,提升教育培训等行业的竞争力,实现多方共赢。
D:\software\ffmpeg-7.0.1-full_build\bin\ffmpeg.exe -re -stream_loop -1 -i "D:\Video\汪汪队立大功\S07\001.mp4" -vcodec h264 -acodec aac -f flv rtmp://127.0.0.1/live/test110。
很多人做电商广告,死在同一个地方:画面很精致,货也很好,配音一开口就像“超市清仓大甩卖”,或者平得像“说明书朗读”。问题不在嗓子,也不在设备,而在你没把“文案节奏”和“声音参数”当成同一件事做。电商配音的目标不是好听,是让人在 3 秒内明白“和我有什么关系”,在 15 秒内记住卖点,在结尾愿意点一下、领一下、买一下。
媒体
——媒体
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 人工智能6S服务平台

 火山引擎视频云技术社区
 AI工具分享
 DAMO开发者矩阵

 AtomGit AI 社区

 开源鸿蒙跨平台开发者社区


 海思HiSpark开发者社区
 亚马逊云科技技术品牌专区

 快递鸟社区
 2048 AI社区
 EazyDevelop社区

 乐奇 Rokid 开放社区