- @2604_96270735


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
阶段关键组件作用意图理解把自然语言转为结构化任务技能匹配找到最优技能组合和模型兼容性检查确保 LoRA、Checkpoint、Sampler 兼容工作流编译生成可执行 DAG执行与监控执行并实时感知输出变化经验积累记录成功率,自动优化后续推荐。

在资源紧张的生产环境中,运行着大量微服务却只有有限的服务器资源,这是许多团队面临的现实困境。Java 微服务动辄占用几个 G 的内存,即使业务空闲时也丝毫不减,服务器资源被白白浪费。传统的解决方案往往围绕“优化 Java 启动速度”展开——CDS、Lazy Init、TieredStopAtLevel=1……这些手段确实有效,但治标不治本。服务空闲时,为什么还要让它占着资源?,实现微服务的按需启动
本文对 HashiCorp Vault 项目进行了深度分析,从核心架构、内部机制到常见业务安全痛点的覆盖度评估,全面解析 Vault 如何解决 RESTful API 权限控制、统一 Token 颁发与自动刷新、数据库密码管理以及第三方密钥保存等四大安全难题。文章还探讨了 Vault 在机密泄露控制、密钥隔离、加密即服务、短期证书等方面的独特价值,并提供了典型使用场景与采用建议,帮助读者判断 Va
是一个由 Andrey Mikhaylov 开发的独立研究项目,其核心成就是让(一个 260 亿参数的 Mixture-of-Experts 大语言模型)在仅有 8 GB 内存的 Apple Silicon MacBook 上运行,峰值内存占用仅约 2 GB,并在 M2 MacBook Air 上实现 5.1–6.3 tok/s 的解码速度。该项目完全使用编写,没有依赖 MLX 或 llama.c
它最核心的想法其实很简单:把 LLM 的上下文窗口当成 L1 Cache,把持久化知识当成磁盘,中间用 Oxigraph 图数据库和 JSON‑LD 语义总线串联起来。这样做的好处是 多轮对话几乎不丢上下文,还巨省 Token,因为你不是把整段历史砸进 Prompt,而是给了 LLM 一把能随时打开任意一扇门的万能钥匙。如果你对 Agent 的记忆管理、技能安全或者 Rust 系统编程感兴趣,可以
Gliding Horse 通过 RelevanceTracker 双维度评分、L1 淘汰策略增强、ContextWindowManager 感知压缩和后台话题连贯性分析,构建了一套完整的上下文相关性感知与智能压缩系统。该系统解决了多轮对话中 Agent 面临的话题漂移和信息过载两大核心痛点,实现了 LLM 注意力窗口的精细化管理,使 Token 利用率提升 20-40%,话题切换响应从被动淘汰升
能力之前之后文件感知Agent 主动轮询,有盲区notify 事件驱动,毫秒级被动感知状态管理Agent 自己记“读过什么”L2 图数据库托管,read_fresh/read_stale 精确追踪文件读取每次全量读盘LRU 缓存 + 差分模式,Token 节省 60%+写入安全靠 Prompt 约束ToolGuard 硬阻断过期写入依赖感知Agent 手动分析ImportScanner 自动更新依
L2 作战地图是 Gliding Horse 多 Agent 协作的基石。只解决“看得见”还不够,必须解决“只看该看的”。通过多维索引、上下文过滤和投影引擎深度集成,Gliding Horse 的每个 Agent 终于拥有了一个干净、专注的工作空间,这或许就是 AI 协作从“草台班子”走向“专业团队”的关键一步。
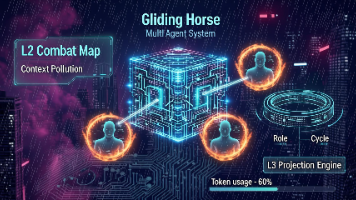
传统 Agent 怎么处理多轮对话?把每轮的完整回复全塞进上下文。聊 50 轮,上下文就塞满 50 轮完整回复——Token 爆炸,LLM 还容易迷失重点。我的做法:每轮 LLM 回复后,强制它输出一个summary(摘要)。历史上下文只拼接这些摘要,不拼原始内容。历史上下文示例:第1轮摘要: 用户需要分析Q2销售数据,目的是为库存计划提供依据第2轮摘要: 确认数据源为sales_q2.csv,数
触发器:TaskEnd任务结束时(不管是成功还是失败),感知引擎会自动提取经验从任务结果中抽取场景摘要创建Experience对象,成功给 0.9 分,失败给 0.1 分打上标签(experiencetask:任务ID存入 L0 图数据库下次同类任务启动时,TaskStart 触发器会自动检索这些经验,注入给 SA。整个系统形成了一个“经验 → 检索 → 应用 → 再提取经验”的正向循环。"sce