登录社区云,与社区用户共同成长
邀请您加入社区
本文对MiniMax H3音视频生成系统本地Base链路进行15类配置测试,涵盖文本、首尾帧、多模态参考输入等场景,验证110个有效样本。基于四张H20-3e GPU,分别在SGLang与vLLM-Omni运行时下完成实验,修复音频上下文缺失及错误传递问题,确保输出完整性与一致性。测试限于768p本地生成,不包含完整系统中的上下文处理与2K重生成模块,结果为工程验收数据,不可直接用于无干扰性能对比
本文详细对比了n8n和Coze两款自动化工具,n8n适合技术开发者处理复杂逻辑和系统集成,开源免费但技术门槛较高;Coze面向业务人员,无代码可视化但扩展性有限。企业可根据用户群体、流程复杂度、部署需求等选择合适工具,也可混合使用形成自动化闭环。建议从小流程实践,逐步扩展复杂逻辑。
梳理8月22日对AI研发人员高价值产业动态;覆盖Anthropic挖角前谷歌TPU负责人布局自研芯片、SGLang Weight Cache Daemon亚秒级引擎重启、大模型任务作弊审计报告、Anthropic AI原生SDLC实战手册、面壁MathForm数学形式化开源项目;每条附带工程视角解读、收益与现实约束;适合大模型推理、Agent安全、AI软件工程、科研研发人员。关键词:SGLang;
2026年奇点智能技术大会新增王书文、李帅、陈秋远、邵鹏韬四位硬核嘉宾,聚焦推理引擎、安全沙箱、AI研发双引擎与具身研究四大方向,推动技术讨论从模型应用深入至系统底层。四类新增嘉宾共同揭示:AI竞争正从“模型想象力”转向“系统执行力”,强调工程化、安全与开源协同。
GLM-5.3-Flash(4×H20)与GLM-5.3(8×H20)部署对比显示,显存容量与拓扑配置直接影响模型支持的上下文长度与并发能力。单机部署Atlas 800 A2(8×昇腾910B3)需关注显存、P2P/NCCL及软件栈适配。关键问题在于:39B激活参数≠仅需39B显存;需结合业务场景(如128K/256K/1M上下文)、并发量、负载类型(Chat/Coding/RAG)和性能指标(T
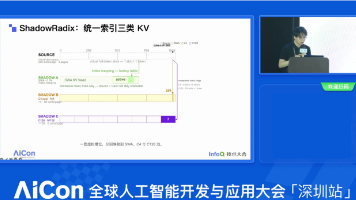
优化项解决的问题效果三种注意力KV管理混乱统一虚拟缓存,物理层独立管理逻辑地址到物理地址映射三套独立映射,支持动态压缩/释放三级缓存(HiCache)百万Token KV存不下前缀复用率超90%状态分离压缩/释放影响其他类型一份逻辑前缀,三套独立物理映射。
本文系统剖析面向智能体推理的 KVCache 技术演进,针对传统机制在长上下文、多轮决策与多智能体协同中的状态膨胀、持久化缺失和缓存孤立三大瓶颈,介绍阿里云 Tair KVCache 团队联合 SGLang 社区推出的 HiCache 分层缓存体系。该方案通过显存-内存-3FS 多级卸载与全局共享,实现缓存命中率提升至80%,TTFT 降低56%,推理 QPS 翻倍,支撑智能体时代的大模型高效推理
home/weights :存放权重文件,容器的home下被绑定。下面脚本中的ip_ad表示ip地址,比如10.101.21.10。进入容器,并切换到home目录下。
Transformers 的 Beam Search 实现集中在的 GenerationMixin 类中,核心方法是。与 vLLM 不同,Transformers 的 Beam Search 是纯张量操作的实现——所有 beam 的扩散、评分、剪枝都通过 PyTorch 张量运算完成,没有面向对象的序列管理,也没有 HTTP 层的编排开销。和 vLLM 老版本的实现一样,支持 early_stop
本文详细介绍了在Ubuntu 22.04上基于Kubernetes部署SGLang的完整方案。首先分析了Kubernetes+SGLang架构的优势,相比传统单机部署具有更好的扩展性、资源利用率和故障恢复能力。接着提供了Ubuntu系统的优化配置步骤,包括Docker和Kubernetes集群的安装部署。最后重点阐述了SGLang模型的两种Kubernetes部署方案:StatefulSet基础部
本文全面解析vLLM、SGLang、TensorRT-LLM等主流大模型推理框架,从核心技术、性能指标到适用场景进行系统对比。帮助开发者根据业务需求、硬件资源选择合适的部署方案,包括企业级高并发、个人开发、边缘计算和国产硬件适配等多种场景,为大模型落地提供实用参考。
MCP(Model Context Protocol)是标准化大模型调用外部工具的协议,包含主机、客户端和服务器三个角色,使用JSON-RPC通信。解决了工具重复开发问题,新工具可为所有大模型所用,被誉为"AI时代的HTTP"。文章详解了MCP实现原理、开发流程、SDK使用及市场资源,同时指出其在多模态支持、鉴权机制和安全防护方面仍需完善。掌握MCP对大模型开发具有重要意义。
文章系统梳理了当前主流的大模型推理部署框架,包括vLLM、SGLang、TensorRT-LLM、Ollama、XInference等,从核心技术、架构设计、性能指标和适用场景等多个维度进行了深入分析。文章详细对比了各框架的优缺点,并提供了基于不同业务需求、硬件资源和未来扩展规划的选型建议,为大模型部署提供了全面的参考依据。
2025年8月,阿里巴巴智能信息事业群率先拉开秋招大幕,启动近千人规模的AI专项招聘计划。此次招聘聚焦三大核心方向:大模型算法优化、多模态技术落地(如电商场景的图文音视频融合交互)、智能体(Agent)商业化应用开发,其中AI相关岗位在秋招总名额中占比超60%,大模型算法工程师、多模态开发等岗位的竞争比仅3:1,远低于传统互联网岗位的10:1。几乎同一时间,云南事业单位首次公开招聘“Agent人工
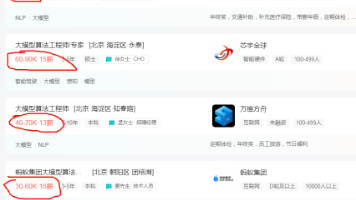
2025年AI大模型领域迎来爆发期,算法工程师月薪7万+,AI科学家月薪11万+,供需严重失衡造就高薪。五大热门岗位包括大模型算法工程师、AI科学家、架构师、多模态工程师和AI芯片设计师,技术红利窗口期正在关闭。文章详细解析各岗位技能要求、涨薪策略及避坑指南,强调现在是入行大模型的黄金时期,错过将错失百万年薪机遇。
本文记录阿里淘天大模型岗面试真题回顾,包含17个核心问题及详细解答,涵盖测试时扩展、Transformer显存消耗、DeepSeek-R1训练阶段、自适应推理、PPO/DPO算法、RAG流程、图RAG算法等关键技术点。内容全面深入,既有理论解析又有实践指导,为准备大模型面试的求职者提供宝贵参考,是通往大厂岗位的必备学习资料。
本文详细分析了大模型领域为程序员带来的转型机遇,指出该岗位需求同比增长317%,平均月薪超3.2万元,2030年全球人才缺口将达500万。文章系统介绍了四大发展方向(数据、平台、应用、部署)及对应技能要求,提供了从基础到实战的学习路径,强调程序员应利用工程化能力降维打击AI应用开发,并通过实际项目驱动学习,抓住大模型时代的高薪机遇。
最近有很多同学咨询想做大模型产品,但一看他们的简历,无论是从专业还是经历上很难有优势!毕竟现在都秋招了,也不是实习打怪的阶段!也很难去卷大模型实习,也没办法通过多段实习撬动校招 offer✅
随着 Llama-3-405B、DeepSeek-V3、Kimi-K2 等千亿级模型密集开源,推理端“高并发、低延迟、低成本”成为新的技术瓶颈。在稀疏化、长序列、结构化生成三大趋势下,它已成为业界少有的“全栈、跨硬件、零门槛”开源基座。请求 → Pre-Schedule(Radix 前缀匹配、内存预算)→ Compute Batch(Prefill/Decode 分离)→ Sample(GPU)→
文章分析中国AI产业在"十五五"时期面临的国际国内双重挑战,提出通过技术、产业、人才和国际四维突围路径,实现从跟跑到领跑的战略跨越。重点阐述算力芯片自主创新、"AI+"场景落地、人才培养体系构建及开放合作生态打造,到2030年中国AI核心产业规模将突破15万亿元,为全球智能革命贡献中国方案。
摘要: 2025年AI技术浪潮席卷职场,传统开发岗位缩减,大模型赛道爆发。企业急需能落地AI应用的工程师,掌握大模型原理、RAG、Agent开发等核心技能。「吴师兄大模型训练营」提供13阶段实战课程,覆盖底层原理、微调、部署及企业级项目,强调就业导向与一对一辅导。课程差异在于全流程实战、技术陪跑及大厂真题对接,适合开发者转型或提升AI能力。附赠全套学习资源,助力快速切入AI黄金赛道。
这并非偶然,而是当下技术从业者面临的共性挑战:随着AI技术的迅猛迭代,企业的核心业务重心正加速向AI应用落地倾斜,这使得市场对技术人才的能力要求发生了明显变化——在原有技术功底的基础上,还得掌握RAG、Agent等AI大模型相关技能。要是还停留在只会做CRUD的阶段,后续的职业道路大概率会越走越窄。
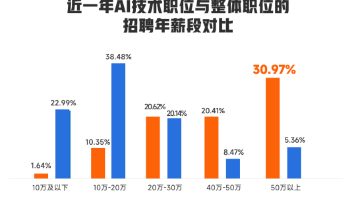
过去一年间,ChatGPT-5的多模态升级、Claude-3的长文本处理能力迭代,不仅重构了AI行业的技术版图,更催生出全新的职业生态。据智联招聘与脉脉联合发布的《2025年AI人才趋势报告》显示,大模型相关岗位的平均薪资较上年涨幅达40%,其中算法工程师年薪中位数突破50万元,数据标注工程师、LLMOps工程师等细分岗位的招聘需求更是同比激增2.3倍。
美团提出的LongCat ZigZag Attention(LoZA)是一种新型稀疏注意力机制,通过在中期训练阶段将全注意力模块替换为稀疏版本,显著降低计算开销。LoZA采用校准和训练两阶段方法,将模型中50%的MLA模块替换为流式稀疏注意力,使升级后的LongCat-Flash-Exp模型能高效处理100万tokens长上下文,在保持性能的同时实现预填充阶段超50%加速和解码阶段30%以上计算开
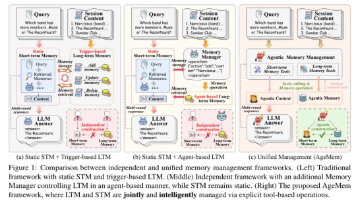
阿里巴巴团队提出AgeMem框架,解决了大型语言模型记忆管理难题。该方法通过强化学习将长期和短期记忆管理统一,让AI自主决定何时存储、更新、删除、检索记忆及如何过滤上下文。采用Step-wise GRPO训练技术,实现奖励回溯机制,使AI能在正确时机做出记忆决策。实验证明,该方法显著提升了任务性能、记忆质量和上下文使用效率。
本文提供AI大模型系统学习路线,分四个阶段:入门阶段掌握Python、数学基础及机器学习;中级阶段深入学习算法并实践项目;进阶阶段学习自然语言处理、计算机视觉等;高级阶段探索深度强化学习和生成模型。文章还包含学习资源与实战案例,帮助学习者从零基础成长为能解决实际项目需求的AI大模型开发者。
2026届校招市场AI人才需求呈现三大特征:需求稳增、结构优化、薪酬分化。高科技企业成为AI人才需求主力军,超60%企业已将AI人才纳入核心招聘目标。技术研发类岗位需求旺盛,大模型算法工程师月薪中位数达24760元。企业招聘更看重数学与算法基础、实际项目经验,名校学历重要性下降。具备扎实算法基础和项目经验的AI应届生将成为市场最大赢家。
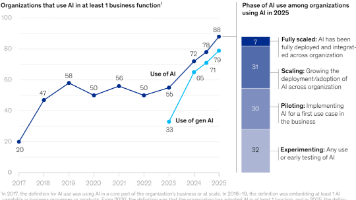
麦肯锡报告显示,88%企业已使用AI,但仅6%真正获得显著价值。成功企业六大关键:追求增长与创新、重新设计工作流程、高层领导推动、多领域应用AI、投入充足资源(20%以上数字预算)、系统化管理。AI已从"可选项"变为"必选项",但战略思维比技术本身更重要,成功关键在于如何重塑业务而非简单应用技术。
sglang
——sglang
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 AMD开发者中国社区

 天工造物局

 DAMO开发者矩阵
 人工智能6S服务平台

 DeepSeek技术社区



 码道开发者社区

 亚马逊云科技技术品牌专区