- @u013970991


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本文深入解析大模型推理中的核心优化技术——KV Cache,从实际应用场景出发,揭示其在减少重复计算、降低延迟与成本方面的关键作用。文章系统阐述了KV Cache的生成机制、显存占用瓶颈,并提出分层存储、硬件加速压缩(KV Shrink)、缓存融合(KV Fuse)与级联推理(KV Cascade)等创新方案,结合Intel至强平台软硬件协同能力,实现“以存代算”的高效优化,为AI应用高并发、长上
AI Infra已成为大模型时代的核心竞争壁垒,超越传统运维,贯穿训练、推理全生命周期。它通过优化通信、调度、数据管线与显存管理,实现算力高效利用,支撑千亿级模型稳定训练与低成本高并发推理。前沿方向如RL Infra、异构推理、超节点架构持续演进,推动算法落地商业化。其高复杂度、高风险、高价值特性,使岗位薪资远超普通开发,成为AI产业不可或缺的硬核工程底座。
本文深入剖析AI Agent开发中Harness与Runtime概念混淆的根源,基于硬件工程与编程底层语义,厘清二者本质:Harness是策略约束层,负责定义智能体“想什么、能做什么”;Runtime是执行底座层,保障“在哪跑、怎么稳运行”。结合OpenClaw、QwenPaw等项目实践,提出“三问判别法”,提供可落地的分层标准,助力开发者精准划分代码边界,规避架构陷阱,实现Agent系统的可控、
请见附件!!! 以下链接是我以前写的一个简单例子,也能给大家提供帮助。http://flychao88.iteye.com/blog/1990520 另外同时也推荐给大家看看Apache chain责任链工具,这个非常好用,效率也较高。基于Spring_Batch的大数据量并行处
本文系统阐述了AI与微服务架构融合下可观测性技术的演进与实践。传统微服务观测基于Metrics、Trace、Log三大支柱构建,字节跳动通过自研CloudWeGo技术栈实现高性能埋点采集。AI技术的引入形成了应用层(智能体)、服务层(中间件)和基础设施层(GPU集群)的三维观测挑战,需新增模型监控、智能体行为追踪等能力。全栈可观测体系需融合传统观测手段与AI专用监控工具,实现从底层算力到上层应用的

回顾整个落地过程,DeepSeek Harness原生观测能力的定位,是服务于单机、单会话的实时人工调试,只能解决基础的单次任务校验问题,完全无法支撑企业级规模化集群部署的运维需求。在多机器、多任务、长时间运行的场景下,原生数据零散、无法汇聚、无统计、无告警、难回溯的短板,会直接导致项目稳定性、成本、性能完全失控。腾讯云Agent可观测DSH插件的核心价值,就是补齐了这套体系的最后一块短板。通过无
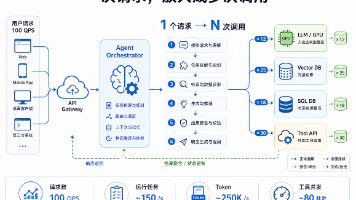
对比传统Web服务,AI Agent的高并发治理有着本质区别,固定接口逻辑、均衡资源消耗、可控下游链路这些Web服务的适配逻辑,在Agent场景完全不适用。Agent流量具备极强的放大性、任务异构的随机性、多步调用的不确定性,这也是Agent高并发难治理的根本原因。单纯的机器扩容、QPS限流,只能解决表层流量问题,根本无法解决深层的资源挤占、故障扩散、流量雪崩问题。一套成熟可落地的Agent高并发
Cloudflare官方对Code Mode的定义精准概括了其核心精髓,不再将每一个操作定义为独立工具,而是让模型基于类型化SDK自主编写业务代码,在安全沙箱中完成代码执行,用精简的代码逻辑替代海量的工具描述,代码本身就是最轻量化、最灵活的任务执行计划。拆解成开发者易懂的通俗逻辑,Code Mode的核心变革可以归纳为三点,彻底重构了大模型与外部系统的交互范式。第一,信息输入范式革新,从“全量灌输
Cloudflare官方对Code Mode的定义精准概括了其核心精髓,不再将每一个操作定义为独立工具,而是让模型基于类型化SDK自主编写业务代码,在安全沙箱中完成代码执行,用精简的代码逻辑替代海量的工具描述,代码本身就是最轻量化、最灵活的任务执行计划。拆解成开发者易懂的通俗逻辑,Code Mode的核心变革可以归纳为三点,彻底重构了大模型与外部系统的交互范式。第一,信息输入范式革新,从“全量灌输
摘要: 大模型推理优化的核心并非单纯压榨GPU算力,而是通过高效管理KV Cache(键值缓存)减少数据搬运与计算冗余。随着上下文窗口扩大至百万级token,KV Cache的调度效率成为性能瓶颈。解码阶段因内存带宽限制(需遍历大量历史K/V向量)而非算力不足,导致GPU利用率低下。量化分析显示,单条128K请求的KV Cache可占用43GB显存,高并发场景下显存压力陡增。 技术革新: 分页注意