登录社区云,与社区用户共同成长
邀请您加入社区
图像在传输、解码过程中容易产生噪声。因此为了有效去除叠加在图像里面的噪声,又尽可能的减少对原始数据的影响,我们引入滤波算法,当然滤波算法有很多中,这里我们首先介绍均值滤波。均值滤波顾名思义就是求均值。他的思路也比较简单,就是求矩阵内的均值,核心难点是求出3x3滑动矩阵。。
<think>我们根据要求生成一个不超过150字的摘要。内容是关于反谐波均值滑动窗口滤波(CHMF)的MATLAB程序,用于抑制胡椒噪声并保持细节。摘要应简洁概括主要特点、功能、结果和适用性。注意字数限制。</think>本例程基于反谐波均值滑动窗口滤波(CHMF)抑制灰度图像中的胡椒噪声。通过正阶幂加权,低灰度脉冲贡献被削弱,正常样本主导输出,从而在去噪的同时保持边缘与细节。程序为单个MATLA
均值滤波中值滤波最大值滤波最小值滤波并给出对比1️⃣ 数据生成构造了一个长度为N = 1000的模拟信号,包含 2 Hz 与 10 Hz 的正弦成分。添加高斯白噪声构成。2️⃣ 滤波器参数设置设置滑动窗口大小,是后续滤波器缓冲区的核心参数。
当第三行数据全部到来时,3x3矩阵会构建如图二所示,1、2、3会按照上一行-当前行-下一行的方式呈现,因为当第三行的第一个数据到来时,第一个数据会直接输出用于矩阵构建,同时也会存入fifo1,由于存进去了一个数,所以fifo1需要同步读出一个数,也就是第2行数据的第一列数据,同时读出的这个数据也需要同时用于构建3x3矩阵和存入fifo0,同理fifo0也需要同步读出一个数据,但是这个数据后续无须再
你可以使用 pandas 的 groupby 函数按照性别分绩,然后使用聚合函数计算男生和女生成绩的均值、最高分和最低分。以下是一个示例:import pandas as pd# 假设有一个名为 "students" 的数据框,其中包含 "name"、"gender" 和 "score" 三列# 按照性别分组grouped = students.groupby("gender")...
1.功能要求:输入图像大小为256256。在clk时钟下进行55均值滤波之后的结果。难点分析,主要是时序分析和边界对齐等问题。2.模块划分:模块一:行数据的统计。图像数据中的行数据流在时钟下输出,每五个像素点计算一个累计和。模块二:列数据的统计。对于模块一的输出数据流,在该模块中通过shift_ram ip核进行输出,输出的是5行数据流。模块三:对于结果进行均值处理。主要实现的功能是累加和除以模板
中国村级行政边界数据,村庄边界、社区边界矢量数据 ,shape文件矢量数据,属性表字段信息:村庄代码、村庄名称、村庄所属省份、市、县、乡镇街道名称等。
该数据集为全国铁路分省矢量数据,属性表涵盖了铁路名称、铁路类型、是否为桥梁以及是否为隧道等信息。其中道路类型中Funicular为缆索铁路、Light_rail为轻轨、Monorail为单轨铁路、Narrow_gauge为窄轨铁路、Rail为城轨、Subway为地铁、Tram为有轨电车。铁路交通是一种以轨道为运输基础的公共交通系统,通过机车牵引列车沿固定轨道运行实现人员或货物的快速运输。铁路不仅是
安徽省 201、北京市 31、福建省 101、甘肃省 76、广东省 152、广西壮族自治区 114、贵州省 110、海南省48、河北省 118、河南省 153、黑龙江省 137、湖北省 196、湖南省 162、吉林省 111、江苏省 238、江西省 150、辽宁省 151、内蒙古自治区 129、宁夏回族自治区 17、青海省 35、山东省 143、山西省 82、陕西省 101、上海市 41、四川省
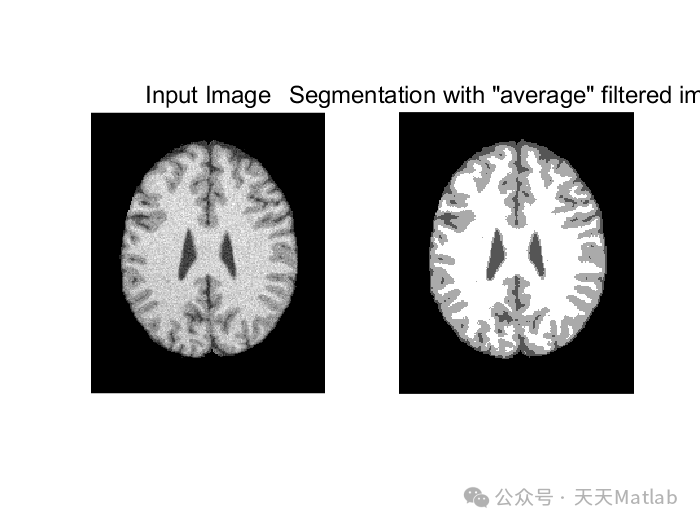
本论文针对磁共振图像(MRI)脑组织分割中存在的噪声干扰、灰度不均匀等问题,提出基于自适应正则化核函数模糊 C 均值聚类(ARKFCM)的分割方法。通过引入自适应正则化核函数对传统模糊 C 均值聚类(FCM)算法进行改进,有效增强算法对图像噪声和灰度不均匀性的鲁棒性,实现对脑组织的精准分割。详细阐述 ARKFCM 算法原理、模型构建及参数优化过程,并利用临床 MRI 数据进行实验。
图像分割就是把图像分成若干个特定的、具有独特性质的区域并提出感兴趣目标的技术和过程。它是由图像处理到图像分析的关键步骤。现有的图像分割方法主要分以下几类:基于阈值的分割方法、基于区域的分割方法、基于边缘的分割方法以及基于特定理论的分割方法等。从数学角度来看,图像分割是将数字图像划分成互不相交的区域的过程。图像分割的过程也是一个标记过程,即把属于同一区域的像素赋予相同的编号。
加权均值(Weighted Mean)是一种统计学中的平均值计算方法,它考虑了每个数据点的权重。在计算加权均值时,每个数值会乘以其相应的权重,这些权重反映了每个数值在总体中的重要性或代表性。
摘要: 磁共振成像(MRI)技术在脑组织疾病诊断中发挥着至关重要的作用,而准确地分割脑组织是后续诊断和治疗的关键步骤。本文提出了一种基于自适应正则化核函数模糊C均值聚类(ARKFCM)算法的脑组织分割方法。该方法利用自适应正则化核函数有效地解决了传统模糊C均值聚类(FCM)算法在处理高维数据和噪声数据时易出现局部最优解以及分割精度不高的问题。通过在核函数中引入自适应正则化项,ARKFCM算法能够更
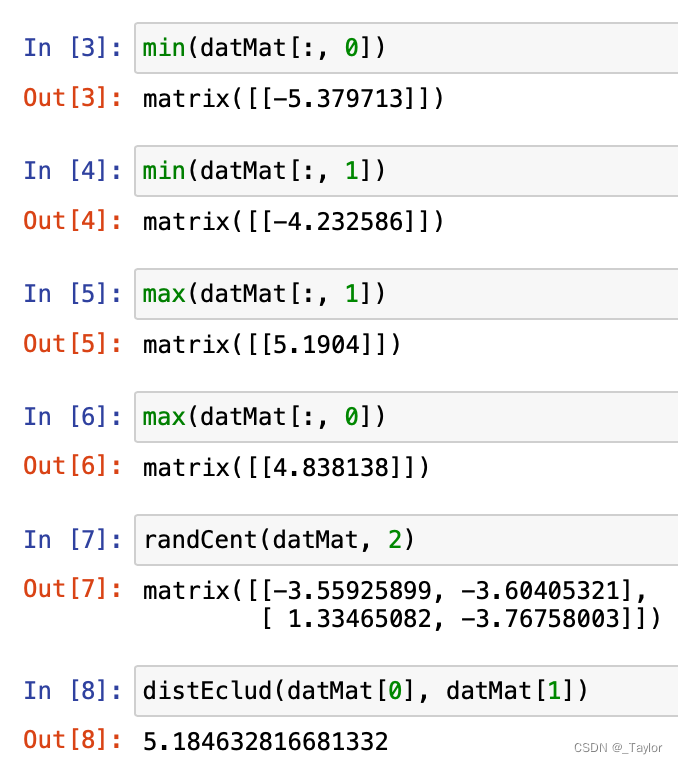
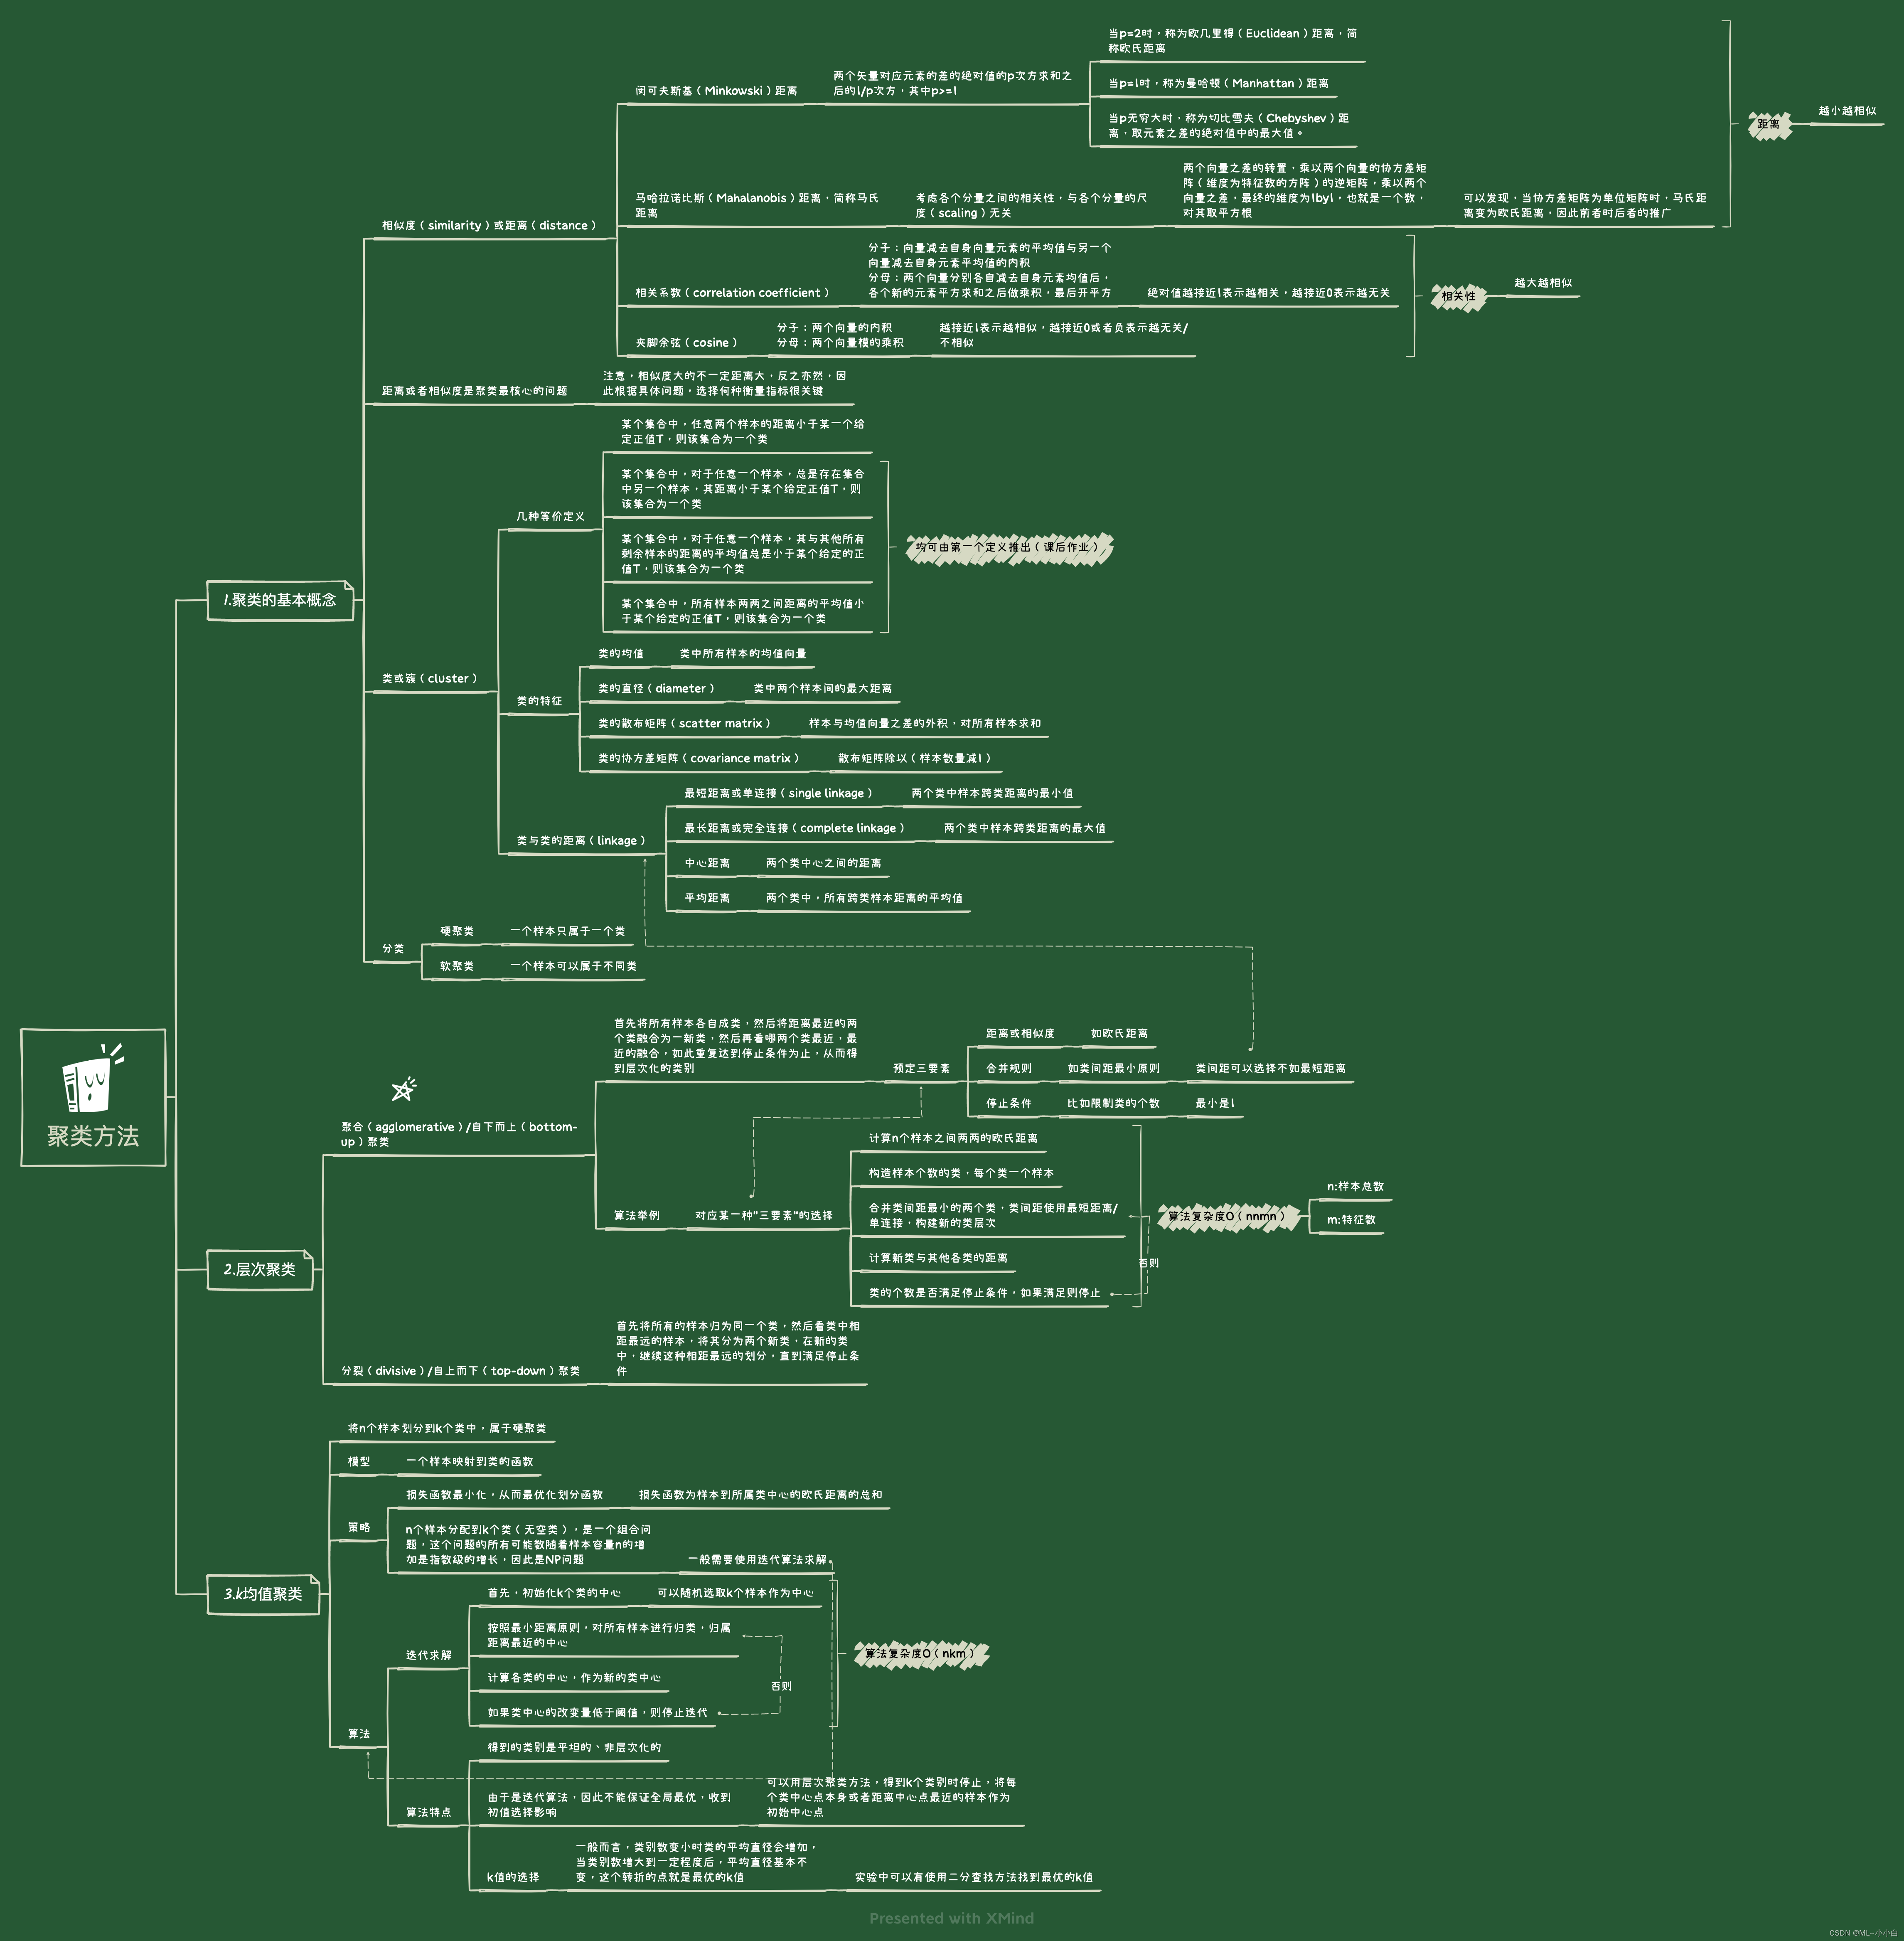
K-均值聚类算法就是一种典型的聚类算法,之所以称之为K-均值是因为它可以发现k个不同的簇,且每个簇的中心采用簇中所含值的均值计算而成。
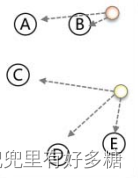
定义:K-均值聚类算法通过迭代的方式,将数据集中的样本分配到K个簇中,每个簇由一个质心(centroid)表示,质心是簇内所有样本的均值。算法的目标是使得每个样本到其所属簇质心的距离平方和最小。步骤:1.初始化:随机选择K个样本作为初始质心。2.分配:计算每个样本到各个质心的距离,将每个样本分配到最近的质心所对应的簇中。3.更新:重新计算每个簇的质心,即计算簇内所有样本的均值作为新的质心。4.迭代
因子分析是主成分分析的扩展和推广,通过对小农户土地流转内卷化影响因素变量的相关系数矩阵内部结构的研究,导出能控制所有影响因素变量的少数几个不可观测的综合变量A,B,C,通过这少数几个综合变量去描述的多个农户土地流转内卷化影响因素变量之间的相关关系。通过因子分析法分析研究,从小农户土地流转“内卷化”的影响因素群中提取共性因子(这里的共性因子指的是不同影响因素之间内在的隐藏因子),把影响因素之间的错综
经过本章的学习,加深了对k-均值的了解,一个典型的聚类算法,主思想是将样本数据划分为K个簇,使得每个样本点都属于离其最近的簇中心,也就是质点,K-均值算法的优点包括简单、易于实现和计算效率高。然而,该算法的结果受到初始簇中心的选择和数据分布的影响,可能会陷入局部最优解。因此,在使用K-均值算法时,通常需要进行多次运行并选择最优的结果。
聚类,就是将样本划分为由类似的对象组成的多个类的过程。聚类后,我们可以更加准确的在每个类中单独使用统计模型进行估计、分析或预测;也可以探究不同类之间的相关性和主要差异。聚类和分类的区别:分类是已知类别的,聚类未知。
思维导图:14.1试写出分裂聚类算法,自上而下地对数据进行聚类,并给出其算法复杂度。i. 计算n个样本两两之间的距离,并将所有样本看作一个类,将样本间最大距离作为类直径;ii. 对于类直径最大的类,将其中相距最远,也就是距离为类直径的两个样本分成两个新类,该类其他样本就近(相对于那两个选中的样本)归于两个类之一;iii. 如果类别个数达到停止条件(预设的分类书)则停止,否则回到ii.步骤。模型复杂
给出下列一组数据:23,29,20,32,23,21,33,25均值(mean) =(23+29+20+32+23+21+33+25)/ 8 = 25.75中位数(median) = 排序后中间的数字 = (23 + 25)/ 2 = 24众数(mode) = 出现频率最多的数字 = 23给出下列一组数据:65,81,73,85,94,79,67,83,82极差(range) = 最大值 - 最小
假设总体数量为(m+n),其包含两个亚组(,),第一组的平均值和标准差分别为和,第二组的平均值和标准差分别为和,则总体的平均值和标准差是多少呢?先给答案:,平均值推导过程:标准差推导过程:...
mAP是目标检测中最常用的评估指标,综合反映模型在不同召回率下的平均精度表现。其核心是计算每个类别的平均精度(AP),然后对所有类别的AP取平均。
1. 非局部均值滤波非局部均值滤波(Non-Local Means,NL-Means)是一种非线性的图像去噪算法。它基于图像中的像素具有相似结构这一假设,利用图像的全局信息来对图像进行去噪。1.1 全局算法 VS 局部算法非局部均值滤波在计算每个像素点的估计值时,会考虑图像中所有与该像素点具有相似邻域结构的像素点。因此,非局部均值滤波是一种全局算法。那么相对于全局算法的局部算法是什么呢?局部算法.
输入第一行是一个整数n,表示有n个整数。第2~n+1行每行包含1个整数。每个整数的绝对值均不超过10000。输出一行,先输出和,再输出平均值(保留到小数点后5位),两个数间用单个空格分隔。读入n(1≤n≤10000)个整数,求它们的和与均值。
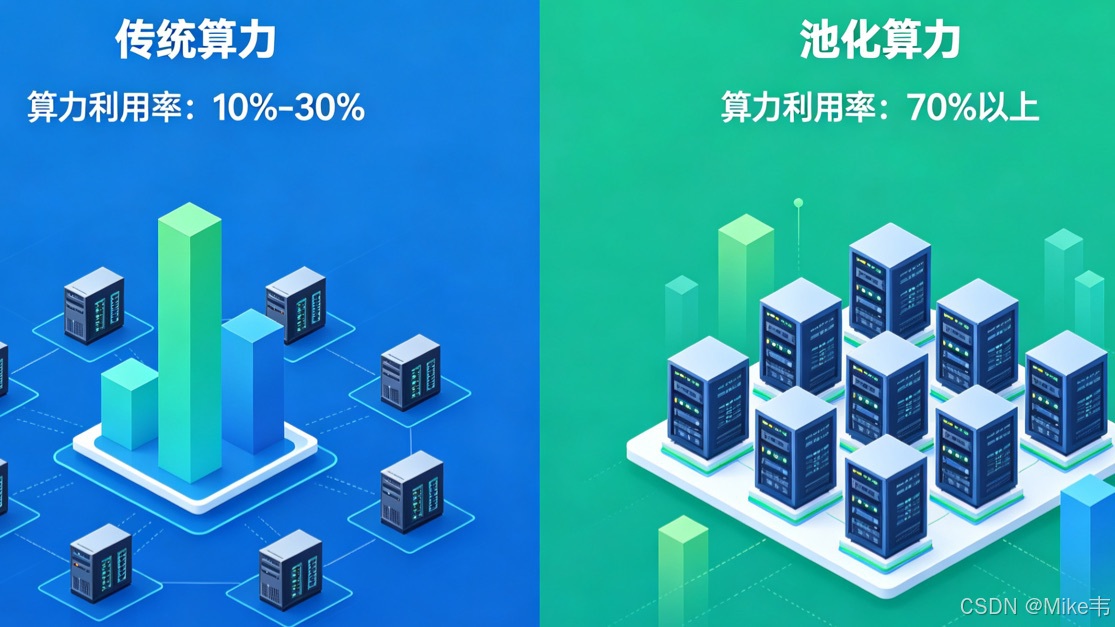
当前,算力现货市场已形成规模化布局,第三方平台与算力交易所提供公开竞价、撮合交易服务,有效打破算力孤岛,让中小企业“用得起、用得到”算力资源,同时提升算力运营商的资源利用率。当算力成为数字时代的核心生产要素,其资产化进程正从基础的资源整合迈向金融化创新,“算力期货/现货”的出现,标志着算力正式从“技术资源”转化为“可交易、可对冲、可增值”的标准化资产,为解决算力供需失衡、价格波动等行业痛点提供了全
用于展示多分类模型预测结果与真实标签的对应关系矩阵,直观反映各类别的预测正确 / 错误情况。
1. 机器翻译:NLP技术可以用于将一种语言自动翻译成另一种语言。例如,Google Translate就是一个机器翻译工具,它可以将输入的文本从一种语言翻译成多种其他语言。2. 语音识别:NLP技术可以将人类语言转换成机器可理解的形式。语音识别技术可以将人们说的话转换成文本,并且可以用于语音助手(例如Siri和Alexa)。例如,IBM的Watson系统可以回答用户提出的问题,并提供相关的答案。
一、前言:对于常用的图像分类模型,如 VGG、ResNet 等,这些值通常是根据 ImageNet 数据集统计得出的。ImageNet 数据集包含了大量的自然图像,通过对这些图像进行统计分析,得到了如下均值和标准差:mean=(0.485, 0.456, 0.406), std=(0.229, 0.224, 0.225)。但是对于自己的数据集,想知道其均值和标准差,又该如何计算呢?二、下面使用Py
在本练习中,您将实现K-means算法并将其用于图像压缩。
机器学习算法初识——线性回归算法(Linear regression)
非局部均值滤波
EMPC 显式模型预测控制matlab 代码+文档1.显式MPC控制器纵向控制2.多参数二次规划显式MPC求解3.弹簧系统的隐式和显式MPC控制最近在研究控制领域的一些有趣内容,今天就来和大家分享下显式模型预测控制(EMPC),顺便带上MATLAB代码和相关文档说明,希望能给同样对此感兴趣的小伙伴一些启发。
3在摆杆处于自然下垂状态下,外力拉起摆杆至接近 165°位置,外力撤除同时,启动控制旋转臂使摆杆保持倒立状态时间不少于 5s;期间旋转臂的转动角度不大于 90°。1. 摆杆从处于自然下垂状态(摆角 0°)开始,驱动电机带动旋转臂作往复旋转使摆杆摆动,并尽快使摆角达到或超过-60°~ +60°;1.从摆杆处于自然下垂状态开始,控制旋转臂作往复旋转运动,尽快使摆杆摆起倒立,保持倒立状态时间不少于 10
多变量时间序列预测在许多领域中扮演着至关重要的角色,特别是在金融、能源、交通、气象等行业。时间序列数据具有依赖性和时序性,其中的模式和趋势通常能够通过合适的算法进行学习和预测。然而,在实际应用中,传统的时间序列预测方法,如SEATIMSEA(自回归积分滑动平均)模型和简单的回归分析,难以捕捉复杂的非线性关系以及长时间的依赖关系。因此,近年来深度学习技术特别是基于神经网络的模型在时间序列预测任务中取
看了一篇文章《傻瓜也能懂的卡尔曼滤波器(翻译自外网博客)》,发现评论里很多人说看不懂,决定写一篇真傻瓜也能懂的卡尔曼滤波。文章先从简单的平均值开始,问题从简单到复杂,最后引入卡尔曼滤波。...
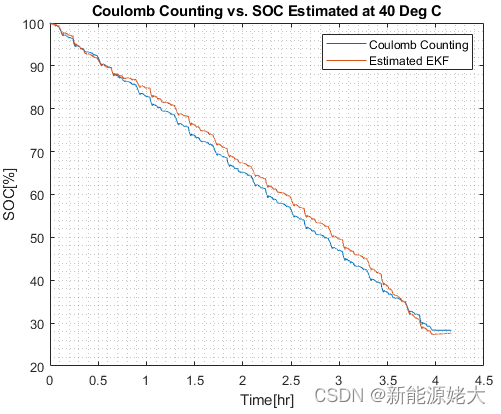
本篇博客介绍了脚本的主函数部分,通过给定实验测量的电池时间、电压、电流和温度数据,通过EKF_SOC_Estimation Function来分析计算电池在使用中的SOC和端电压(Vt),并将Function输出的数据进行分析,绘制出测量端电压与估计端电压的对比图、端电压误差图、真实SOC与EKF估计的SOC对比图、SOC误差图。并计算端电压(Vt)和SOC的均方根误差(RMSE)和最大误差(MA
第一步使用了卡尔曼滤波算法,用电池电压来修正SOC,然后将修正后的SOC作为第二个卡尔曼滤波算法的输入,对安时积分法得到的SOC进行修正,最终得到双卡尔曼滤波算法SOC估计值。第一步使用了卡尔曼滤波算法,用电池电压来修正SOC,然后将修正后的SOC作为第二个卡尔曼滤波算法的输入,对安时积分法得到的SOC进行修正,最终得到双卡尔曼滤波算法SOC估计值。这里的巧妙之处在于把安时积分法本身作为预测模型,
Carsim Simulink联合仿真-基于LQR/模糊PID/滑模控制的横摆稳定性控制系统 综合跟随理想横摆角速度的方法和抑制汽车质心侧偏角的汽车稳定性控制方法,以线性二自由度车辆操纵特性模型为控制目标,基于汽车横摆力矩与车辆状态偏差之间的动力学关系建立了控制系统模型。第二种方案采用模糊PID控制,以理想和实际横摆角速度的差值作为输入,输出附加横摆力矩;下层才用基于规则和基于二次规划的转矩分配方
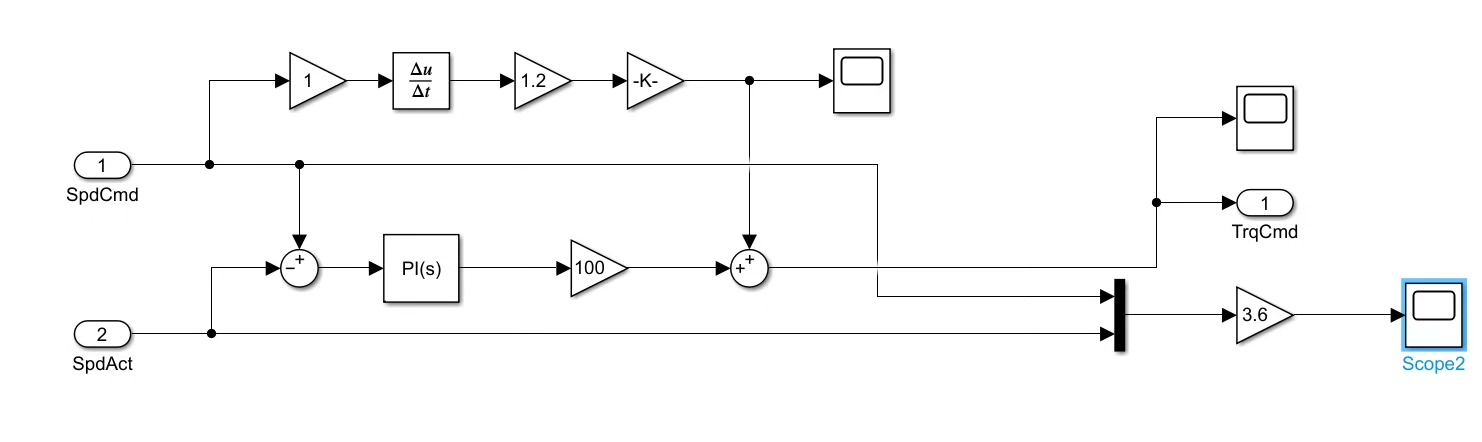
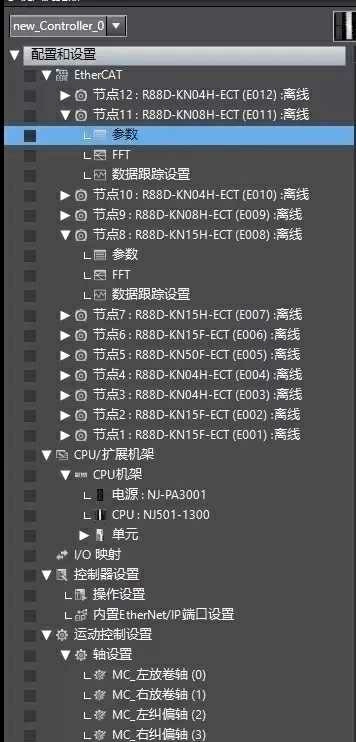
这个项目像一台精密的教学仪器,把EtherCAT总线通讯的抖动处理、多轴同步的时钟对齐、异常状态的平滑切换这些课本上看不懂的概念,统统变成触手可及的实际问题。某次调试中,曾因未启用斜坡发生器导致机械臂抖动,后来在轴控功能块里增加了这个模块,问题迎刃而解。工业现场的多轴运动控制玩起来总有种拆解精密钟表的快感。最近调试欧姆龙NJ系列模切机时,面对12轴EtherCAT伺服联动的庞杂系统,我深刻体会到"
弄石临溪坐,寻花绕寺行。时时闻鸟语,处处是泉声。
总而言之,Java 8的Lambda表达式远非一个语法糖,它是一个强大的思维工具。它促使Java开发者接纳函数式编程的核心思想,如行为参数化、不可变性和声明式编程。这种思维模式的转变,让我们能够编写出更简洁、更灵活、更健壮且更易于并行化的代码。拥抱Lambda,意味着拥抱一种更现代、更高效的编程范式,这无疑彻底改变并重塑了每一位Java程序员的编程思维。
初学小小白,个人笔记使用,仅供参考
最终的决策权应始终保留在人类手中,结合算法的洞察与人类的伦理判断、同理心和对复杂情境的理解,做出更公正、更明智的选择。其次,是算法设计本身的偏见。更危险的是,算法偏见并非静止不变,它可能形成一个自我强化的恶性循环。长此以往,算法可能从历史偏见的“记录者”转变为未来不公的“建筑师”,将偶然的统计相关性固化为看似不可动摇的因果定律,使得纠正偏见变得更加困难。然而,一个日益凸显的严峻现实是:机器学习远非
均值算法
——均值算法
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 乐奇 Rokid 开放社区

 天工造物局


 DAMO开发者矩阵














 码道开发者社区