- @dream_home8407


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
LongVU:面向长视频理解的高效时空压缩框架 LongVU提出了一种创新的三级压缩机制,解决多模态大语言模型处理长视频时的令牌冗余问题。核心方法包括:1)基于DINOv2特征的时间冗余去除,通过帧间相似度分析减少50%冗余帧;2)文本引导的空间压缩,利用跨模态注意力选择关键帧保留高分辨率;3)帧间依赖的空间剪枝,动态分配视觉令牌资源。实验表明,该方法能在8k上下文限制下处理小时级视频,相比均匀采
余弦相似度
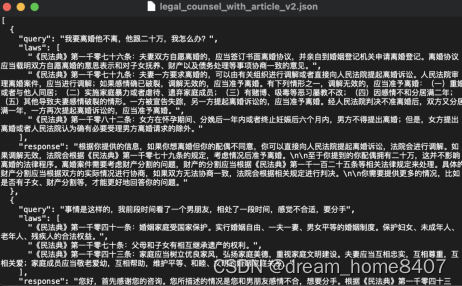
大模型微调思路和数据集构建方式大致是如此,实操中发现项目最难的一点在于怎么构建自己的数据,无监督数据量太大,解析起来很费功夫,有监督的数据怎么完美构建等,因此需要数据梳理之处将数据有效分类很重要,提高模型识别其最核心的结论在于,通过加入检索模块,可以提升问答的可靠性,并且通过引入垂直领域的预巡数据和微调数据,都可以提升其领域性能。但在具体实践中,还需要考虑到领域数据和通用数据的组成情况,以及与下游
本项目提供了一个开箱即用的图像推理服务框架,支持主流目标检测模型(如YOLO系列、MMDetection等),可适配NPU/CUDA/CPU多种硬件环境。核心功能包括:多模型多后端支持、昇腾NPU深度适配(自动选卡、兼容性补丁、性能优化)、高并发批处理设计、生产级健壮性保障。通过统一的REST API提供推理能力,用户只需配置模型文件即可快速部署服务。技术架构基于FastAPI实现,包含模型管理、
本项目提供了一个开箱即用的图像推理服务框架,支持主流目标检测模型(如YOLO系列、MMDetection等),可适配NPU/CUDA/CPU多种硬件环境。核心功能包括:多模型多后端支持、昇腾NPU深度适配(自动选卡、兼容性补丁、性能优化)、高并发批处理设计、生产级健壮性保障。通过统一的REST API提供推理能力,用户只需配置模型文件即可快速部署服务。技术架构基于FastAPI实现,包含模型管理、
yolov8官方链接:本文章是以labelimg标注好的voc数据集为基础,通过转换格式训练模型,

git pull origin <分支名># 拉取远程最新代码并合并。git merge <目标分支># 将目标分支合并到当前分支。git push origin <分支名># 推送到远程分支。git clone <项目URL># 从 GitLab 拉取代码到本地。git add +路径 (可以多个) 添加修改到暂存区。git diff +文件路径查看修改位置。git diff +文件路径查看修改
通过网盘分享的文件:ubuntu_nvidia-container-toolkit_1.18.1_deb_amd64.tar.gz。链接: https://pan.baidu.com/s/10UZmyY55LGn6YD-CCir0Kg 提取码: btxj。链接: https://pan.baidu.com/s/1KaFQP547IJvvMQKOw4Om7g 提取码: qugk。执行 rpm -Uv
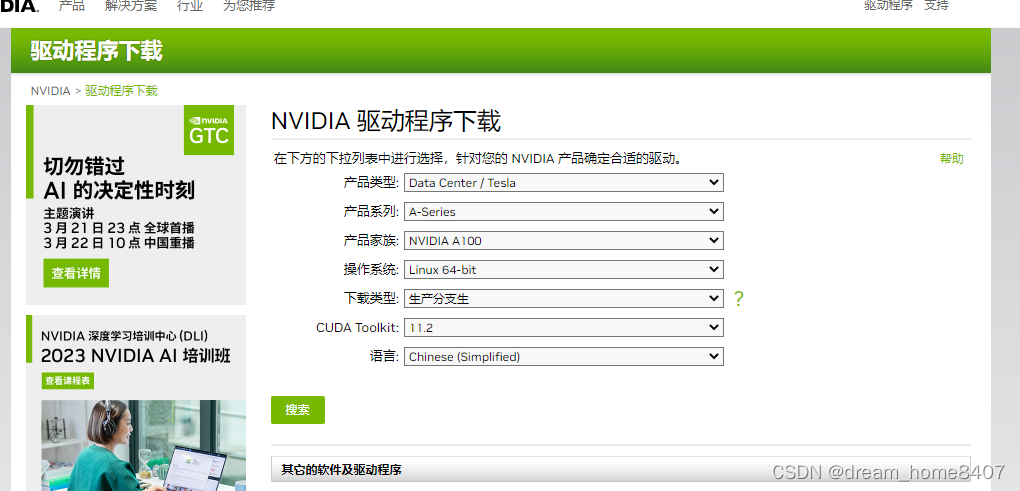
1.确认GPU型号和操作系统版本,本示例中以A100以及操作系统为Centos 7.9进行操作。准备GPU驱动和CUDA 11.2软件包,在nvidia官网进行驱动包和CUDA包下载链接:linux系统均选择 Linux 64-bitCUDA Toolkit选择最新版本如您需要老版本CUDA,请前往老版本CUDA下载本示例中使用CUDA 11.2。
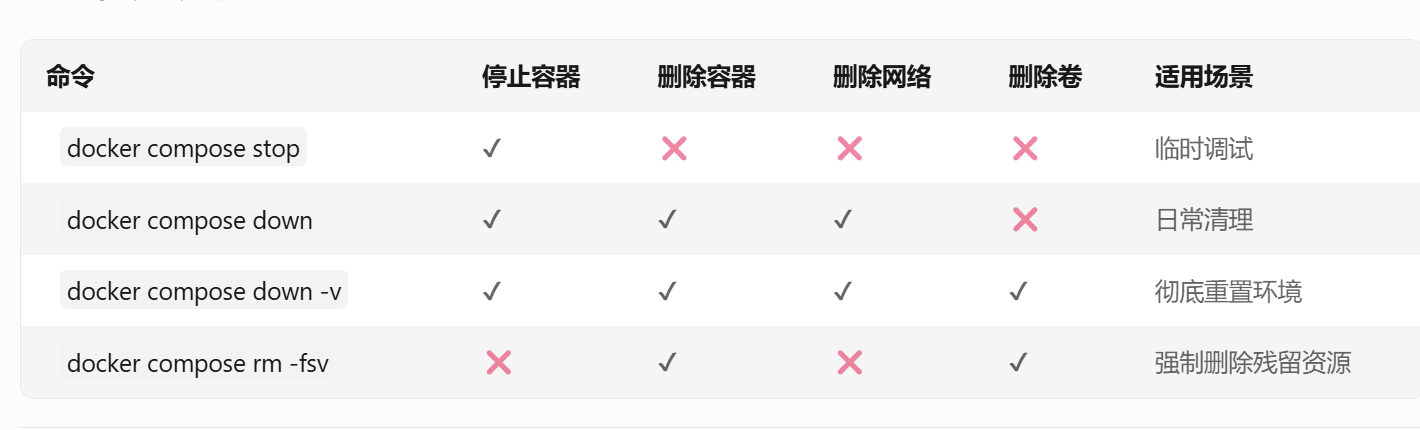
docker compose stop可以快速停止服务,方便后续重新启动,而不必重新构建。而down则适合彻底重置环境。docker exec <容器名> lsof -i :80。docker logs --tail 100 <容器名>docker-compose down会删除容器和网络。docker port <容器名> 80/tcp。docker port <容器ID或名称>-f参数可指定任