


- @LLMUZI123456789


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
生成式方法使用深度学习模型,如Transformer、seq2seq模型(如带有注意力机制的LSTM)等,训练模型预测每个单词作为摘要一部分的概率,从而生成连贯的新颖摘要。文本摘要生成是自然语言处理(NLP)中的一个重要任务,目标是从原始文本中提取关键信息并形成一个简短且保留核心内容的摘要。抽取式方法从原文中直接挑选出重要的句子或片段组合成摘要,通常基于文本的重要性评分,如词频、句子位置、句间关联
from car_tablewhere gender = ‘男性’ or gender = ‘女性’),4)*100||‘%’ raite。where (t.gender= ‘男性’ or t.gender = ‘女性’) and t.brand is not null。=‘非营运’,t1.sal_nums,0)) cycar_nums – 3884。sum(if(t1.nature=‘非营运’,
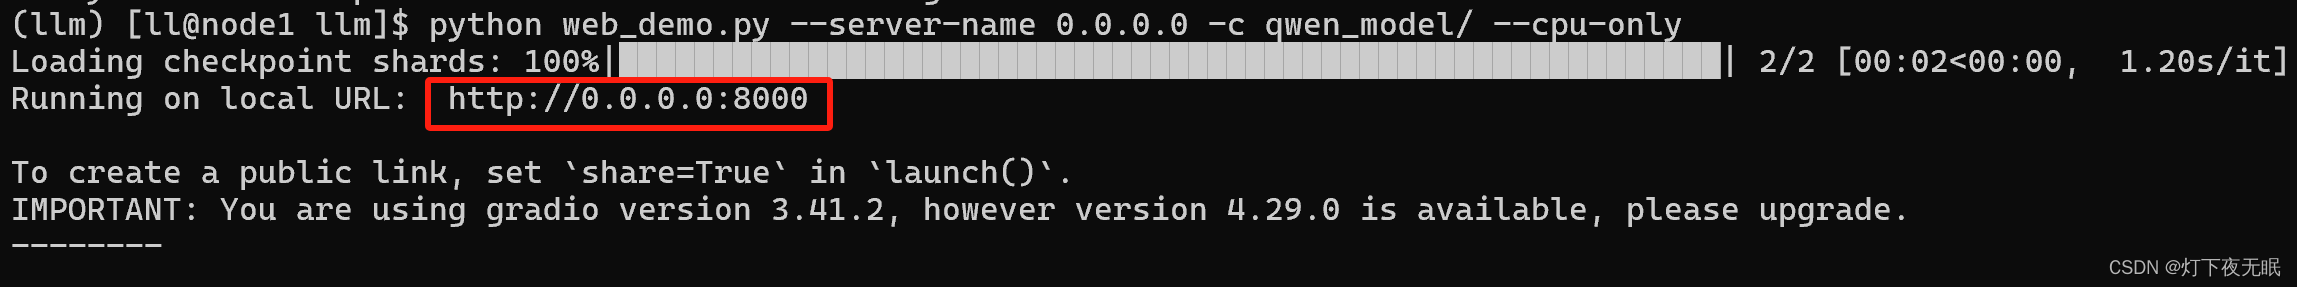
模型微调过程会使用CPU,且占用内存大概22G左右;参照官方文档:https://github.com/QwenLM/Qwen/blob/main/README_CN.md。创建环境,建议单独创建一个新环境,避免与现有环境冲突,创建后要先安装pytorch,再安装项目依赖模块。提前安装好git跟git lfs,否则可能拉取不到模型文件,git lfs主要用于大文件拉取。项目文件以及环境安装好后,继
【代码】spark连接mongodb。
当本地训练的python环境与 Spark 集群其他节点环境不一致时,核心解决方案是:将本地 Python 虚拟环境打包为压缩包,通过 Spark 的–archives参数分发到所有 Executor 节点,强制所有节点使用统一的环境(Python 解释器 + 依赖包)环境打包:将本地虚拟环境(含 Python 解释器、所有依赖包如scikit-learn、pyarrow、自定义类脚本)压缩为归档
将所有节点挂载同一个网络存储,代码中指向挂载点(例如 /mnt/data/train.csv)有一份csv数据在当前节点的本地路径上,本地模式跑可以通过:file://+本地路径正常读取。这是生产环境最标准的方式,将数据上传到HDFS上,让所有节点通过同一地址访问得到该数据;2、无权限上传hdfs时,使用 --files + SparkFiles.get()1、使用HDFS路径,将数据上传到hdf
【代码】Spark Executor 与 Driver 在三种模式下的区别。
3、创建专门的环境变量文件,配置文件。1、创建新用户,授予sudo权限。2、创建文件目录,上传解压文件。5、将文件目录授权给指定用户。6、检查主要组件是否安装完成。
在 PySpark 中,UDF(User-Defined Function,用户自定义函数) 是扩展 Spark 功能的核心工具,用于处理内置函数(如pyspark.sql.functions中的函数)无法覆盖的自定义逻辑(如复杂字符串处理、自定义数值计算、多列联动计算等)。仅当内置函数无法满足需求时才用 UDF。Pandas UDF(Vectorized UDF):基于Apache Arrow批
【代码】spark连接mongodb。