


- @m0_58371965


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
常见的命名规则1.大驼峰命名法,首字母都大写FirstOne2.小驼峰命名法,第一个单词首字母小写,其他跟大驼峰一样firstOne3.蛇形命名法,单词之间用下划线拼接first_one4.减号命名法,单词之间用减号分割first-one这些命名法最大的好处就是可以轻易区分单词跟单词代码规范中的那些潜规则html 代码中的潜规则1.html 是不区分大小写的浏览器解析标签是不区分大小写的。<

Flink sql 是什么sql 的诞生就是为了简化我们对数据开发,可以使用少量的 sql 代码,帮助我完成对数据的查询,分析等功能声明式 & 易于理解对于用户只需要表达我想要什么,具体处理逻辑交给框架,系统处理,用户无需关心,对于一些非专业的开发人员有了解 sql,并且 sql 相对我们学习 java,c 等语言更简单,大数据培训学习成本更低,如果跨团队,或者非大数据开发人员,也可以通过

1. 背景当我们需要从 Hive 或其他异构存储中往 HBase 里导入大批量数据的时候,走 HBase 原生 API 这种方式一定不是最合适的方案,一是数据同步的效率会比较低,大数据培训其次是数据的持续写入会导致集群频繁进行 flush,compaction 等操作,占用较多的系统资源,影响线上服务的正常读写,因此,为了应对海量数据导入的场景,bulkload 应运而生。2. bulkload

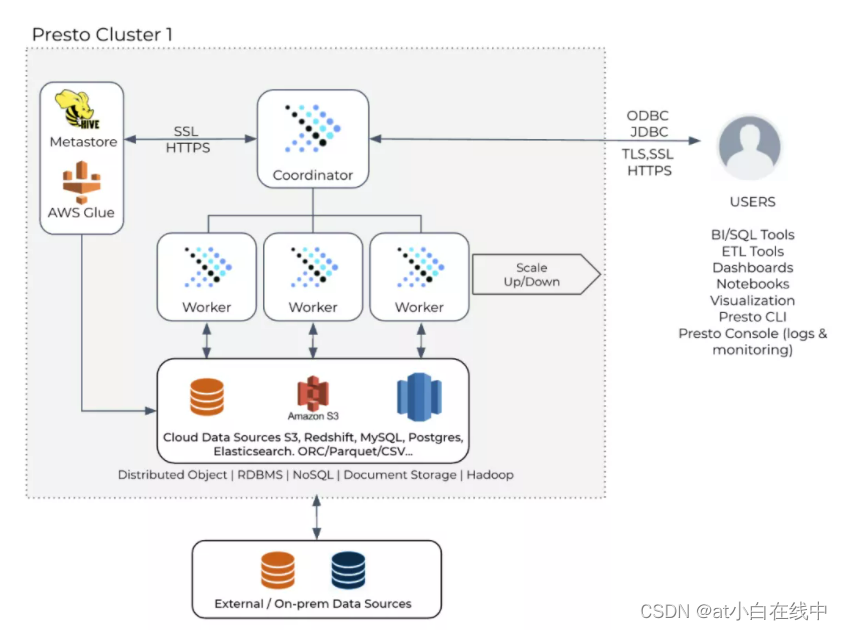
概述Presto 最初设计是对数据仓库中的数据运行交互式查询,但现在它已经发展成为一个位于开放数据湖分析之上的统一 SQL 引擎,用于交互式和批处理工作负载,数据湖上的流行工作负载包括:•报告和仪表盘:这包括为内部和外部开发人员提供自定义报告以获取业务洞察力,以及许多使用 Presto 进行交互式 A/B 测试分析的组织。这个用例的典型特征是要求低延迟。它在非常高的 QPS 下需要数十到数百毫秒,
在大规模数据量的数据分析及建模任务中,往往针对全量数据进行挖掘分析时会十分耗时和占用集群资源,大数据培训因此一般情况下只需要抽取一小部分数据进行分析及建模操作。Hive提供了数据取样(SAMPLING)的功能,能够根据一定的规则进行数据抽样,目前支持数据块抽样,分桶抽样和随机抽样,具体如下所示:1. 数据块抽样(tablesample()函数)1) tablesample(n percent) 根

数据读取是所有数据处理分析的第一步,而Pandas和Spark作为常用的计算框架,都对常用的数据源读取内置了相应接口。总体而言,大数据培训数据读取可分为从文件读取和从数据库读取两大类,其中数据库读取包含了主流的数据库,从文件读取又区分为不同的文件类型。基于此,本文首先分别介绍Pandas和Spark常用的数据读取API,而后进行简要对比分析。01 Pandas常用数据读取方法Pandas内置了丰富

1. 问题现象和原因概述1) 网卡打满导致请求响应缓慢:通过查看问题发生时段集群服务器的网络流量情况,发现大量的RegionServer所在的服务器出现了网卡打满现象。随着大数据业务的快速发展,Hadoop集群所面临的数据读写压力也在不断增长,千兆网卡在应对大批量的数据通信请求时容易被打满,这种大数据培训情况下就会大大影响数据的传输速度,进而产生请求响应缓慢的问题。2) RegionSer
1.NameNode数据目录dfs.name.dir, dfs.namenode.name.dir指定一个本地文件系统路径,决定NN在何处存放fsimage和editlog文件。可以通过逗号分隔指定多个路径. 目前我们的产线环境只配大数据培训置了一个目录,并存放在了做了RAID1或RAID5的磁盘上。2.DataNode数据目录dfs.data.dir, dfs.datanode.data.dir

在Hive中会有很多数据是用Json格式来存储的,如开发人员对APP上的页面进行埋点时,会将多个字段存放在一个json数组中,因此数据平大数据培训台调用数据时,要对埋点数据进行解析。接下来就聊聊Hive中是如何解析json数据的。Hive自带的json解析函数1. get_json_object语法:get_json_object(json_string, '$.key')说明:解析jso

什么是Spark?·大数据的电花火石。·Spark类似于MapReduce的低延迟的交互式计算框架。·Spark是UC Berkeley AMPLab开发的是一种计算框架,分布式资源工作交由集群管理软件(Mesos、YARN)。·Spark是处理海量数据的快速通用引擎大数据培训。Spark发展历程·Hadoop在2003年从Nutch发展到Lucene,在Yahoo成长,进入Apache孵
