登录社区云,与社区用户共同成长
邀请您加入社区
我们改造consumer,当目标服务的调用出现故障,我们希望快速失败,给用户一个友好提示。服务支持的线程和并发数量有限,请求一直处于阻塞状态,会导致服务器上的资源耗尽,其他服务被打死;微服务中服务之间调用关系错综很复杂,可能一个功能需要多个服务里面的功能协调完成,会形成一个复杂的链路;Half Open:半开状态,open状态不是永久的,打开后会进入休眠时间(默认是5S)。此时会释放部分请求通过,
SpringCloud- Hystrix 熔断器
Hystrix熔断器:概念、价值、工作流程、常见配置、使用与监控
Hystrix 为 微服务架构提供了一整套服务隔离、服务熔断和服务降级的解决方案。它是熔断器的一种实现,主要用于解决微服务架构的高可用及服务雪崩等问题服务熔断:Hystrix 熔断器就像家中的安全阀一样,一旦某个服务不可用,熔断器就会直接切断该链路上的请求,避免大量的无效请求影响系统稳定,并且熔断器有自我检测和恢复的功能,在服务状态恢复正常后会自动关闭。
1.背景介绍1. 背景介绍随着微服务架构的普及,分布式系统中的服务之间的调用关系变得越来越复杂。在分布式系统中,服务之间的调用可能会出现故障,这会导致整个系统的性能下降甚至崩溃。为了解决这个问题,我们需要一种机制来保护系统的稳定性。这就是熔断器(Circuit Breaker)的诞生。Hystrix是Netflix开发的一个开源的流量控制和熔断器库,它可以帮助我们在分布式系统中实现熔断...
Hystrix的主要作用是在微服务环境下防止服务雪崩,确保服务弹性及可用性。
sentinel熔断报java.lang.reflect.UndeclaredThrowableException的解决方法
接上文SpringCloud-Feign。
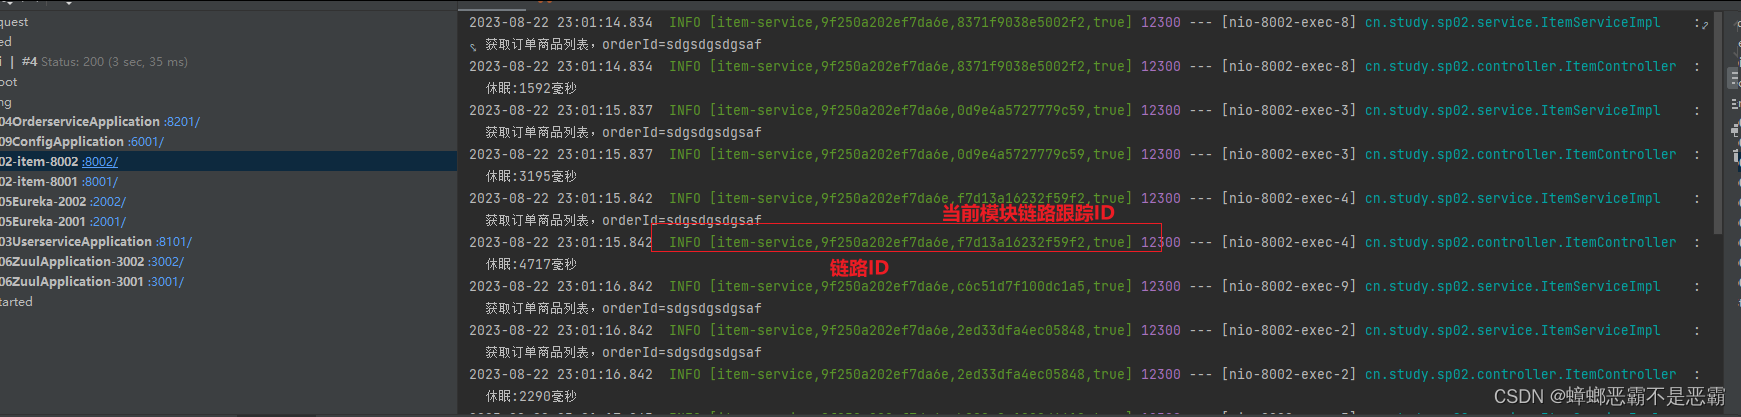
随着系统规模越来越大,微服务之间调用关系变得错综复杂,一条调用链路中可能调用多个微服务,任何一个微服务不可用都可能造整个调用过程失败spring cloud sleuth 可以跟踪调用链路,分析链路中每个节点的执行情况;zipkin 可以收集链路跟踪数据,提供可视化的链路分析;链路数据抽样比例默认为 10% 的链路数据会被发送到 zipkin 服务。
在本文中,我们介绍了如何在Spring Cloud中使用熔断和降级来保护我们的服务免受故障和不可用性的影响。我们首先介绍了Hystrix和Resilience4j这两个流行的熔断器和降级库,然后分别演示了如何在Spring Cloud中使用它们。对于熔断,我们演示了如何使用Hystrix来实现自动熔断和恢复,并通过配置文件自定义阈值和时间窗口。对于降级,我们演示了如何使用Resilience4j来
hystrix.command.[commandkey].execution.isolation.strategy 隔离策略THREAD或SEMAPHORE 默认HystrixCommands使用THREAD方式 HystrixObservableCommands使用SEMAPHOREhystrix.command.[commandkey].execution.timeout.enabled 是否
回顾之前文章:微服务熔断处理之断路器Resilience4j(一)中介绍了 Resilience4j 的一些基本功能,这些基本功能涵盖了请求熔断、限流、以及重试等功能,以及Resilience4j 的一些基本用法。本文将详解Resilience4j-circuitbreaker组件;1、CiruitBreaker(熔断器)模块概述Resilience4j的CircuitBreaker主要由6个部分
java.util.concurrent.RejectedExecutionException: Taskjava.util.concurrent.FutureTask@3f54147b rejected fromjava.util.concurrent.ThreadPoolExecutor@55407c43[Running, pool size = 10, active thre...
Feign在RestTemplate的基础上对其封装,由它来帮助我们定义和实现依赖服务接口的定义。Spring Cloud Feign 基于Netflix Feign 实现的,整合了Spring Cloud Ribbon 与 Spring Cloud Hystrix,并且实现了声明式的Web服务客户端定义方式。我的理解是Feign是一个接口,是发起rest请求的工具,它集成了ribbon负载均..
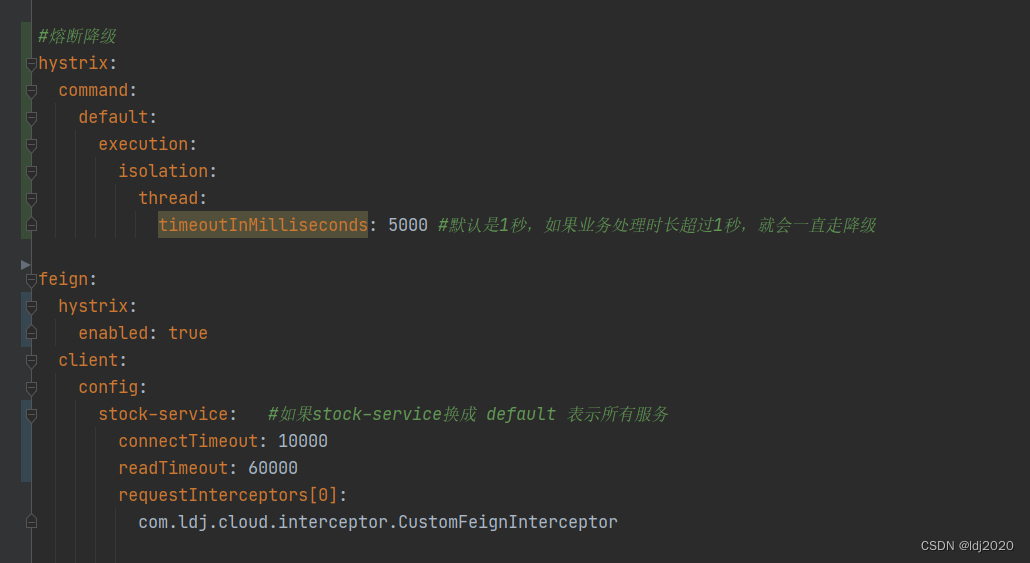
timeoutInMilliseconds: 5000 #默认是1秒,如果业务处理时长超过1秒,就会一直走降级。stock-service:#如果stock-service换成 default 表示所有服务。requestInterceptors[0]:# 可以忽略。enabled: true#开启使用hystrix。原因:默认是1秒,如果业务处理时长超过1秒,就会一直走降级。
背景是这样,小年的项目在跑定时任务时,发现抛出大量的异常:从异常信息来看,应该像是 Hystrix 开启了断路器,触发了熔断限流。查阅了一下相关资料,又翻阅了源码,得出的结论与小年开始的猜测是基本一致。而代码中没有 Fallback 处理的方法,所以程序就直接把异常抛出来。Hystrix 有一个断路器的概念,当断路器开启时,也就是触发熔断机制阻断请求。
Spring Cloud Hystrix:服务容错与熔断
hystrix停止更新,理念优秀。分布式系统面临的问题:对于复杂的分布式体系,有数十个依赖,依赖不可避免的错误。服务会出现雪崩,。Hystrix就是用于解决分布式系统延迟和容错的开源库。保证在一个依赖出现问题,不会导致整体的服务失败,避免级联故障,以提高分布式系统的弹性如果出现错误,向调用方抛出备选FallBack。
Hystrix是一个限流、降级容错框架,它能很好的保护我们的接口、应用。这很大程度上得益于它提供了fallback机制:回退(也叫降级)。本文主要讲述了Hystrix的fallback的主要特性和核心点:Hystrix的fallback回退/降级逻辑Hystrix触发fallback降级逻辑的5种情况Hystrix抛出HystrixBadRequestException异常不熔断1、Hystrix
上一篇中。将userService提供服务的返回时间延迟4000ms。导致feign在调用时候出发熔断。直接返回fallback回调。这一篇中加入zuul实现动态路由功能。并加入ZuulFilter的前置过滤功能。zuul集成hystrix默认在早期版本是打开的。但在后期版本就关闭了自动打开功能,需要手动配置打开。这一点需要注意测试代码如下:1:引入相关的依赖:<dep...
1、Hystrix 熔断机制所谓的熔断机制和日常生活中见到电路保险丝是非常相似的,当出现了问题之后,保险丝会自动烧断,以保护我们的电器。 在程序中,为了保证其高可用,单个服务通常会集群部署。由于网络或者自身的原因,服务并不能保证100%可用,如果单个服务出现问题,调用这个服务就会出现线程阻塞,此时若有大量的请求涌入,Servlet容器的线程资源会被消耗完毕,导致服务瘫痪。服务与服务之间的依赖性..
从Hystrix到Sentinel的演进,本质上是分布式服务容错从"基础熔断"到"全链路流量治理"的升级。Hystrix解决了早期微服务熔断的问题,但由于线程池隔离的局限性和维护停滞,逐渐被Sentinel取代。Sentinel凭借轻量级的隔离、动态的规则配置、丰富的流量控制策略,成为当前分布式系统容错的首选方案。对于还在使用Hystrix的系统,建议逐步迁移到Sentinel:可以先在新业务中使
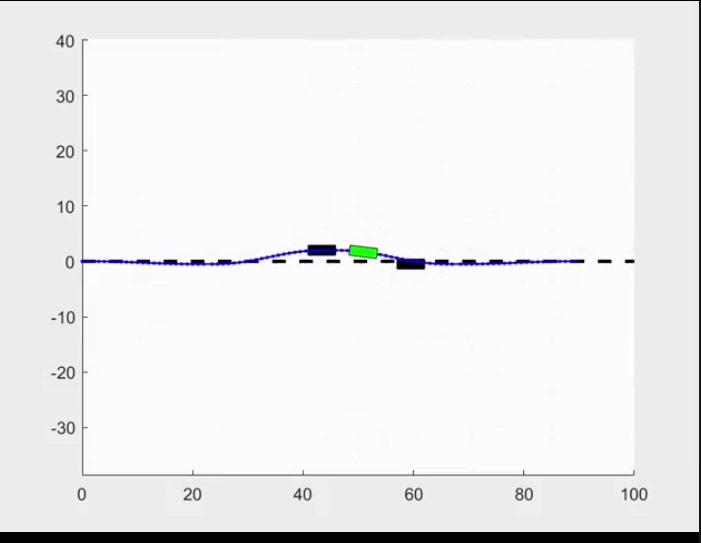
不过要注意动态规划的特性——任何代价项的调整都可能影响整条轨迹的走向,有时候会出现"牵一发而动全身"的蝴蝶效应。对比Apollo的EM Planner,这个Matlab版本少了QP优化层,轨迹平滑完全依赖DP的节点采样密度。咱们先看它的核心——动态规划的实现,代码里那个dp。该算法使用dp动态规划进行了轨迹规划,过程中未向apollo的EM规划器一样还使用了QP进行了轨迹规划,整个大包。该算法使用
Sentinel作为SpringCloudAlibaba的核心组件,为微服务架构提供流量控制、熔断降级等关键防护能力。文章对比了Sentinel与Hystrix的技术差异,详细解析了令牌桶、漏桶等核心限流算法原理,以及熔断器的三种状态转换机制。通过实战代码演示了QPS限流配置,展示了Sentinel责任链模式的设计优势。作为Hystrix的替代方案,Sentinel在性能、功能丰富度和社区活跃度方
舱壁模式:通过资源隔离(如线程池)将不同依赖服务的调用隔离开,避免单一故障引发全局雪崩;熔断状态机:通过“闭合→打开→半开”的状态切换,动态管控对依赖服务的调用,实现快速失败与自动恢复。两者共同构成了分布式系统容错的核心手段,确保在依赖服务故障时,系统仍能保持核心功能可用。
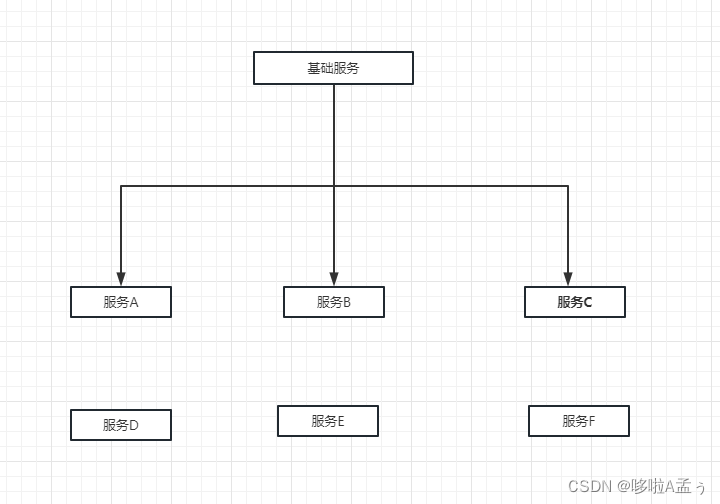
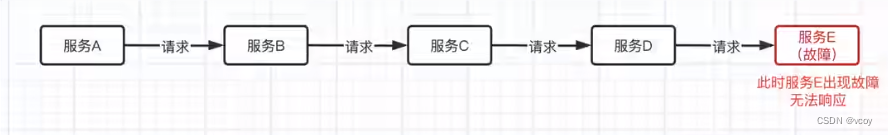
多个微服务之间的调用,结社微服务A调用微服务B和微服务C,微服务B和微服务C有调用其他的微服务,这就是所谓的“扇出”如果扇出的链路上某个微服务的调用响应时间过长或者不可用,对微服务A的调用就会占用越来越多的系统资源,进而引起系统崩溃,所以的 “雪崩效应”
限流: 通过线程池和队列大小限制并发请求。降级: 当命令失败时,返回备用结果。熔断: 当错误率超过阈值时,熔断器打开,直接进入降级逻辑。Hystrix 是一个强大的工具,但需要注意的是,Netflix 已经停止维护 Hystrix,推荐使用 Resilience4j 或 Spring Cloud Circuit Breaker 作为替代方案。如果你有更多问题,欢迎继续提问!
熔断是被动的故障防御机制,而降级是主动的系统保护策略。两者结合使用可以更好地应对系统中的各种异常情况。
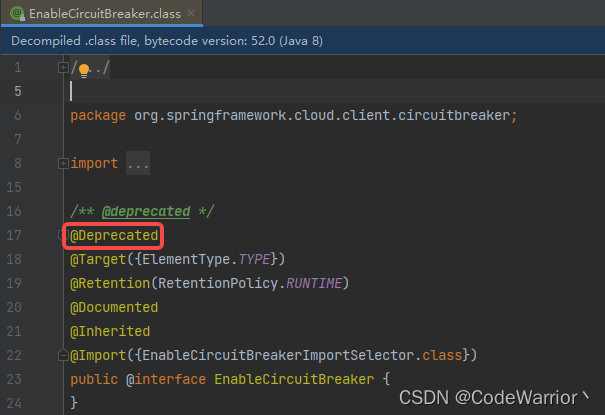
在启动类中加入注解@EnableCircuitBreaker和@EnableHystrix。因为这是单个api接口的回退方法所以。
写完后,关闭对应服务,发现并没有出现所谓的服务降级后自己所更改的页面,反而是404报错,原因是缺少相关的配置类。
随着微服务的流行,以及一些大型系统的诞生,会使项目产生更多的微服务,服务与服务之间的调用也越发频繁,服务之间的稳定性也就愈发重要,限流降级是保护服务稳定利器,我们熟知的限流组件有 Hystrix 和 Sentinel,Sentinel 是阿里中间件团队开源的,面向分布式服务架构的轻量级高可用流量控制组件,主要以流量为切入点,从流量控制、熔断降级、系统负载保护等多个维度来帮助用户保护服务的稳定性。如
Hystrix和Sentinel都是优秀的限流和熔断框架,它们各有特点和优势。如果需要服务间的容错保护,Hystrix是一个不错的选择。Hystrix和Sentinel是两种流行的实现限流和熔断的框架,它们在Java后端系统中有着广泛的应用。Hystrix是一个由Netflix开源的容错库,它通过熔断机制来防止服务间的级联故障。:Hystrix适用于服务间调用的熔断,Sentinel适用于更广泛的
面试是跳槽涨薪最直接有效的方式,马上金九银十来了,各位做好面试造飞机,工作拧螺丝的准备了吗?掌握了这些知识点,面试时在候选人中又可以夺目不少,暴击9999点。机会都是留给有准备的人,只有充足的准备,才可能让自己可以在候选人中脱颖而出。机,工作拧螺丝的准备了吗?掌握了这些知识点,面试时在候选人中又可以夺目不少,暴击9999点。机会都是留给有准备的人,只有充足的准备,才可能让自己可以在候选人中脱颖而出
本文将介绍在使用高版本Spring Cloud(2020.0.x及以后),由于取消了Hystrix的集成,导致OpenFeign与Hystrix熔断降级不生效的问题。同时,也将给出解决该问题的方案,即添加feign.circuitbreaker.enabled=true配置。
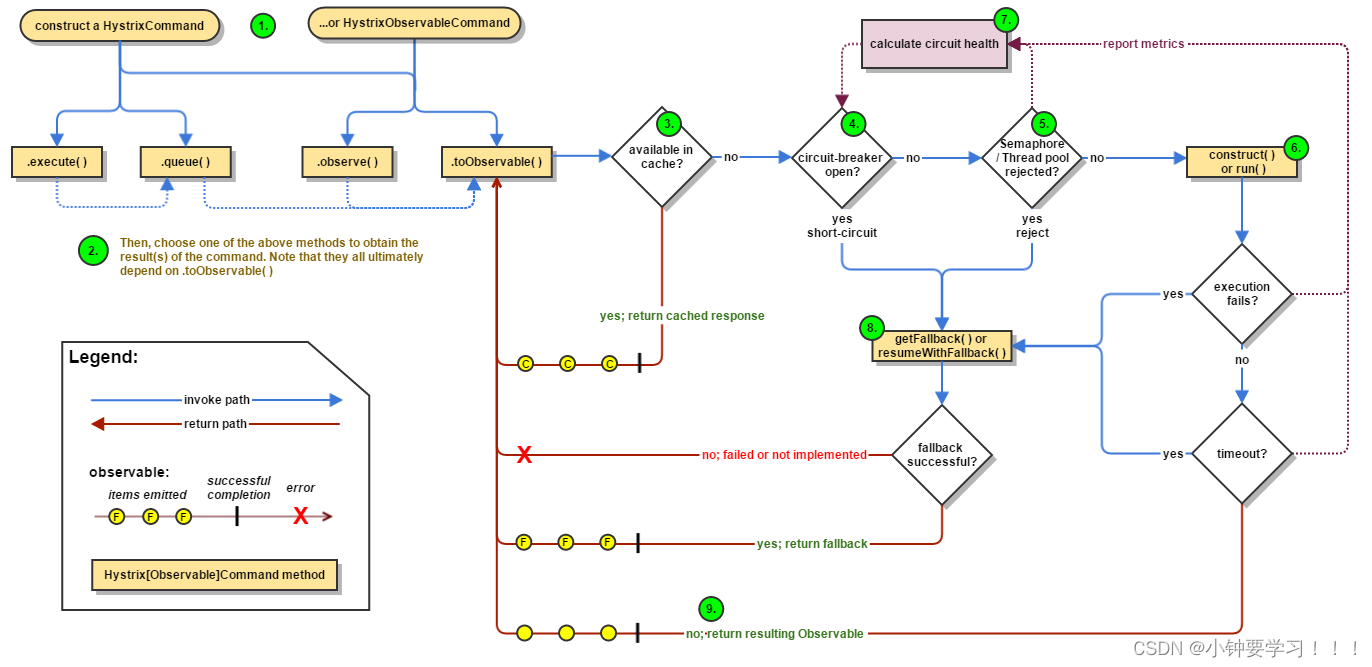
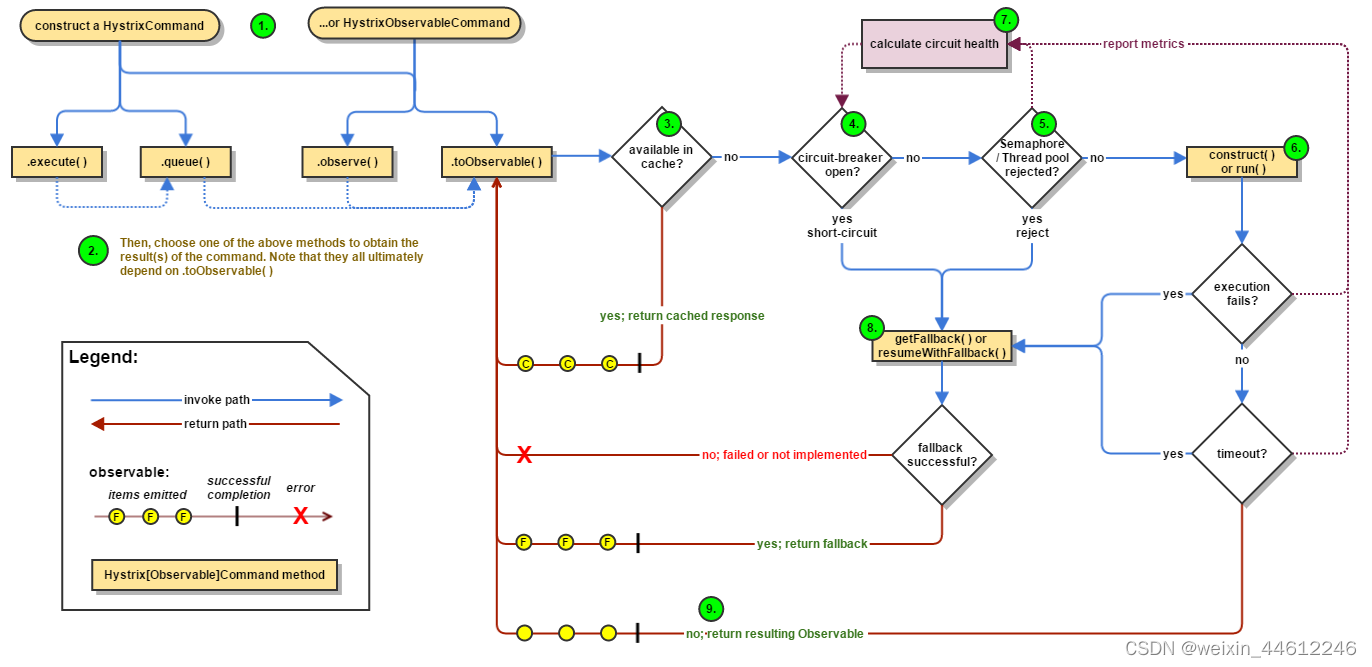
先附上Hystrix源码图在微服务架构中,根据业务来拆分成一个个的服务,服务与服务之间可以相互调用(RPC),在Spring Cloud可以用RestTemplate+Ribbon和Feign来调用。为了保证其高可用,单个服务通常会集群部署。由于网络原因或者自身的原因,服务并不能保证100%可用,如果单个服务出现问题,调用这个服务就会出现线程阻塞,此时若有大量的请求涌入,Servlet容器的线
hystrix
Hystrix是由Netflix开源的一个延迟和容错库,用于隔离访问远程系统、服务或者第三方库,防止级联失败,从而提升系统的可用性与容错性。Hystrix主要通过以下几点实现延迟和容错。包裹请求:使用HystrixCommand包裹对依赖的调用逻辑,每个命令在独立线程中执行。这使用 了设计模式中的“命令模式”。跳闸机制:当某服务的错误率超过一定的阈值时,Hystrix可以自动或手动跳闸,停止请求该
同样建议创建一个公共的feign-api直接调用。建议创建一个公共的feign-api直接调用。
默认为20,意味着在10秒内,如果该hystrix命令的调用次数不够20次,即使所有的请求都超时或者其他原因失败,断路器都不会打开。错误百分比阀值:当请求总数在快照时间窗口内超过了阀值,比如发生了30次调用,如果在30次调用中有15次异常,也就是超过50%的错误百分比,在默认设定50%阀值的情况下,这时候断路器就会打开。当开启断路器的时候,所有请求都不会进行转发,一段时间后(默认是5秒),这时候断
Hystrix降级、熔断、超时配置优化
spring cloud微服务技术之Feign消费和Hystrix熔断。Feign消费也是微服务中最重要的技术之一,其可以通过本地调用接口的方式调用远程的服务接口,同时配以Hystrix进行熔断处理,无论是从理论还是技术实现,都需要形象的理解和实战的体会。这里从通俗的方法理解理论,并且从基本的实现方法实现Feign消费和Hystrix熔断的使用。
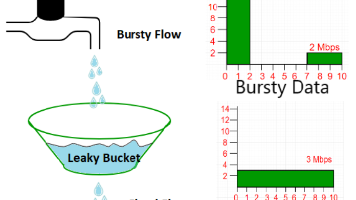
3.如何去上报这些事件,包括成功的失败的?1.熔断器何时开启,如何开启?4.如何对这些上报事件进行处理。5.令牌的逻辑是什么?2.熔断器何时关闭?
消费者配置文件中开启熔断机制。
熔断机制是应对雪崩效应的一种微服务链路保护机制。当扇出链路的某个微服务出错不可用或者响应时间太长时,会进行服务的降级,进而熔断该节点微服务的调用,快速返回错误的响应信息。当检测到该节点微服务调用响应正常后,恢复调用链路。在Spring Cloud框架里,熔断机制通过Hystrix实现。Hystrix会监控微服务间调用的状况,当失败的调用到一定阈值,缺省是5秒内20次调用失败,就会启动熔断机制。熔断
Hystrix一、什么是 HystrixHystrix是一个用于处理分布式系统的延迟和容错的开源库,在分布式系统里,许多依赖不可避免的会调用失败,比如超时、异常等,Hystrix能够保证在一个依赖出问题的情况下,不会导致整体服务失败,避免级联故障,以提高分布式系统的弹性。Hystrix 能够提供服务降级、服务熔断、服务限流、接近实时的监控等方面的功能。二、服务降级、服务熔断、服务限流的实现1、服务
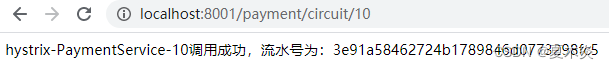
服务熔断Hystrix-3(服务消费者Hystrix测试)hystrix 默认超过时间是1000毫秒,如果你后端的响应时间超过此时间,就会触发断路器。测试环境 2个提供者 1个消费者 一个注册中心1.修改hystrix 默认的超时时间: 3秒我这里修改的@RequestMapping("/web/hystrix")//加入熔断器注解 对这个方法// fallbackMethod 如果出现短路 就返
服务雪崩如图-1,如果所有服务A/B/C网络/应用等都正常,同时能够快速的处理请求并返回,服务之间就可以正常的调度。如图-2,如果A服务出现异常情况(网络异常/内部数据库异常等)无法在指定的时间内返回B服务结果,那么由于C服务会持续的请求B服务,最终导致B服务积压了大量的请求而服务器奔溃不可用。如图-3,B服务由于A服务的不可用导致自身请求积压而崩溃,所以所...
前言hystrix是netflix开源的服务熔断组件,在Spring Cloud中整合进来,形成Spring Cloud的熔断降级体系。服务降级主要是为了服务雪崩,造成下游的服务不可用,可用性是分布式服务的必须要求。1. ribbon服务在上一章的ribbon服务,仅需添加netflix的组件,加入注解即可,下面来改造ribbon-consumer项目,熔断是服务调用方执行。pom...
两者核心差异体现在通信协议、服务发现机制、序列化方式和生态集成四个维度,这些差异直接影响了它们在不同业务场景下的适用性。
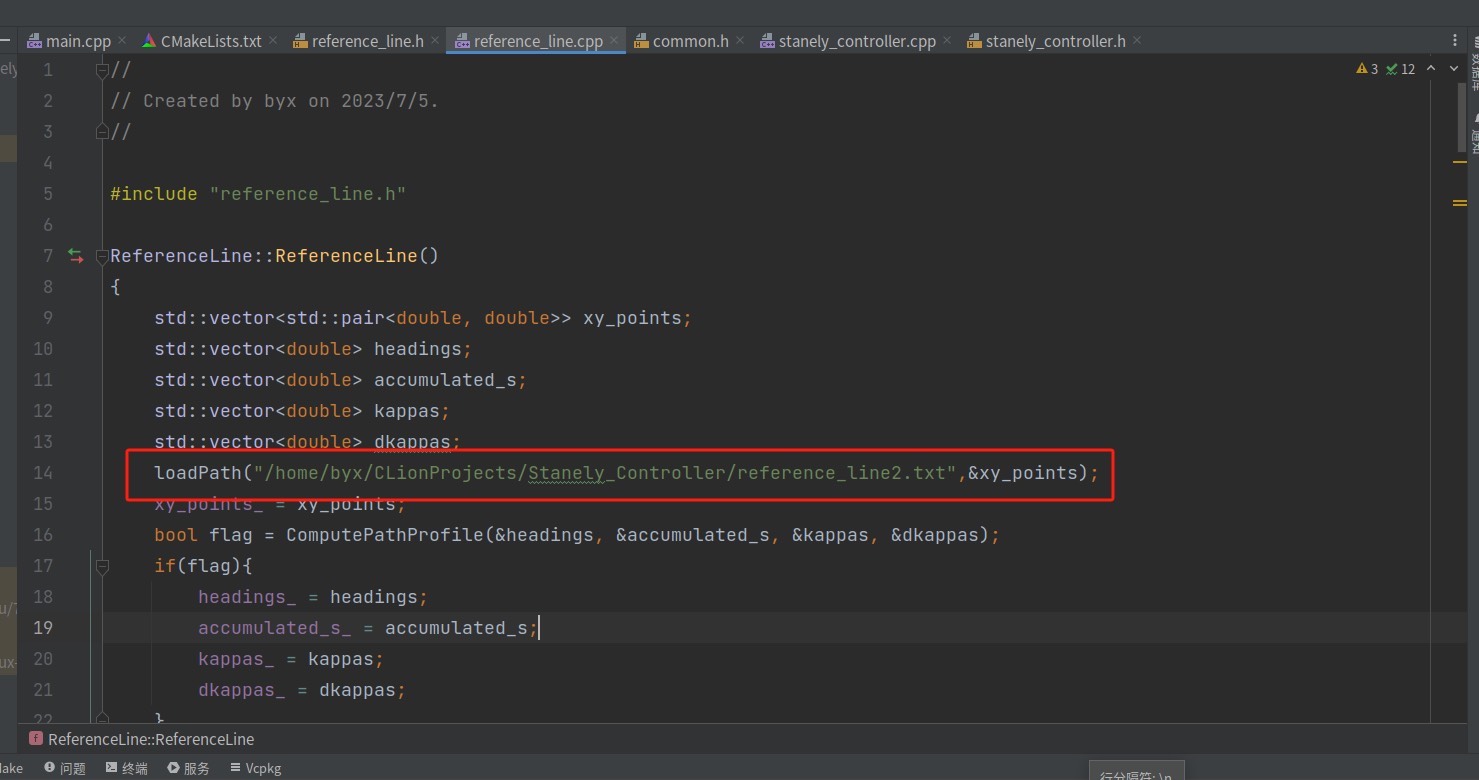
咱们用C++手撕斯坦利算法,先看效果:车能跟着双移线轨迹蛇皮走位,误差控制在0.1米内。通过C++程序实现的路径跟踪仿真,可视化绘图需要安装matplotlibcpp库,已经提前安装好包含在头文件,文件内也含有安装教程。高速场景k=0.1更稳。重点在k参数,这货控制着预瞄距离,后边调参时能玩出花来。可以自定义路径进行跟踪,只需有路径的X Y坐标即可,替换下图中框框标出来的地方路径就可以了。这算法妙
——hystrix
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 乐奇 Rokid 开放社区










 天工造物局