登录社区云,与社区用户共同成长
邀请您加入社区
做了7年Go后端,日常工作就是写接口、调数据库、做微服务、处理并发、线上问题排查。最近明显感受到行业变化:很多基础业务代码,现在大模型可以直接生成。单纯写 CRUD 接口的岗位需求在收缩,但AI 应用工程师的缺口在持续放大。薪资普遍 15‑40k,核心做 RAG、Agent、大模型业务落地。很多人会有误区:转 AI 就要去学深度学习、啃高数、研究 Transformer 源码。但对后端工程师来说,
浙江省建设厅征集了41个住建领域“人工智能+”重点应用场景项目,覆盖设计、审查、造价、建造、城市安全、民生服务等全业务。项目强调技术落地实效,推动大模型、BIM等技术融入实战。具体应用包括智能问答服务、施工图智能审查、工程智能辅助设计、智能家装设计、智能工程造价、城市生命线安全智能预警、公积金智能服务、城建档案智能管理、智慧城市管理、农房农污设施智能管理、智能建筑施工、施工安全智能监管、建筑能效智
基于YOLOv8与DeepSeek的皮肤病图像检测与诊断建议生成系统开发。基于YOLOv8与DeepSeek的皮肤病图像检测与诊断建议生成系统开发。基于YOLOv5的学生行为学生动态检测与数据看板系统设计与实现。基于YOLOv5的学生行为学生动态检测与数据看板系统设计与实现。基于移动端拍照与 YOLOv11 的车辆违停系统的设计与实现。基于YOLOv8深度学习的人脸面部口罩检测系统的设计与实现。基
本文设计基于STM32F103C8T6的地温监测与报送系统,集成DHT11温感、ESP8266无线传输、OLED显示及MQTT云端上报功能,实现土壤温度实时采集、本地显示、阈值报警与远程监控。系统支持太阳能供电,具备低功耗、易部署特点,适用于精准农业场景,为嵌入式与物联网教学提供可复刻的工程范例。
本文为前端零基础转大模型的程序员提供了一套真实可落地、普通人能吃透的90天转行上岸路线。文章分析了前端转AI的天然优势和必须补齐的短板,并详细规划了90天的阶段性精准学习路线,包括Python数据基础、深度学习底层核心、Transformer、LoRA单卡微调实战、简历刚需项目落地、面试冲刺刷题复盘等。最后总结了转行核心总结,强调重工程、重落地、重项目细节、精准对标岗位需求的重要性。给所有前端零基
聚焦大模型应用开发,普通人也能抓住AI时代红利。该领域门槛低、需求旺、落地强,零基础者可通过系统规划入行。关键路径包括:掌握Python、学习实战课程、调用开源模型、深耕垂直场景、积累作品集,并借助社区与政策资源。避免唯算法论和数据迷信,坚持长期学习,即可实现逆袭。
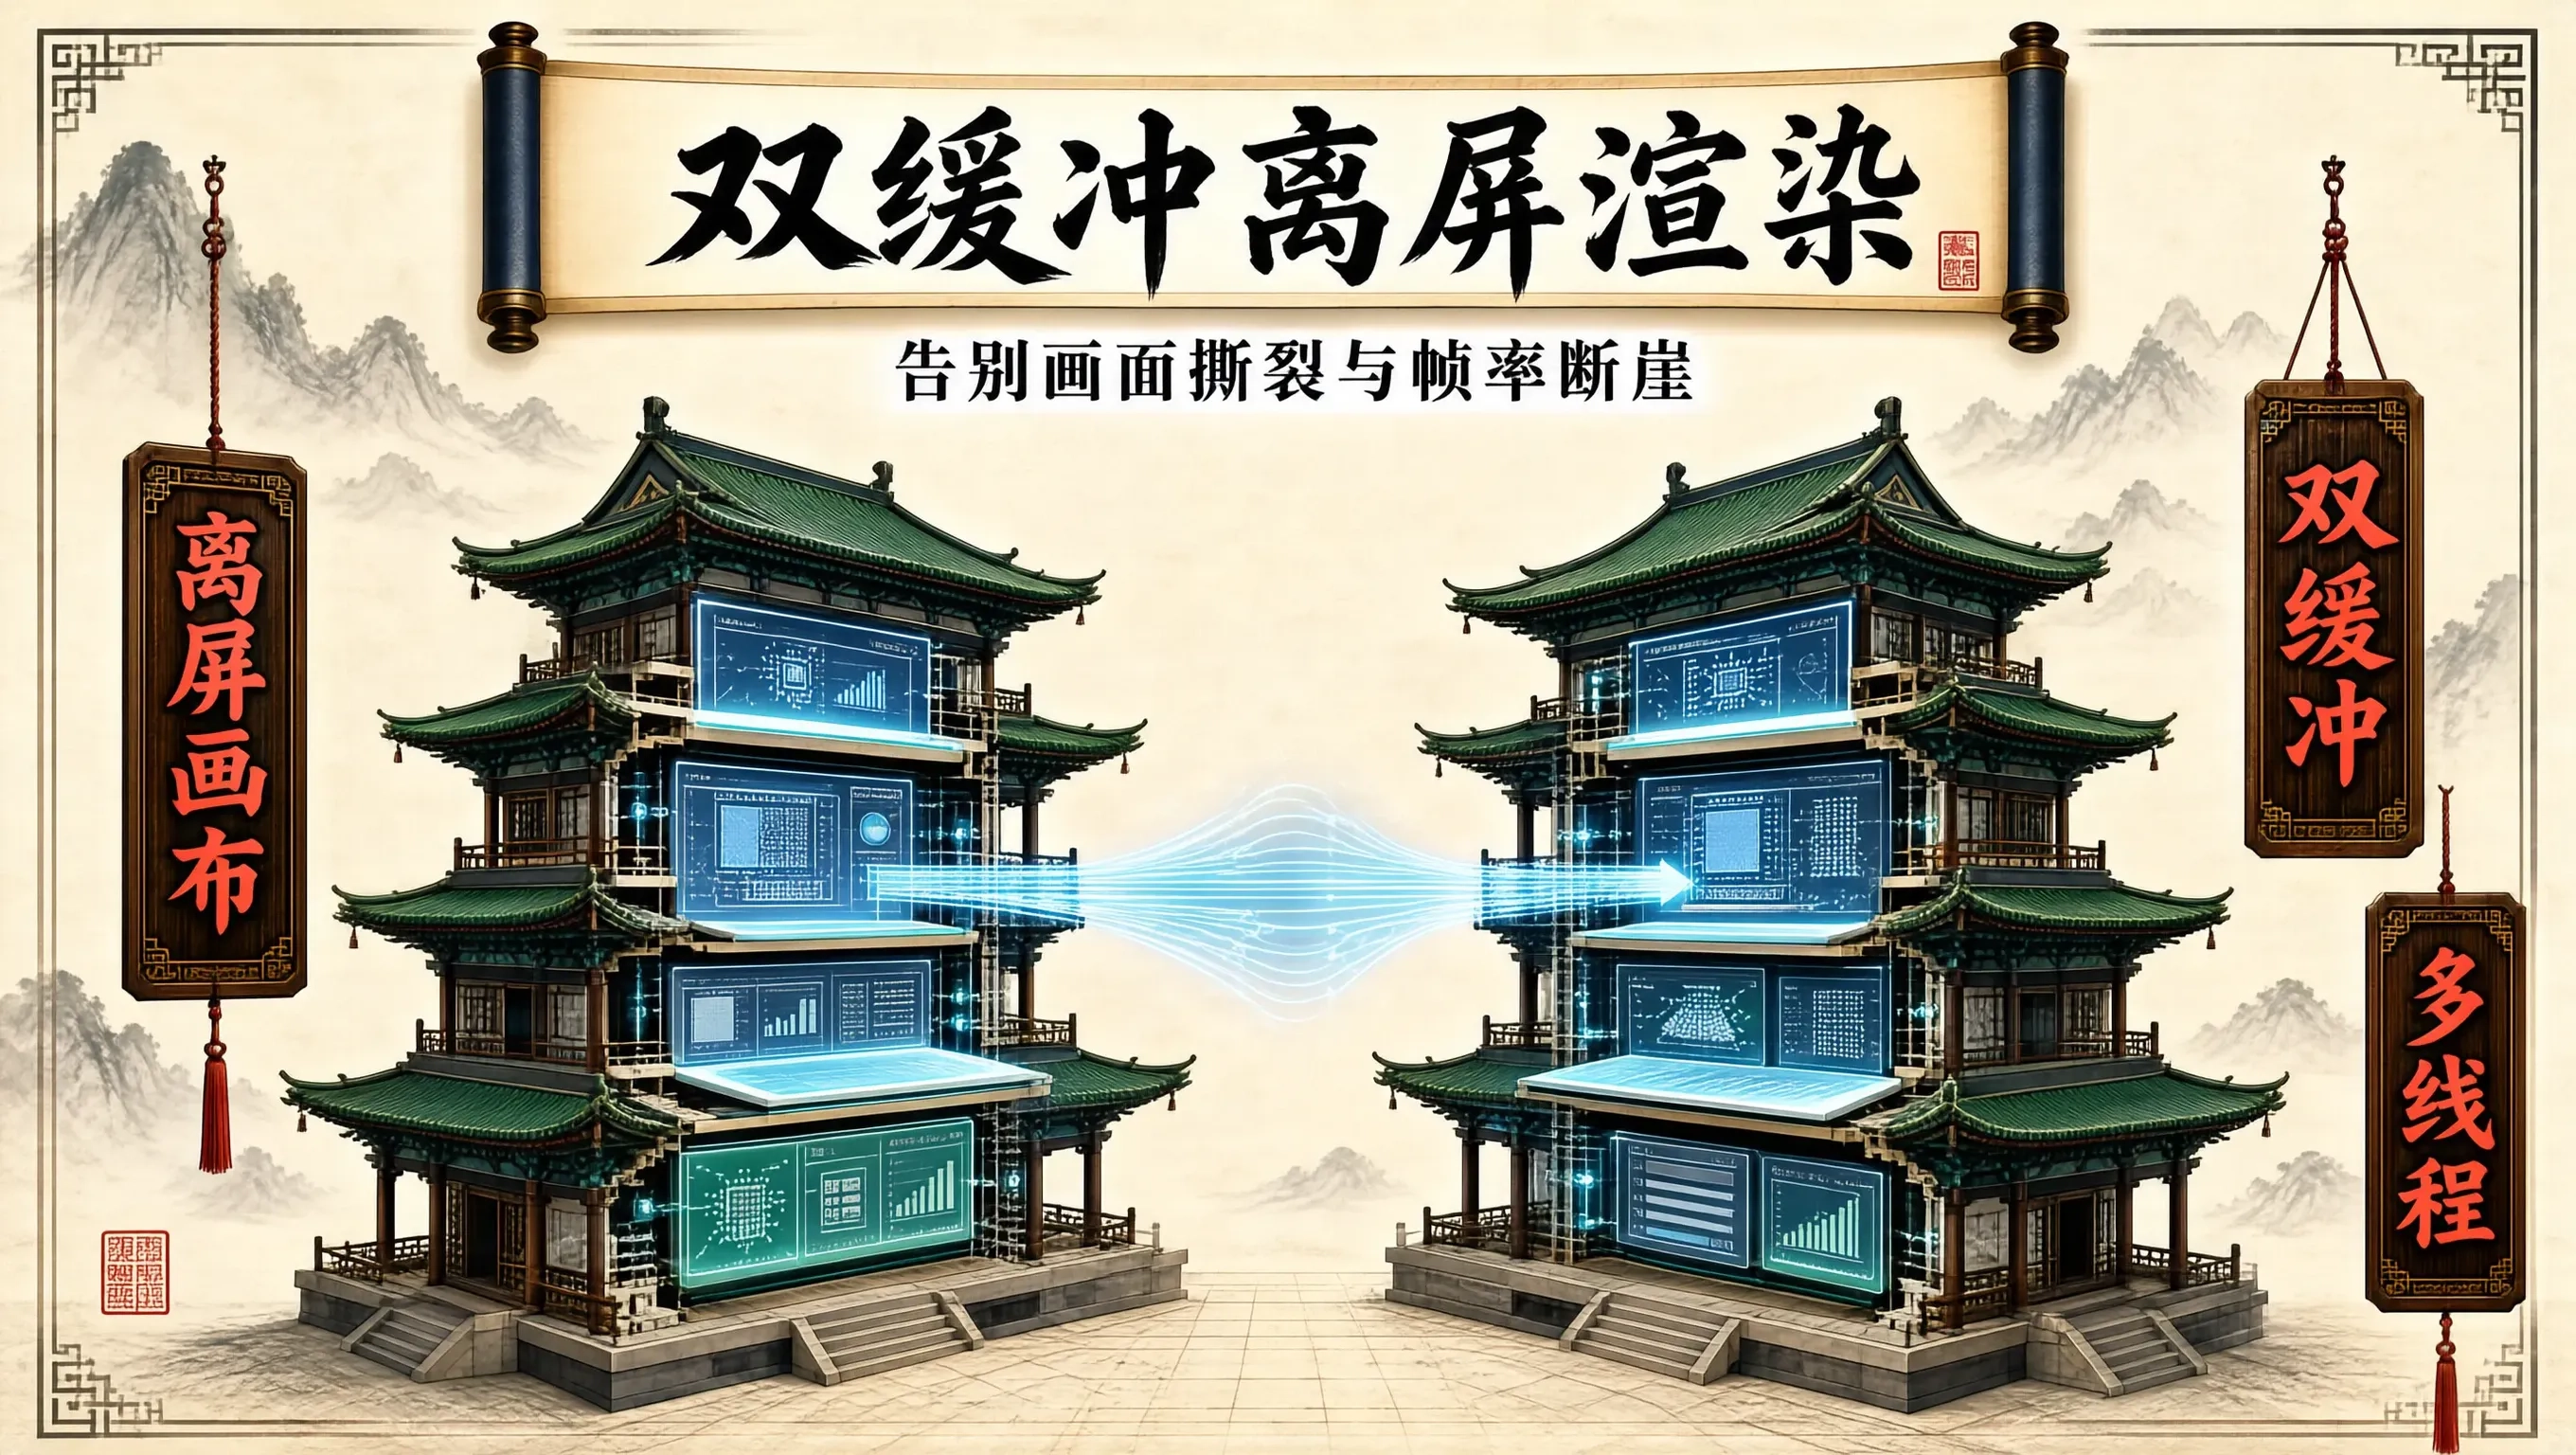
在构建高频金融 K 线图、工业物联网实时监控拓扑或超万点散点图时,Canvas 2D 经常会面临两大性能瓶颈:绘制过程中的画面撕裂与闪烁,以及高频重绘带来的主线程帧率断崖式下跌。许多团队在做 Canvas 性能优化时,往往只把精力放在减少 API 调用次数上,却忽视了画布背后的显存提交时机与渲染管线。合理运用,是让前端 2D 渲染突破瓶颈的关键招式。
本文详细介绍了AI大模型开发的完整学习路线,分为两条路径:零基础应用开发和计算机科班底层算法。应用路线涵盖Python基础、大模型概念、向量数据库、RAG检索、Agent智能体、模型微调、部署工程化及多模态拓展等阶段,适合初学者入门;底层算法路线在应用路线基础上增加深度学习数学、框架、Transformer原理、分布式训练、模型对齐等高级内容,适合有志于从事底层研发的同学。文章还提供了学习周期参考
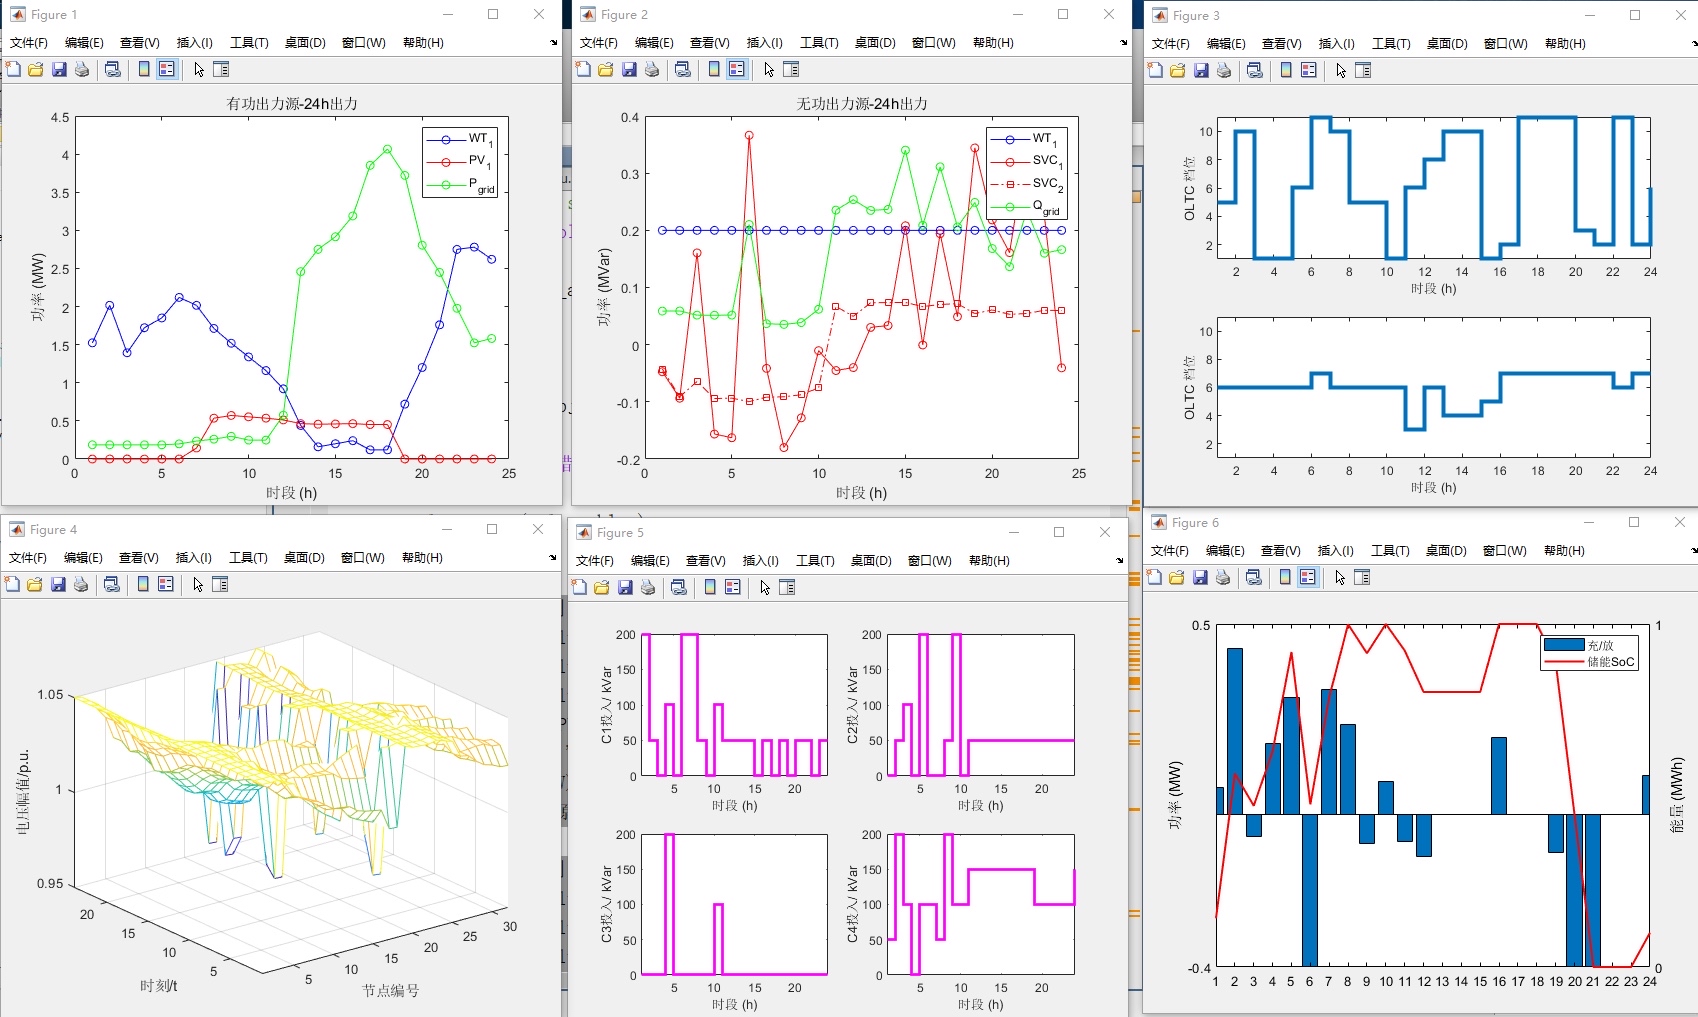
本代码基于二阶锥松弛化技术,构建了考虑储能系统(ESS)、有载调压分接头(OLTC)、离散电容器(CB)及静止无功补偿器(SVC)等多元设备约束的配电网24小时无功优化模型。通过多目标优化(购电成本最小化、网损最小化、电压偏差最小化),实现配电网运行状态的精细化调控,同时满足潮流平衡、设备运行边界、电压质量等约束条件,适用于含新能源(风电、光伏)接入的现代配电网调度决策场景。功率流变量。
直接拿走,意外获得200多套代码,需要的滴我springcloud微服务车联网位置信息管理软件信息管理系统源码-SpringBoot后端+Vue前端+MySQL【可直接运行】(可提供说明文档(通过*AIGC*)
Kettle简介 Kettle是一款国外开源的ETL工具,纯Java编写,可以在Window、Linux、Unix上运行,绿色无需安装,数据抽取高效稳定WebSpoon是Kettle的Web版本,由Kettle社区维护,不受Pentaho支持,实现了Kettle的大部分功能。
这个框架并没有创造一套全新的技术,而是把 ASP.NET Core、EF Core、Blazor SSR / Razor Pages、Vite、Tailwind、认证、队列、定时任务、CLI 这些东西,用「约定优于配置」的方式预装、整合、规范化。很多 .NET 项目天然偏企业级、偏分层、偏重型,而 Spark.NET 的气质更像 Laravel、Rails、Django:先把认证、邮件、日志、事件
大模型学习是一个长期积累的过程,没有捷径可走,不必因为一时的困难而放弃。2026年,大模型的落地场景持续拓宽,无论是技术岗位还是非技术岗位,掌握大模型相关能力都能提升自身竞争力。遵循本文的学习路线,从基础筑基到实战落地,循序渐进,避开误区,坚持“理论+实战”,你会发现大模型学习并没有想象中那么难。愿每一位学习者都能在大模型的浪潮中,找到自己的定位,实现能力跃迁,抓住时代赋予的机遇。
本文介绍了一个基于Python和大数据技术的京东消费者行为分析与可视化系统。该系统采用Django框架开发,通过爬虫采集京东平台的商品数据,实现了护肤品和男士化妆品信息管理、营销策略分析等功能。系统核心功能包括数据抓取、清洗、存储和可视化展示,利用Hadoop处理海量数据,通过Echarts生成商品价格、评论量、地域分布等多维度可视化图表。后台管理系统支持信息的增删改查操作,并采用数据加密保障安全
摘要: 本研究设计并实现了一个基于深度学习的饮食计划推荐平台,旨在解决传统通用饮食建议难以满足个性化健康需求的痛点。系统采用SpringBoot+Vue技术架构,后端基于Java语言与SpringBoot框架构建,前端使用Vue框架开发交互界面,数据存储采用MySQL数据库。核心算法方面,运用随机森林分类实现食物类别预测,结合协同过滤算法生成个性化饮食推荐。平台具备饮食计划制定、健康目标管理、营养
本文概述文章目标、核心观点和实践价值。很多人以为前端转 AI 就是调个 API,其实这是个巨大的误区。我在面试和带团队的过程中发现,纯后端背景的同学往往对“交互细节”不够敏感,而纯前端同学如果只盯着 UI 做适配,又容易被贴上“只是画皮”的标签。你能否用前端的技术栈,把大模型那种“非确定性、高延迟、流式”的特性,封装成确定性的用户体验。今天我不谈枯燥的原理,直接从面试中最常问的“项目难点”和实际开
本文摘要:本研究设计并实现了一套基于Hadoop的体检数据分析系统,旨在解决传统人工处理体检数据效率低下、误差率高的问题。系统采用SpringBoot+Hadoop+Vue的技术架构,实现体检数据的分布式存储、智能分析和可视化展示。通过线性回归算法挖掘指标关联规律,系统具备体检报告自动生成、健康趋势预测等功能,有效提升了健康风险评估的精准度。测试表明,该系统显著提高了体检数据处理效率,为医疗机构和
这篇面向对未来职业方向焦虑的程序员,但不会把“程序员职业规划:大模型时代如何重新设计路线,用业务场景检验技术取舍”写成概念清单。我会按清醒、实用的职业规划文章的思路,把它放到真实开发、学习路线和求职准备里看,顺便讲几个容易忽略的取舍。这次我会从“从初学者转型路线切入,重点写学习顺序和误区”展开,换一组场景和例子来讲。回到“程序员职业规划:大模型时代如何重新设计路线,用业务场景检验技术取舍”这个主题
这篇面向想进入 AI 应用方向的前端开发者,但不会把“前端转大模型:页面开发到 AI 产品工程师,用排错清单压住复杂度”写成概念清单。我会按产品化视角的实战教程的思路,把它放到真实开发、学习路线和求职准备里看,顺便讲几个容易忽略的取舍。这次我会从“从求职作品集角度切入,重点写可展示成果”展开,换一组场景和例子来讲。回到“前端转大模型:页面开发到 AI 产品工程师,用排错清单压住复杂度”这个主题,最
这篇面向想进入 AI 应用方向的前端开发者,但不会把“前端转大模型:页面开发到 AI 产品工程师,从问题拆解到交付验证”写成概念清单。我会按产品化视角的实战教程的思路,把它放到真实开发、学习路线和求职准备里看,顺便讲几个容易忽略的取舍。这次我会从“从求职作品集角度切入,重点写可展示成果”展开,换一组场景和例子来讲。回到“前端转大模型:页面开发到 AI 产品工程师,从问题拆解到交付验证”这个主题,最
最近两年互联网招人逻辑完全换了赛道:只会写基础业务代码、天天做CRUD的传统开发岗位越来越少,能落地AI大模型、帮公司做业务智能化的技术人,成了各大大厂抢着要的香饽饽。2026年春招市场,大模型相关岗位直接稳居招聘第一位!AI相关岗位数量同比暴涨8.7倍,在所有新经济岗位里占比从2.78%飙升到22.03%,简单说:10个技术岗,2个都是AI大模型岗。头部大厂2026春招全员押注AI,传统岗位持续
你把一个跨订单、库存、支付的 user story 丢给 Agent。它改得很快,PR 也像模像样,但只看了订单服务,没发现库存事件的字段约定已经变了。联调一跑,链路炸在最不起眼的接口边界上。这是跨微服务用 Agent 最容易踩的坑:不是模型不会写代码,而是它没有服务地图,也没有一条能在本地跑起来的契约验证线。把所有仓库放进一个 workspace 有用,但只能解决“看得到代码”。要让 Agent
技术路线规划:基于行业发展趋势和个人技术背景,制定差异化的技术成长路径 架构设计咨询:运用企业级开发标准,指导构建高可用、可扩展的系统架构。灵活的渐进式设计:可从简单的视图层库扩展至完整的SPA解决方案 丰富的生态系统:Vue Router、Vuex/Pinia、Vue。响应式数据流:基于依赖追踪的响应式系统,实现高效的视图更新 组件化架构:单文件组件(SFC)设计,实现样式、逻辑、模板的完美封装
直接拿走,意外获得200多套代码,需要的滴我Java Web springcloud微服务车联网位置信息管理软件系统源码-SpringBoot2+Vue3+MyBatis-Plus+MySQL8.0【含文档】(可提供说明文档(通过。在校期间积极参与实验室项目研发,现为CSDN特邀作者、掘金优质创作者。专业毕业设计指导、项目源码开发、技术答疑解惑,用学生视角理解学生需求,提供最贴心的技术帮助。遇见即
Docker Swarm 是docker原生集群管理系统,它将一个Docker主机池变成了一个虚拟主机,只需要使用简单的API就可以实现与Docker集群的通信。从Docker 1.12.0开始,Docker Swarm就内置于Docker引擎中了,不需要单独安装配置。节点架构无标题swarm node从物理上讲,一个swarm 就是若干个安装了Docker的物理机或虚拟机,这些主机上的Docke
AI大模型指参数规模超10亿的深度学习模型,如GPT-3(1750亿参数)等。其核心突破包括参数量的指数级增长、上下文学习能力和多模态融合。从2012年AlexNet到2023年LLaMA 2开源,大模型经历了十年技术演进。关键技术特征遵循"模型效果∝参数规模×数据量×计算量"的定律,依赖Transformer架构的注意力机制等组件。目前已在编程辅助(如GitHub Copilot)、工业质检等领
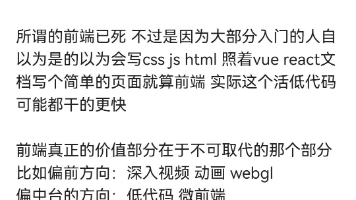
文章摘要: 近期“前端已死”的讨论引发行业热议,但从2026年视角看,前端行业并未消亡,而是面临技术迭代与AI冲击的转型期。前端技术边界不断拓宽,但市场岗位缩减,供需失衡加剧。AI工具已能替代基础编码工作,企业更青睐掌握AI的全栈开发者。从业者需深耕高门槛技术领域(如WebGL、Node服务等),同时拥抱AI工具提升效率,强化业务思维。新人建议转向大模型应用等新兴赛道,抓住AI红利期。行业淘汰的是
先把这篇文章的目标说清楚:看完之后,你应该能判断这件事值不值得做,以及从哪里动手。前阵子我在重构一个内部的智能客服 Demo 时,遇到了一件挺有意思的事。原本以为前端转做大模型应用,难点在于怎么调 API、怎么写 Prompt,或者搞懂 LangChain 那些复杂的链式调用。结果代码跑通了,对话也流畅,但在测试环境里一切正常,一旦接入真实的权限体系和操作日志,整个系统的稳定性就开始崩塌。这给我上
如果说程序员已经是高薪职业,那么干AI的程序员,就是高薪中的高薪。学AI大模型,就是冲刺高薪的最优解!零基础小白不知道从哪入门?有基础的程序员找不到系统学习路径?实战项目练手无门?面试不知道考什么?别慌!今天就给大家整理了一份【2026年最新版】AI大模型免费学习资源包,覆盖从入门到实战、从理论到面试、从基础到进阶的全流程,所有资料均已整理归档,无冗余、无套路,免费分享给每一位想抓住AI风口的程序
先把这篇文章的目标说清楚:看完之后,你应该能判断这件事值不值得做,以及从哪里动手。之前我写了几篇关于 LangGraph 和 Agent 工作流的文章,评论区不少前端同学问我:“JS 不都能写吗?为什么你们后端/算法都在卷那个,我们是不是也能直接切入?我的回答一直很直接:能切入,但如果你只盯着 API 调用和页面渲染,你大概率会死得很惨。
os.environ[“OPENAI_API_KEY”] = “ollama”# Ollama 不校验,填任意值。os.environ[“OPENAI_API_KEY”] = “ollama”# Ollama 不校验,填任意值。“model”: “nomic-embed-text”,# 嵌入模型。“model”: “nomic-embed-text”,# 嵌入模型。“model”: “llama3